用声学掩蔽量化辅音对词语可懂度的贡献
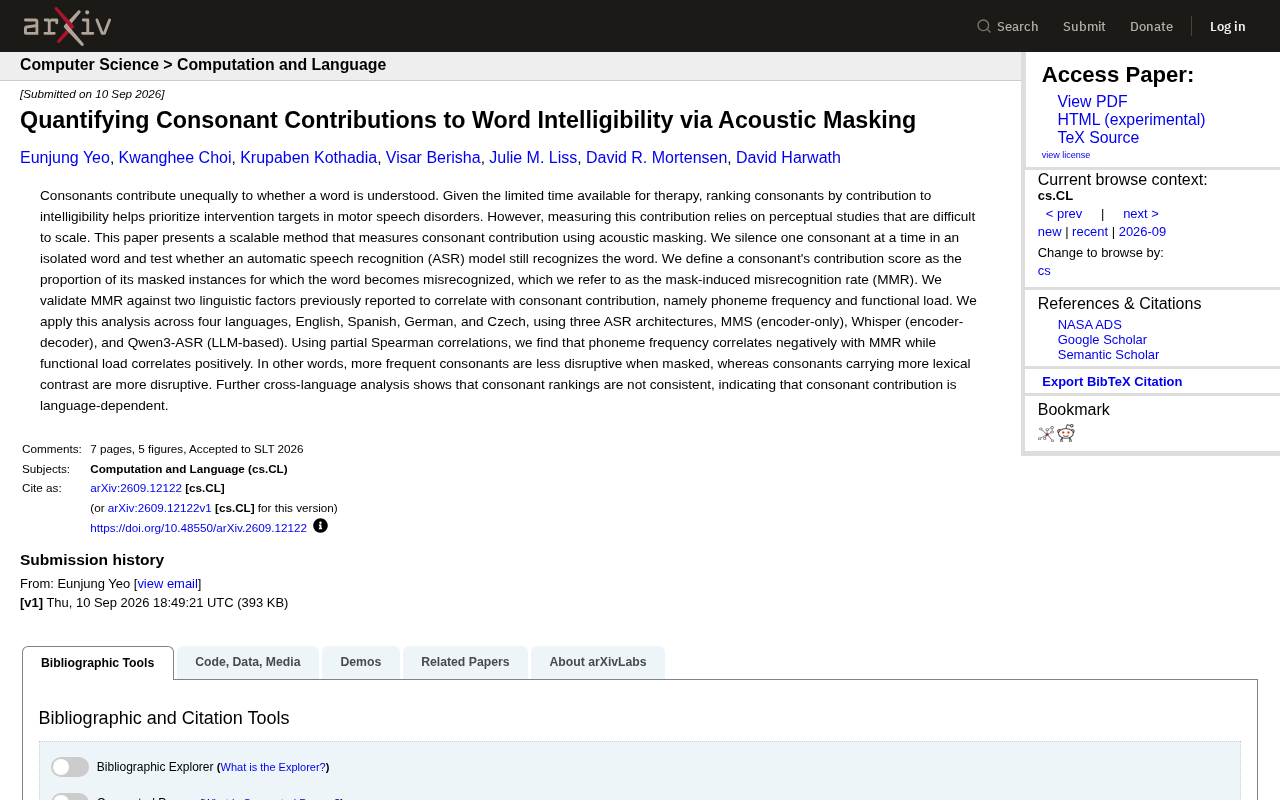
用声学掩蔽配合ASR模型自动量化辅音对词语可懂度的贡献,并验证其跨语言差异性。
这篇arXiv论文针对运动性言语障碍康复中「优先治疗哪些辅音」这一临床问题,提出了一种可扩展的自动化量化方法。核心思路是将词语中的某个辅音静音掩蔽,观察ASR模型是否仍能正确识别,由此定义「掩蔽诱导误识率(MMR)」作为辅音贡献的代理指标。研究在英语、西班牙语、德语、捷克语四种语言及MMS、Whisper、Qwen3-ASR三类架构上进行了验证,发现MMR与音素频率负相关、与功能负载正相关,符合语言学直觉。最重要的跨语言发现是:辅音贡献的排序在不同语言间并不一致,不存在通用的优先级清单。该方法以机器识别替代真人感知实验,大幅降低规模化分析的成本,但MMR与真人感知的对齐程度仍是后续需要验证的关键问题。
一个被临床忽视的问题:哪些辅音最该被治疗
在运动性言语障碍(motor speech disorders)的康复治疗中,时间永远是稀缺资源。治疗师需要在有限的疗程内决定优先纠正哪些发音,而不同辅音对于一个词能否被听懂的贡献并不均等——有些辅音一旦发不清楚,整个词就无法辨认;有些则即便含糊也不影响理解。
如果能给辅音按「对可懂度的贡献」排序,就能帮助临床决策把有限资源投向最关键的干预目标。问题在于,传统衡量这种贡献的方法依赖人耳感知实验,成本高、难以规模化,无法覆盖多语言、多场景的需求。
一篇新发布于 arXiv 的论文(arXiv:2609.12122)提出了一种可扩展的替代方案:用声学掩蔽(acoustic masking)配合自动语音识别(ASR)模型,来自动量化每个辅音的贡献度。
核心方法:掩蔽一个辅音,看模型还认不认得
该研究的思路直接而巧妙。研究者取一个孤立的词,每次静音(silence)掉其中一个辅音,然后测试 ASR 模型是否还能正确识别这个词。
由此定义出一个关键指标——掩蔽诱导误识率(Mask-Induced Misrecognition Rate, MMR):某个辅音被掩蔽后导致词语被错误识别的实例比例。MMR 越高,说明这个辅音对词语被听懂的贡献越大;反之,掩蔽它几乎不影响识别,则说明其贡献较小。
这种方法的最大价值在于「可扩展」。它把原本需要大量真人参与的感知实验,替换成了可以批量、自动运行的机器识别流程,从而让跨语言、大规模的辅音贡献分析成为可能。
用两个语言学指标做验证
为了证明 MMR 确实测到了「辅音贡献」这个真实语言学量,而不是某种模型伪影,研究者拿它与两个此前被报道过、与辅音贡献相关的语言学因素做了对照:
- 音素频率(phoneme frequency):某个辅音在语言中出现的频繁程度。
- 功能负载(functional load):某个辅音在区分词义上承担的对比作用大小。
通过偏斯皮尔曼相关(partial Spearman correlations)分析,结果显示:音素频率与 MMR 呈负相关,功能负载与 MMR 呈正相关。
换句话说,越常见的辅音被掩蔽时干扰越小,而承载更多词汇对比信息的辅音一旦被掩蔽,破坏性越大。这一结论与语言学直觉高度吻合,也为 MMR 的有效性提供了佐证。
跨语言、跨模型的稳健性检验
研究并没有停留在单一语言或单一模型上,而是把分析扩展到了四种语言与三类 ASR 架构,这也是该工作在方法论上的一个亮点。
四种语言
实验覆盖了英语、西班牙语、德语和捷克语。这四种语言在语音系统上差异明显,能较好地检验方法是否具有普适性。
三类 ASR 架构
为避免结论受特定模型影响,研究选用了三种代表性架构:
- MMS:纯编码器(encoder-only)结构;
- Whisper:编码器-解码器(encoder-decoder)结构;
- Qwen3-ASR:基于大语言模型(LLM-based)的识别系统。
这种组合覆盖了当前语音识别的主流技术路线,使得 MMR 指标的结论不至于绑定在单一建模范式上。
关键发现:辅音贡献是「因语言而异」的
最值得关注的结论来自跨语言分析:辅音的贡献排序在不同语言之间并不一致。也就是说,在英语中最关键的某个辅音,未必在捷克语或西班牙语中同样重要。
这意味着辅音对可懂度的贡献是**语言依赖(language-dependent)**的,不存在一份可以跨语言通用的「辅音优先级清单」。对临床实践而言,这一发现提醒治疗师和研究者:干预目标的选择必须结合具体语言的语音结构,简单照搬其他语言的经验可能失效。
意义与局限
从应用角度看,这项工作提供了一条把 ASR 模型转化为语言学与临床工具的可行路径。相比昂贵的感知实验,基于掩蔽的自动化流程可以快速为不同语言生成辅音贡献排序,理论上能为运动性言语障碍的治疗目标优先级提供数据支撑。
不过也应看到,MMR 本质上衡量的是「机器是否还能识别」,而非「人类听者是否还能听懂」。ASR 模型的识别行为与真人感知之间存在系统性差异,模型对某些声学线索的依赖可能与人耳并不一致。将 MMR 直接用于临床决策之前,仍需要与真人感知结果做更充分的对齐验证。
总体而言,这是一项思路清晰、方法可扩展的研究,为量化语音可懂度提供了新的自动化视角,也为跨语言语音病理学研究打开了新的实验空间。
相关推荐
MIT衍生公司将塑料废料变身高韧性建筑材料
MIT衍生初创公司Atlas Building Composites将塑料废料转化为高韧性建筑与基础设施部件,探索塑料回收的高价值产业化出路。本文解析其技术路径与产业意义。
CCPS采样法:保留推理多样性,无需微调提升LLM表现
arXiv新论文提出Chopthin-Consensus Power Sampling(CCPS),通过保留推理多样性的重采样与语义多数选择机制,在不进行任何训练的情况下提升大语言模型推理准确率,最高绝对增益达10.6个百分点。
HardFlow算法:让生成式AI满足安全关键场景的硬约束
HardFlow是一种新算法,旨在让生成式AI在安全关键场景中严格遵守硬约束条件,同时保持高质量输出。本文解析其核心思路、技术难点与在机器人、工程设计等领域的应用前景。