用WhatsApp与Instagram数据训练个人AI:可行吗?

Reddit开发者设想用WhatsApp与Instagram行为数据代替手写提示词,构建真正懂你的个人AI代理。
一位Reddit开发者提出:既然多年聊天记录和社交数据已经记录了真实的自己,为何还要费力撰写「关于我」的提示词?他的核心洞察是WhatsApp(主动意图)与Instagram(被动偏好)的互补性——两者交叉比对能揭示自述中难以捕捉的隐藏模式。技术上可通过数据导出、RAG记忆层和周期性偏好提炼来实现,但也面临三重风险:他人隐私泄露、社交数据的情境偏差,以及AI过度强化既有认知模式导致的信息茧房。这一设想折射出个人AI从通用助手向深度个性化代理演进的大趋势,关键挑战在于如何在个性化与数据主权之间找到平衡。
一个来自Reddit的设想:让AI读懂真实的你
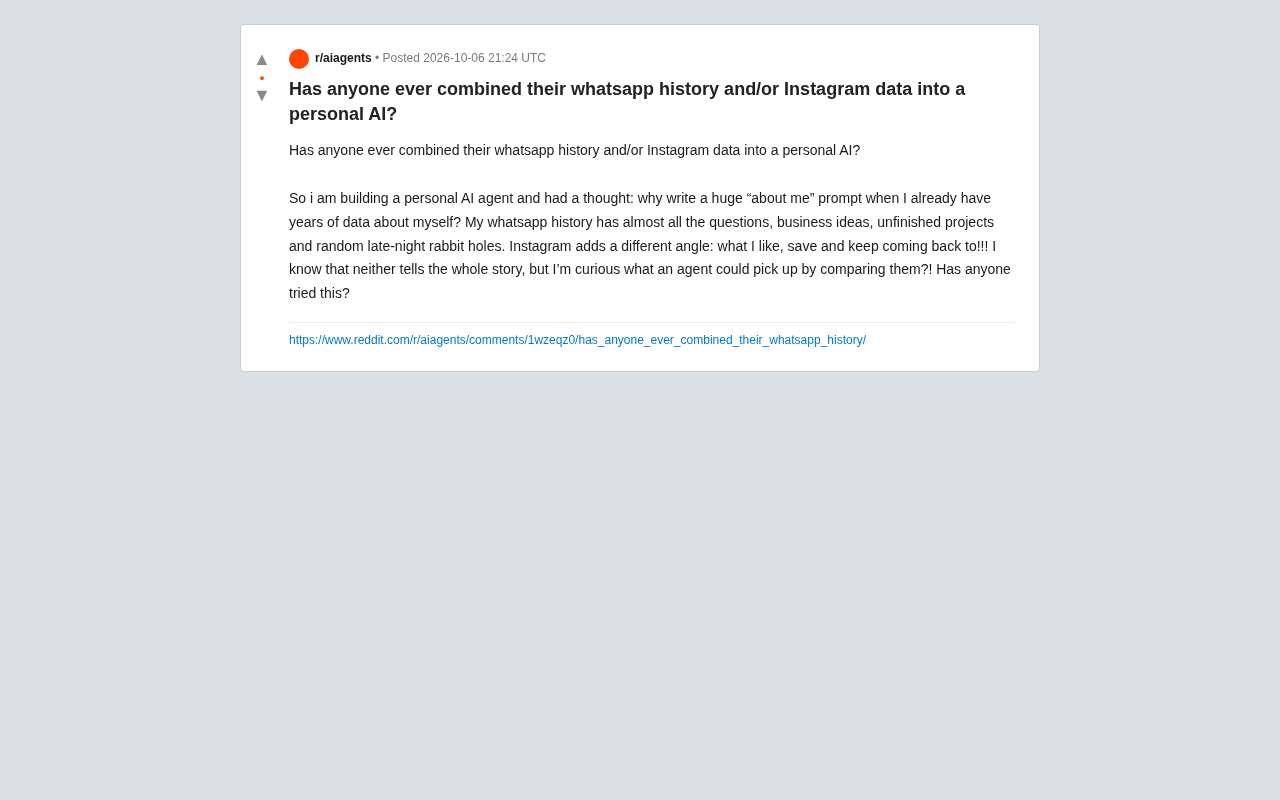
在Reddit上,一位正在搭建个人AI代理(personal AI agent)的开发者抛出了一个有趣的问题:既然自己已经积累了多年的聊天记录和社交数据,为什么还要费力写一长串「关于我」的提示词(prompt)?
他的思路很直接——WhatsApp的历史记录里几乎囊括了他提过的所有问题、冒出来的商业点子、半途而废的项目,以及深夜里那些随性的信息检索。而Instagram则提供了另一个维度:他喜欢什么、收藏了什么、反复回看什么内容。两者单独来看都不完整,但如果让AI把它们放在一起对比分析,或许能捕捉到一些仅凭自我描述难以表达的东西。
这个想法触及了「个人AI」领域一个核心议题:与其手动描述自己,不如让AI从你真实的行为数据中学习你是谁。
为什么行为数据比自述更有价值
人们对自己的描述往往带有理想化色彩。当你写「关于我」的提示词时,你描述的是你想成为的样子,而非真实行为模式。相比之下,聊天记录和社交互动是未经修饰的原始行为痕迹。
这位发帖者的洞察在于识别出了两类数据的互补性:
- WhatsApp(主动表达):承载的是你主动提出的问题、思考过程和未完成的意图。这是「你在想什么」的记录。
- Instagram(被动偏好):反映的是你被什么吸引、愿意保存和重复消费什么内容。这是「你被什么驱动」的信号。
一个AI代理若能交叉比对这两类数据,理论上可以发现自述中容易遗漏的隐藏模式——比如你反复提起某个商业想法却从未行动,或者你收藏的内容与你声称的兴趣之间存在偏差。这种「主动意图」与「被动偏好」之间的张力,恰恰是个人画像中最有价值的部分。
技术上如何实现
从工程角度看,这个设想并非天马行空。实现路径大致可以拆解为几个环节:
数据导出与清洗
WhatsApp支持导出聊天记录为文本文件,Instagram也允许用户下载包含帖子、点赞、收藏的数据包。第一步是将这些原始数据结构化,剥离无关的系统信息和噪声。
构建记忆层
与其把所有数据塞进一个巨型提示词,更现实的做法是建立检索增强生成(RAG)系统。将对话和偏好数据向量化存入数据库,让AI代理在需要时按语义检索相关片段,而非一次性加载全部历史。这样既绕开了上下文窗口的限制,也让AI能动态调取最相关的个人信息。
RAG(检索增强生成,Retrieval-Augmented Generation)是目前解决大模型「记忆有限」问题的主流工程方案。其核心思路是:不把所有信息硬塞进提示词,而是先将文档、对话等数据转化为高维数值向量(embedding),存入专门的向量数据库(如 Chroma、Pinecone、Weaviate)。当用户提问时,系统先将问题也向量化,在数据库中找出语义最相近的片段,再将这些片段连同问题一起送给大模型生成回答。对于个人数据场景,这意味着 AI 每次响应时只需加载与当前对话最相关的历史片段,而非几年的完整记录,既节省算力,又让回答更精准。向量化过程通常依赖嵌入模型(embedding model),如 OpenAI 的 text-embedding-ada-002 或可本地运行的 sentence-transformers,后者在隐私敏感场景下尤为适用。
偏好提炼
更进一步,可以用大模型对历史数据做周期性总结,提炼出稳定的个人特征——反复出现的话题、决策习惯、兴趣演变轨迹。这些提炼结果可以成为AI代理长期记忆的核心。
不容忽视的隐私与边界问题
这个想法虽然诱人,但也伴随显著风险,需要冷静对待。
隐私是首要关切。WhatsApp聊天记录通常包含对话另一方的内容,这些人并未同意自己的信息被用于训练你的AI。将这类数据上传到云端大模型服务,可能意味着把他人的私密对话暴露给第三方。本地化部署(在自己设备上运行模型)是更负责任的方案。
数据偏差同样值得警惕。正如发帖者自己也承认的,「两者都无法讲述完整的故事」。社交数据天然带有情境偏差——你在WhatsApp上的表达方式与现实中的你可能不同,Instagram的算法推荐也在塑造你的「偏好」,这未必是真实的你。基于偏差数据构建的AI,可能会放大而非还原你的真实特征。
过度依赖的风险。当AI太「懂你」,它可能倾向于强化你已有的认知模式,形成信息茧房的个人化版本,反而限制了自我认知的更新。
本地化部署通常指在用户自己的设备或私有服务器上运行开源大模型,典型选择包括 Ollama 框架搭配 LLaMA、Mistral 等模型。与调用 OpenAI、Claude 等云端 API 相比,本地部署的数据全程不离开本机,从根本上规避了第三方获取聊天记录的风险。代价是对硬件有一定要求——运行 7B 参数量的模型通常需要 8GB 以上显存或较新的 Apple Silicon 芯片,能力上也弱于顶级云端模型。对于包含他人隐私的聊天数据,本地部署几乎是唯一负责任的选择;若数据已做充分脱敏处理,则可酌情考虑云端方案以换取更强的模型能力。
这预示着个人AI的发展方向
抛开具体实现,这个Reddit提问折射出一个更大的趋势:个人AI正在从「通用助手」向「深度个性化代理」演进。
未来的个人AI很可能不再依赖用户手动配置,而是从个人数字足迹中持续学习——邮件、日历、聊天记录、浏览历史共同构成一个动态更新的个人模型。关键的技术与伦理挑战在于:如何在实现个性化的同时保障数据主权,让用户真正掌控自己的数据流向。
对于想要尝试的开发者,建议从本地化、小规模的实验起步:先用部分数据验证AI能否提炼出有意义的个人洞察,再逐步扩展,并始终把隐私保护放在首位。这个发帖者提出的问题没有标准答案,但它指向的方向——用真实数据而非理想化描述来定义「我是谁」——很可能是个人AI下一阶段的核心命题。
相关推荐

韩国曝AI智能体疑似被用于攻击银行系统
韩国监管机构警告称,AI智能体疑似被用于攻击该国银行系统。本文分析AI驱动网络攻击的危险性、金融机构面临的新挑战及行业应对方向。

Claude Code创建者为何建议删除配置?上下文工程四大转变解析
Claude Code创建者Boris Cherny建议定期删除配置引发热议。本文拆解这句话的真正含义,解析上下文工程的四大转变:规则改判断标准、示例改接口、前置加载改渐进式披露、善用自动记忆与默认验证,帮你让AI配置与模型迭代并行。

推翻萨达姆只是开始:历史学家沙拉·佩恩拆解伊拉克困局
历史学家沙拉·佩恩深度解析伊拉克战争:推翻萨达姆容易,稳定难。从有限目标vs无限目标、马赛克社会、2000英里边境到邻国干预,拆解政权更迭的战略陷阱。