用智能体开发本地AI助手:实现Token自由与隐私部署
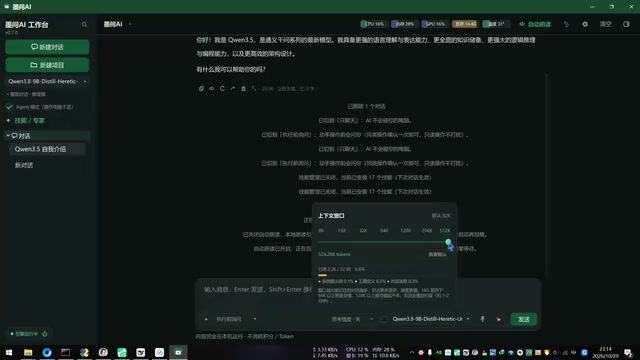
B站UP主用智能体开发本地AI软件莫文AI,分享功能、开发心得与本地部署优劣。
文章介绍了B站UP主利用DeepSeek、WorkBuddy等智能体工具,以“老板-员工”模式开发出本地部署智能体软件“莫文AI”的全过程。莫文AI模仿豆包等主流产品,具备多对话管理、项目模式、归档、模型切换、显存管理、语音朗读与音色克隆等功能。开发心得强调明确需求、提供设计图、使用项目模式保持记忆,并指出不同模型能力差异。本地部署优势在于Token自由、可运行未审查模型和隐私保护,但模型能力弱于在线版,适合简单任务或隐私敏感场景。结语展望本地智能体的未来。
本地部署智能体正成为AI应用的新趋势,一位B站UP主分享了他用智能体开发智能体软件“莫文AI”的全过程。这款软件模仿了豆包、WorkBuddy等主流产品的交互逻辑,并加入了本地部署特有的功能,如显存管理、模型切换和离线对话。更重要的是,UP主揭示了如何利用现有智能体工具(如DeepSeek、WorkBuddy)以“老板-员工”模式开发软件,即使不懂代码也能实现想法。本文将深入解析莫文AI的核心功能、开发心得,以及本地部署智能体的优势与局限。
莫文AI:本地智能体的功能亮点
莫文AI的界面与豆包、WorkBuddy广告相似,降低了用户的学习成本。它支持多对话管理和项目分类,项目模式能提供更好的记忆保持,避免长对话中的上下文丢失。UP主特别强调了归档功能:用户可以将已完结的对话隐藏,需要时再恢复,且归档对话会回到原位置,不会与项目混淆。
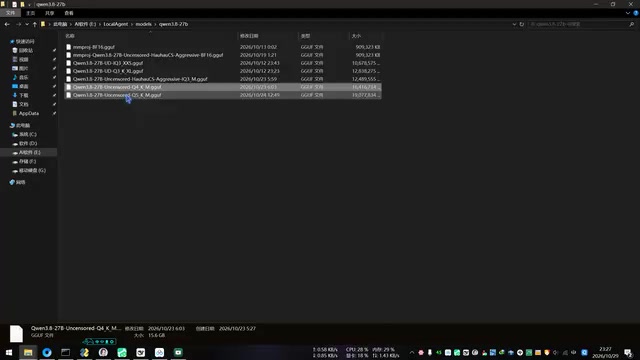
模型管理是本地部署的核心。莫文AI内置了多种模型,并标注了显存需求和建议用途。UP主配置的模型主要针对16G和24G显存,其中DeepSeek广告 R1模型较小,运行流畅但不支持视觉;Qwen 3.8 9B和27B系列则具备视觉能力,但显存占用更高。用户可以根据硬件条件灵活选择,甚至导入自己的模型文件。
软件还提供了显存释放与重新加载功能,方便用户在运行其他GPU任务时快速腾出资源。语音方面,莫文AI集成了自动朗读和语音输入,并支持音色克隆——用户只需录制10秒音频并附上文字稿,即可添加自定义音色。UP主对比了四种朗读模型,推荐第二个模型在自然度和资源占用间取得平衡。
量化模型:本地部署中提到的“量化”是指通过降低模型权重的数值精度(如从16位浮点数压缩到8位或4位整数)来减少模型体积和显存占用,同时尽量保持性能。常见的量化格式包括GGUF、GPTQ、AWQ等,不同量化等级(如Q4、Q8)在精度和资源消耗之间权衡。莫文AI中标注的模型多为量化版本,因此能在16G或24G显存上运行。用户导入自定义模型时也需注意量化格式与推理框架的兼容性。
显存管理:显存(VRAM)是GPU上用于存储模型权重、中间激活值和KV缓存的高速内存。本地运行大模型时,显存不足会导致推理速度骤降甚至崩溃。显存释放功能通过卸载模型权重或清理缓存来腾出空间,重新加载则恢复模型到显存中。合理管理显存可以让用户在运行其他GPU任务(如游戏、渲染)时灵活切换,但频繁加载卸载会增加延迟,建议根据任务时长权衡。
开发心得:用智能体做软件,想法比代码更重要
UP主将开发过程形容为“老板与员工”的协作:用户是老板,智能体是程序员员工,只需清晰表达需求,智能体便能执行。他使用DeepSeek和WorkBuddy进行开发,第一版很快完成,但后续的测试和优化占据了大部分时间。过程中,智能体有时无法理解复杂描述,UP主建议改用更明确的指令,或直接提供设计图(如PS稿)让AI按图实现。
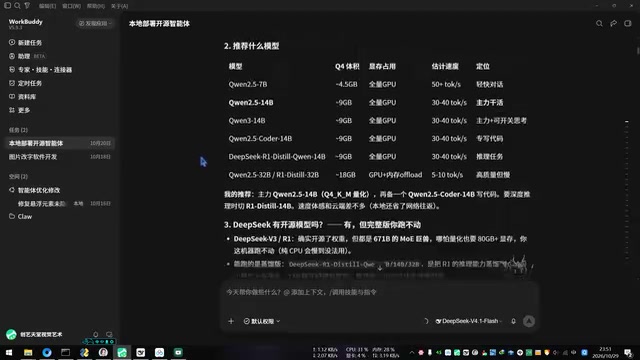
对于长期项目,UP主强烈建议使用“项目”模式而非普通对话,因为项目能更好地保持记忆,避免上下文压缩导致的信息丢失。他提到,在开发后台执行功能时,WorkBuddy多次未能解决问题,切换至DeepSeek后最终完成。这反映了不同模型在复杂任务上的能力差异。
项目模式与上下文记忆:普通对话模式在长对话中会因上下文窗口限制而压缩或丢失早期信息,导致智能体“忘记”需求。项目模式通过独立存储项目相关的对话历史、文件与指令,并在每次交互时优先检索项目上下文,从而保持记忆一致性。对于开发软件这类长周期任务,项目模式能避免重复描述需求,减少智能体偏离目标的风险。但项目模式仍需合理组织信息,避免上下文过长超出窗口。
本地部署智能体的优势与局限
本地部署的最大吸引力在于“Token自由”——无需消耗积分或付费,且能运行未经审查的模型,回答不受限制。隐私也是关键优势,所有数据留在本地,避免云端泄露风险。然而,UP主坦言,本地模型的能力与在线模型差距明显,复杂任务(如开发软件)仍建议使用在线智能体。本地部署更适合简单任务、隐私敏感场景或实验性项目。
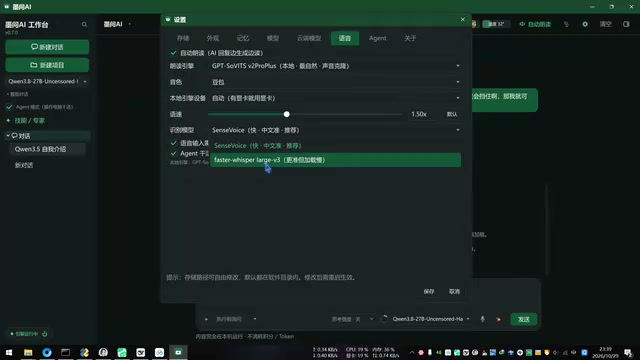
此外,本地部署对硬件要求较高,显存不足会导致运行缓慢甚至卡死。UP主建议根据显存大小选择模型,并合理利用显存释放功能。语音识别模型在快速说话时可能缺失标点,但整体识别效果可接受。
未审查模型:指未经内容安全对齐或过滤的模型版本,通常由社区在基础模型上微调或直接发布原始权重。这类模型回答不受平台政策限制,但可能生成有害或不准确内容,使用者需自行承担风险。本地部署允许运行此类模型,是“Token自由”之外的另一吸引力,但也要求用户具备辨别和过滤能力。在线服务则因合规要求普遍内置审查机制。
结语:本地智能体的现在与未来
莫文AI展示了本地智能体的可能性:通过现有智能体工具,普通人也能开发出功能完善的AI应用。虽然本地模型尚未达到在线模型的智能水平,但其在隐私、成本和自由度上的优势不容忽视。随着硬件性能提升和模型优化,本地部署有望成为更多人的选择。对于想要尝试的开发者,UP主的经验是:明确需求、耐心迭代,并善用项目模式管理长周期任务。
相关推荐
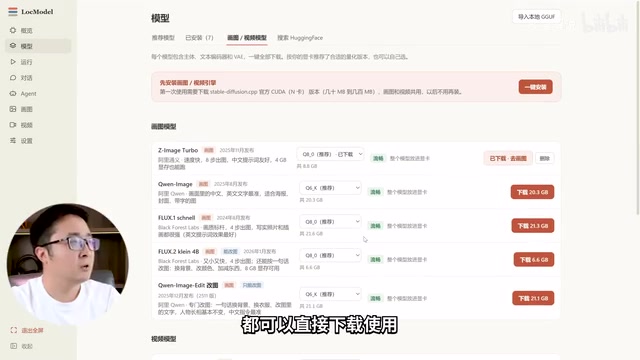
本地AI部署神器LocModel:一键玩转开源模型与AI生成
LocModel是一款本地AI部署工具,可自动适配硬件、一键下载开源模型,支持图片生成、视频生成、无审查大模型和Agent智能体,完全免费。本文基于实测视频介绍其安装与使用流程。

Antigravity CLI:终端免费调用Gemini与Claude顶级模型
Antigravity CLI(agy)宣称可在VS Code终端免费调用Gemini 3.1 Flash、Claude Sonnet等顶级模型,几秒完成安装。本文拆解其使用流程、终端内调用模型的价值,以及免费宣称背后需要核实的安全与可持续性问题。

聊天机器人与AI智能体:核心区别与选型指南
聊天机器人与AI智能体到底有什么区别?本文从工具、记忆、工作流三个维度拆解两者差异,用整理收件箱、安排会议等四个真实场景对比,并给出权限控制、不可逆操作确认等风险防范建议与选型判断标准。