预训练中什么在变好?时间变异性分数揭示知识学习动态

研究提出时间变异性分数TVS,揭示预训练中高TVS知识后期提升更快、最终表现更优。
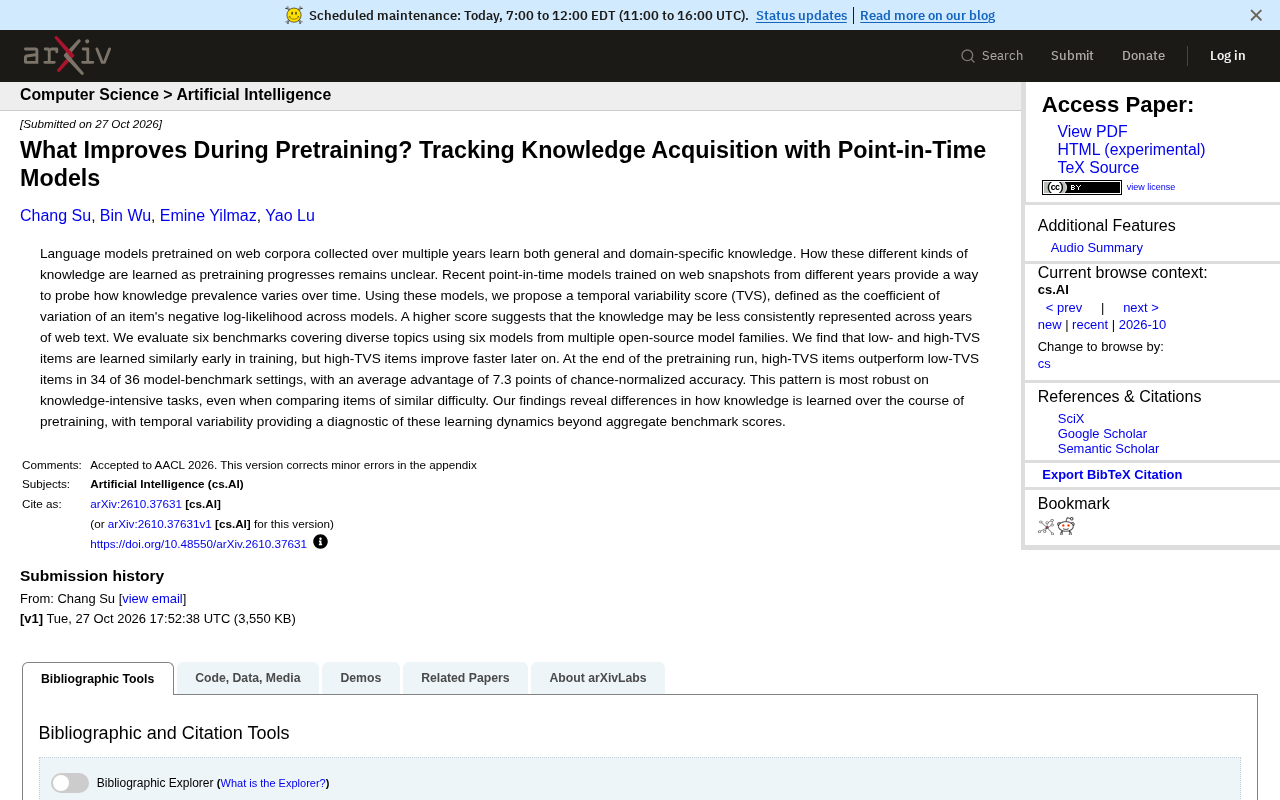
该研究关注语言模型预训练过程中知识学习的动态差异,提出时间变异性分数(TVS)来量化知识在不同年份网络文本中的一致性。TVS 定义为条目在多个时间点模型上负对数似然的变异系数。研究发现,高 TVS 与低 TVS 条目在训练早期学习速度相似,但高 TVS 条目在后期提升更快,最终在 36 个模型-基准设置中的 34 个里表现更优,平均优势达 7.3 个百分点的机会归一化准确率。这一模式在知识密集型任务上最为稳健,且控制难度后依然成立。研究认为 TVS 可作为超越聚合基准分数的诊断工具,并为预训练数据构建与课程设计提供启示。
预训练中什么在变好?时间变异性分数揭示知识学习动态
语言模型在多年收集的网络语料上预训练,会学到通用知识和领域知识。但这些知识在预训练过程中如何被学习,一直不清楚。最近一项研究利用在不同年份网络快照上训练的时间点模型(point-in-time models),提出了时间变异性分数(Temporal Variability Score, TVS),用来量化知识在不同年份网络文本中的一致性。研究发现,高TVS和低TVS的条目在训练早期学习速度相似,但高TVS条目在后期提升更快,最终在大多数模型-基准组合中表现更优。
什么是时间变异性分数(TVS)?
TVS定义为条目在多个时间点模型上负对数似然的变异系数。简单说,如果一个事实在不同年份的网络文本中频繁出现且表述一致,那么在不同时间点模型上它的负对数似然应该比较稳定,TVS较低;反之,如果某个事实只在特定年份流行,或者随时间变化大,那么不同模型对它的预测波动就大,TVS较高。
研究使用了多个开源模型家族的六个模型,覆盖六个不同主题的基准,来评估TVS与学习动态的关系。TVS提供了一种诊断工具,超越了聚合的基准分数,揭示知识在预训练过程中的学习差异。
负对数似然(Negative Log-Likelihood, NLL)是语言模型预训练和评估中最基础的损失度量之一。对于一条知识条目(例如一个事实或问答对),模型会为其生成一个概率值,表示模型认为该答案正确的可能性;NLL 就是该概率的负对数。NLL 越低,说明模型对该条目的预测越有信心、越准确。在时间点模型上,同一条目在不同年份快照训练的模型上会得到不同的 NLL 值。TVS 之所以采用"变异系数"(标准差除以均值)而非单纯的标准差,是因为变异系数是一种无量纲的归一化度量,能够消除不同条目之间 NLL 绝对水平差异的影响,使得跨条目、跨模型的比较成为可能。
机会归一化准确率(chance-normalized accuracy)是评估中常用的校正指标,其计算方式为(模型准确率 − 随机猜测准确率)/(1 − 随机猜测准确率)。由于不同基准的选项数量和随机基线不同,原始准确率难以直接横向比较,机会归一化准确率将表现映射到"相对于随机猜测提升了多少"的统一尺度上,使跨基准的平均和对比更具意义。
高TVS与低TVS条目:学习节奏的差异
分析发现,在训练早期,低TVS和高TVS条目的学习情况相似。但随着训练推进,高TVS条目进步更快。到预训练结束时,在36个模型-基准设置中,有34个设置高TVS条目表现优于低TVS条目,平均优势达到7.3个百分点的机会归一化准确率(chance-normalized accuracy)。
这一模式在知识密集型任务上最为稳健,即使比较难度相似的条目也是如此。这意味着TVS捕捉到了知识学习过程中一些超越难度的因素。
时间点模型(point-in-time models)是这项研究的方法论基石。研究者从网络存档(如 Common Crawl 的各年份快照)中截取不同时间段的语料,分别训练结构相同但数据截止年份不同的模型。这样,每个模型就"冻结"了特定时期的网络知识分布,相当于一系列时间切片上的知识快照。通过在同一组条目上比较这些模型的预测表现,研究者得以将"知识随时间的变化"与"模型训练过程的变化"分离开来观察。需要注意的是,时间点模型与常规的检查点(checkpoint)不同:前者变化的是训练数据的时间范围,后者变化的是同一数据集上的训练步数。本研究将两种维度结合,才得以刻画条目在预训练过程中的学习轨迹。
为什么高TVS条目后期提升更快?
一个可能的解释是,高TVS条目往往对应那些在特定时间段内频繁出现、但并非始终普遍存在的知识。模型在预训练后期可能更好地捕捉到这些随时间变化的知识信号。相比之下,低TVS条目可能对应那些始终常见、模型很早就能掌握的知识,后期提升空间有限。
另一种解释与模型容量和训练动态有关:高TVS条目可能需要更多的训练步骤来整合分散在不同时间片段的信息,而低TVS条目则更早被稳定表示。
课程学习(curriculum learning)是预训练数据构建中的一个相关概念,指按照某种难度或信息量顺序安排训练数据,以期提升学习效率。本研究的结果对课程设计有潜在启示:如果高 TVS 条目确实需要更多训练步骤才能整合分散的时间信号,那么在预训练后期适当增加这类知识的曝光,或许能带来额外收益。另一方面,模型容量(capacity)指模型参数所能容纳的信息量;当容量有限时,始终常见且一致的知识(低 TVS)会优先被压缩表示,而高 TVS 条目所携带的、随时间波动的细粒度信号则可能需要更多参数和更长的训练才能被充分编码。这为理解"后期提升"提供了一个与容量分配相关的解释视角。
对预训练和评估的启示
这项研究提示,聚合的基准分数可能掩盖知识学习的不同模式。TVS可以作为诊断工具,帮助理解模型在预训练过程中如何吸收不同类型知识。对于预训练数据构建和课程设计,考虑知识的时间变异性可能有助于优化学习效率。
此外,时间点模型提供了一种探测知识流行度随时间变化的方法,未来或可用于评估模型对时效性知识的掌握程度。
总结
研究通过TVS揭示了预训练中知识学习的动态差异:高TVS条目在后期提升更快,最终表现更优。这一发现为理解预训练过程提供了新视角,并展示了时间变异性作为诊断工具的潜力。
相关推荐
VCP V工程实测:Token缓存95%命中,AI控制AI螺旋编程
VCP V工程实测:单轮对话Token缓存命中率95%以上,用AI控制AI实现螺旋编程,主控Agent策划、施工Agent写码,已策划工程可完全脱手。附完整配置步骤与局限分析。
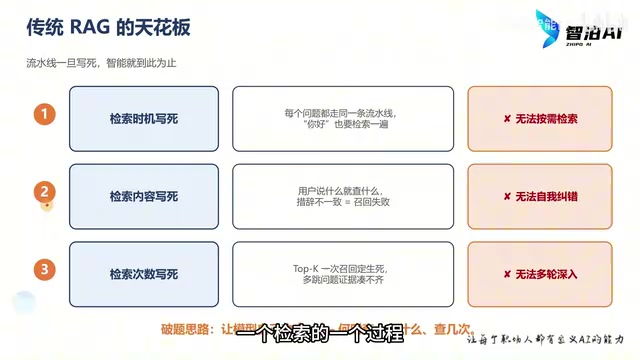
Agentic RAG实战:从原理到代码,手把手搭建智能检索系统
传统RAG检索时机、内容、次数全部写死,导致答非所问。本文基于B站教程拆解Agentic RAG原理:将检索封装为工具交给大模型自主决策,附四工具设计与完整代码实现,手把手搭建能自我纠错、多跳查询的智能检索系统。
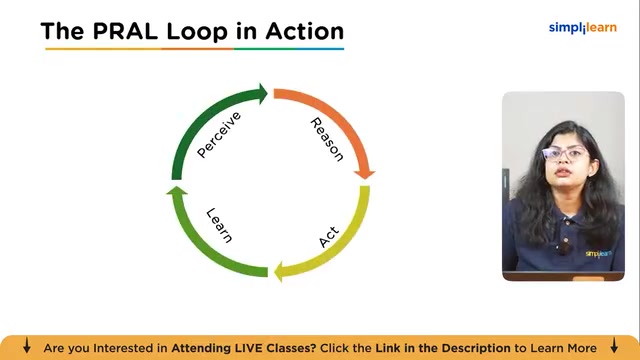
1小时搞懂Agentic AI:架构、设计模式与实战搭建
Simplilearn的Agentic AI速成课程解析:智能体三层架构(感知、认知、动作)、单智能体与多智能体对比、感知推理执行学习循环、三种设计模式,以及研究智能体、应用构建和反馈修复循环的实战演示。