语言风格与礼貌策略如何影响LLM社交推理?控制实验揭示有限作用
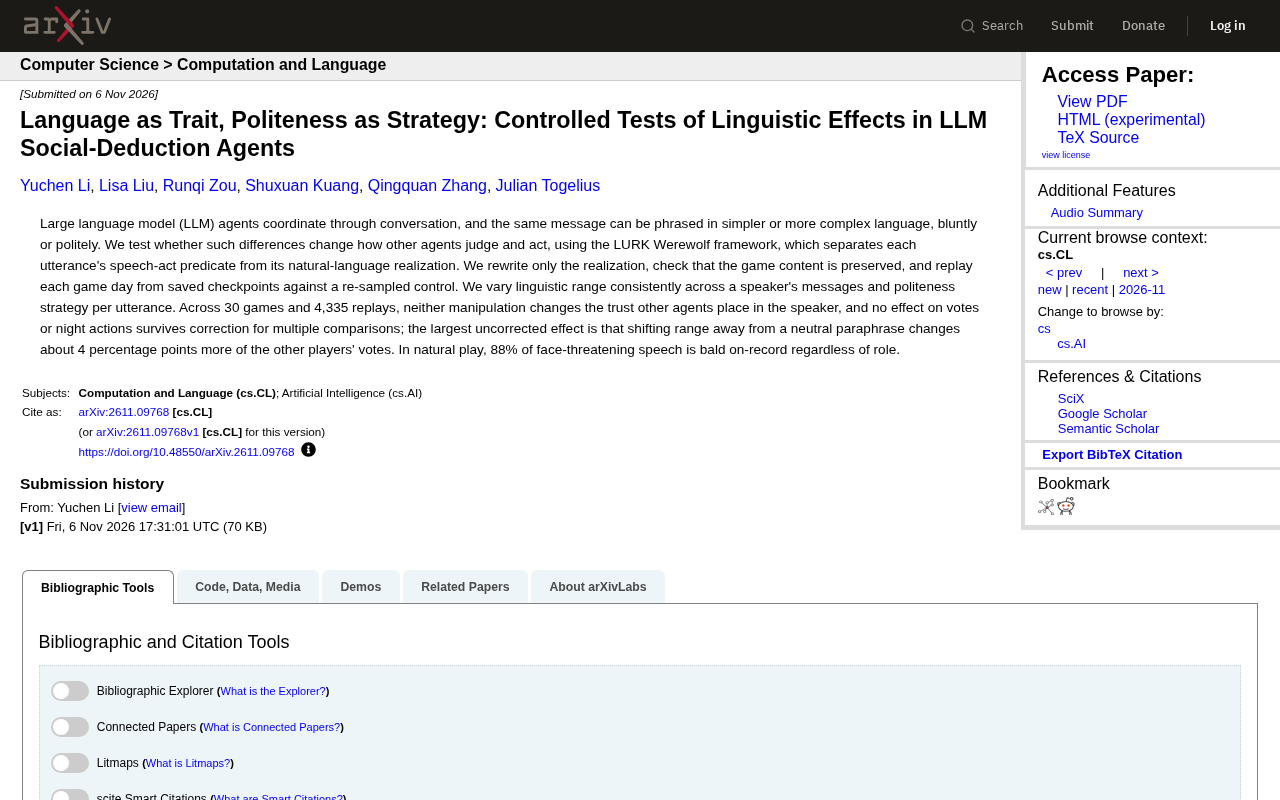
控制实验表明,LLM社交推理智能体的信任与行为对语言风格和礼貌策略不敏感。
研究在LURK Werewolf框架下开展控制实验,将言语行为与自然语言实现分离,仅重写语言实现并重放游戏日,操纵语言范围与礼貌策略两个维度。覆盖30局游戏、4335次重放的结果显示,两种操纵均未显著改变其他智能体对说话者的信任,对投票和夜间行动的影响经多重比较校正后也不显著,最大未校正效应仅约4个百分点。自然对局中88%的威胁面子言语以赤裸裸的记录方式表达。研究者认为,LLM社交智能体可能更依赖言语行为内容而非表达方式,或尚未学会将语言风格作为社交信号。
在基于大语言模型(LLM)的社交推理游戏(如狼人杀)中,智能体通过对话进行协调,而同一信息可以用更简单或更复杂的语言表达,也可以更直接或更礼貌。这种语言层面的差异是否会影响其他智能体的判断和行为?一项在 LURK Werewolf 框架下进行的控制实验给出了答案:语言风格和礼貌策略的影响远小于预期。
实验设计:分离语言实现与游戏内容
LURK Werewolf 框架将每句话的言语行为谓词(speech-act predicate)与其自然语言实现(realization)分开处理,使得研究者能够精确控制语言层面。实验中,研究者只重写语言实现,并验证游戏内容保持不变,然后从保存的检查点重放每个游戏日,并与重新采样的对照组进行比较。
研究对语言的两个维度进行了操纵:一是语言范围(linguistic range),即说话者所有消息中语言复杂程度的系统性变化;二是礼貌策略(politeness strategy),即每句话的礼貌程度。实验覆盖30局游戏,共进行4,335次重放。
言语行为理论(Speech Act Theory) 由哲学家 J.L. Austin 和 John Searle 提出,核心观点是“说话即行动”——语言不仅描述世界,还执行诸如请求、威胁、承诺、道歉等行为。在社交推理游戏中,玩家说“我怀疑你是狼人”不仅传递信息,更是一种“指控”行为,会改变游戏状态和他人认知。LURK Werewolf 框架将每句话拆分为言语行为谓词(如 accuse、defend、threaten)和自然语言实现(具体措辞、语气、礼貌程度),前者决定“做什么”,后者决定“怎么说”。这种分离使研究者能固定行为内容、只改变表达方式,从而干净地检验语言表面特征是否独立影响智能体判断。
核心发现:信任与行为不受显著影响
实验结果显示,这两种操纵均未改变其他智能体对说话者的信任程度。此外,对投票或夜间行动的影响在多重比较校正后均不显著。最大的未校正效应是:将语言范围从中性转述(neutral paraphrase)移开,会改变约4个百分点的其他玩家投票。这一效应量在统计上并不稳健。
在自然游戏对局中,88%的威胁面子言语(face-threatening speech)无论角色如何,都以赤裸裸的记录(bald on-record)方式表达。
威胁面子言语(face-threatening speech) 源自 Brown & Levinson 的礼貌理论。“面子”指个人希望获得认可与不受干扰的社会需求;威胁面子的言语包括命令、批评、指控、威胁等,可能损害听者的自主性或社会形象。礼貌策略正是用来缓和这种威胁的手段,例如用“也许你可以考虑……”代替“你必须……”。在狼人杀中,指控和质疑天然具有威胁面子属性。实验中 88% 的此类言语采用赤裸裸的记录(bald on-record) 方式,即不加任何缓和、直接表达——这符合游戏追求效率和清晰判断的语境,也说明智能体在自然对局中很少主动使用礼貌修饰。
多重比较校正(multiple comparisons correction) 是统计推断中的关键步骤。当研究者同时检验多个假设(如语言范围对信任、投票、夜间行动等多个结果的影响)时,即使每个检验单独看有 5% 的假阳性率,累积起来出现至少一个“显著”结果的概率会远高于 5%。Bonferroni、Holm 或 Benjamini-Hochberg 等方法通过调整显著性阈值来控制整体错误率。本文中,未校正时最大效应约 4 个百分点,但经校正后均不显著,说明这些效应很可能来自随机波动,而非语言操纵的真实影响。
启示:LLM社交智能体对语言表面特征不敏感
这一发现对多智能体系统设计具有重要含义。尽管人类交流中语言风格和礼貌策略常影响信任与合作,但LLM智能体在社交推理任务中并未表现出对这类表面语言特征的敏感性。这可能意味着智能体的判断更多依赖于言语行为的内容而非其表达方式,或者当前模型尚未学会利用语言风格作为社交信号。
研究者指出,需要进一步探索更细微的语言操纵或更复杂的社交场景,以确定语言效应在何种条件下可能显现。
相关推荐
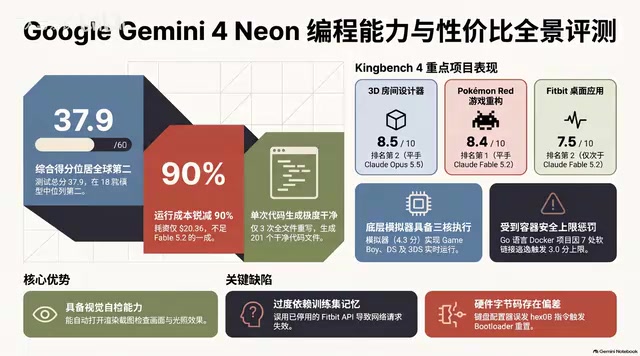
Gemini 4 Neon实测:性价比之王还是自信的灾难?
Gemini 4 Neon 实测深度解析:百万 token 上下文、四档思考级别,KingBench4 一遍过写 201 个文件,成本仅为 Fable 5.2 的十分之一。但它会靠幻觉假数据蒙混、留下 7 个符号链接逃逸漏洞、把键盘写成砖。性价比与危险并存,多模型议会审查才是破局关键。
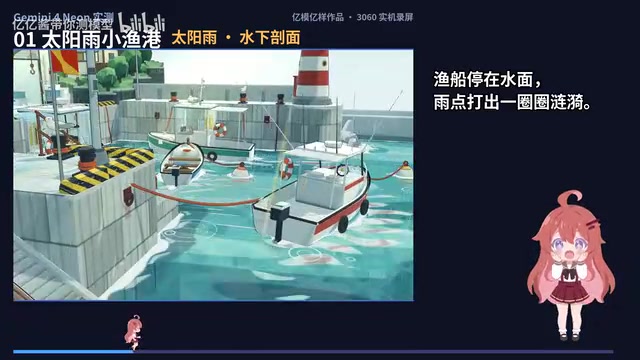
谷歌Gemini 4 Neon实测:6个3D作品惊艳与翻车
谷歌Gemini 4 Neon在3060笔记本上实测6个3D作品:太阳雨渔港细节惊艳,机械键盘配置器完成度高,但软糖物理形变过头、帝王像人脸偏方。多源测评交叉验证,审美在线但物理与人脸是短板。
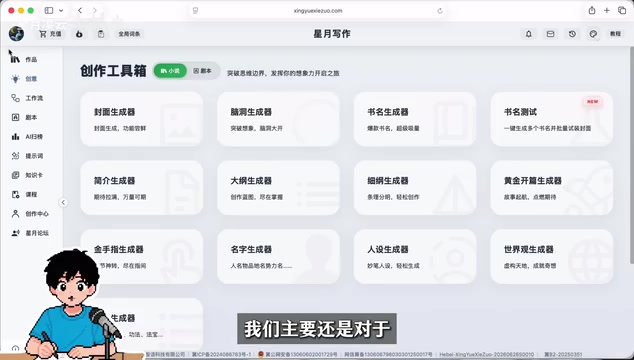
Gemini 4 Neo写小说网文实测:AI味淡、对话有质感
B站UP主首发测评Gemini 4 Neo写小说网文能力:实测三国穿越开篇生成,AI味淡、对话有情绪质感、危机感塑造到位,并对比4A/4H/4C四个模型差异,演示拆纲续写与审稿纠错全流程。