语言区分能力提升多语言语音模型的语言学习表现

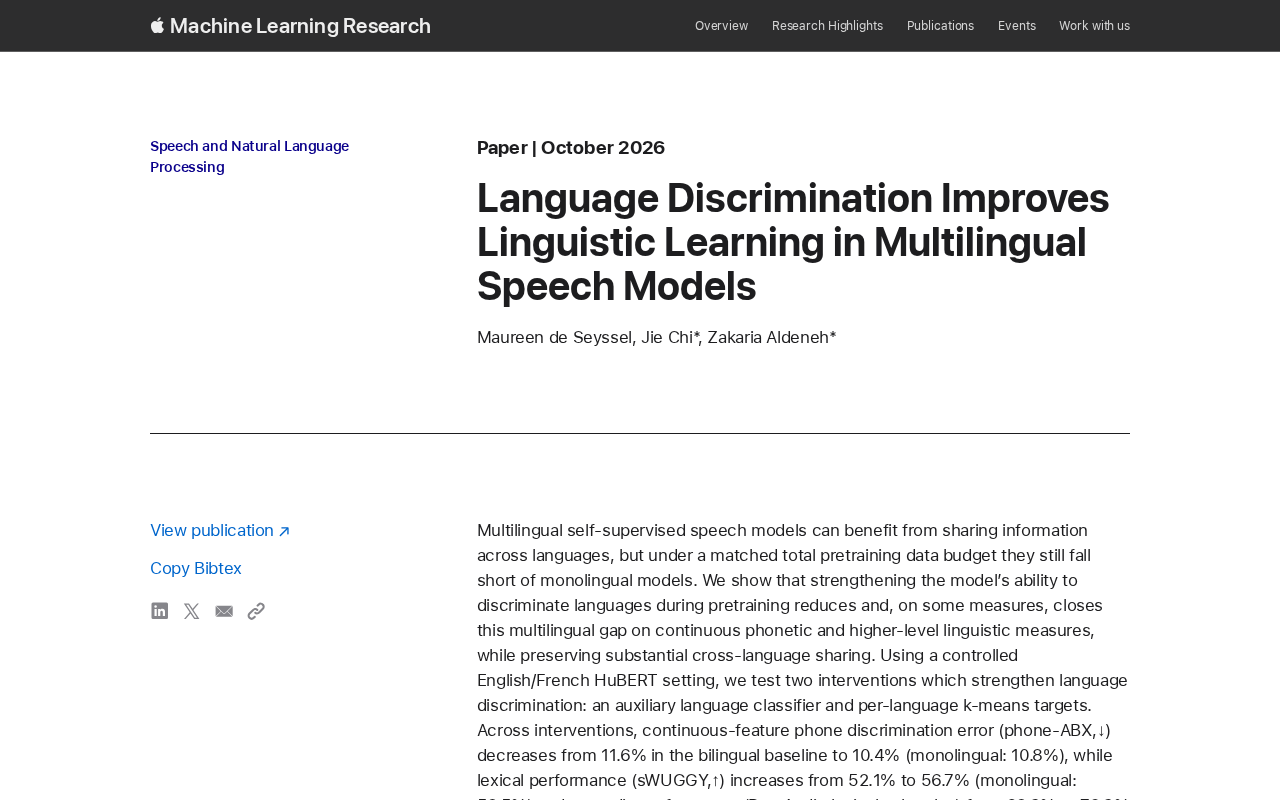
强化多语言语音模型区分语言的能力,可缩小其与单语言模型之间的性能差距。
本文介绍了一项针对多语言自监督语音模型"多语言差距"问题的研究。在相同预训练数据预算下,多语言模型在音位及更高层语言学指标上仍落后于单语言模型,根本原因是资源被多种语言分摊稀释。研究的反直觉发现是:在预训练阶段通过辅助语言识别任务等手段**强化**模型对语言的区分能力,反而能缩小乃至消除这一差距,且同时保留了跨语言信息共享的优势。实验基于受控的英语/法语HuBERT双语设置,验证了"区分"与"共享"可以协同优化而非相互排斥。该发现对低资源语言语音系统和多语言语音助手的设计具有实际指导意义,但结论是否推广至差异更大的语系,仍有待后续研究。
多语言语音模型的"共享困境"
自监督语音模型近年来成为语音处理领域的核心技术,其中多语言模型因为能够在不同语言之间共享信息而备受关注。理论上,当一个模型同时学习英语、法语等多种语言时,它可以借助语言之间的共性来提升表示质量——这正是跨语言迁移的魅力所在。
但现实并非如此理想。研究者发现一个颇为棘手的问题:在总预训练数据预算相同的条件下,多语言模型在语言学习能力上仍然落后于单语言模型。换句话说,当你把固定的训练资源分摊给多种语言时,每种语言得到的"关注"都被稀释了,模型在连续音位(phonetic)和更高层语言学指标上的表现因此打了折扣。这个差距被称为"多语言差距"(multilingual gap)。
自监督学习(Self-Supervised Learning,SSL)在语音领域的兴起,本质上是为了绕开大规模人工标注的瓶颈。传统监督训练需要每一条语音都配上对应文本,而自监督方法通过设计"预训练任务"——例如预测被遮盖的音频帧、对比相似片段——让模型仅凭原始音频就能学到有用的表示。这类表示随后通过微调迁移到语音识别、说话人验证等下游任务。多语言自监督模型(如XLSR、MMS)进一步把这种思路扩展到几十甚至上千种语言,以期用一个模型覆盖资源稀缺语言。然而,共享参数在多语言场景下既是优势(跨语言迁移),也是资源竞争的根源——"多语言差距"正是在这一背景下被提出和研究的。
强化语言区分能力是关键
这项研究提出了一个反直觉却富有洞见的核心观点:增强模型在预训练过程中区分不同语言的能力,反而能够缩小甚至在某些指标上消除这一多语言差距。
这个发现的精妙之处在于它并没有牺牲跨语言共享。研究显示,在强化语言区分能力的同时,模型依然保留了大量的跨语言信息共享。这意味着模型既能清楚地"知道"自己正在处理哪种语言,又能利用语言间的共通规律——两者并非此消彼长的关系,而是可以协同优化的目标。
从认知角度看,这其实与人类学习多语言的方式有相通之处。一个真正精通双语的人,能够在脑中清晰地切换语言系统(强区分),同时又能借助已有语言知识加速新语言的掌握(强共享)。
两种干预方法的实验设计
研究采用了受控的英语/法语 HuBERT 实验环境。HuBERT 是一种广泛使用的自监督语音表示模型,通过在受控的双语设置下进行对照实验,研究者能够精确地衡量干预措施带来的影响。
为了强化语言区分能力,研究测试了两种干预手段:
辅助语言任务
第一种方法是引入辅助语言识别任务(auxiliary language task)。通过让模型在预训练时额外承担判别语言身份的任务,促使其内部表示更好地编码语言特征。这种多任务学习的思路,让模型在学习通用语音表示的同时,被明确要求区分语言边界。
辅助任务(auxiliary task)是多任务学习(multi-task learning)中的常见设计模式:在主要训练目标之外,增加一个或多个额外的预测目标,这些辅助目标共享模型的部分参数,从而对主任务的特征学习产生正则化或引导作用。关键在于,辅助任务本身并不是最终关心的目标,但它迫使共享层编码额外信息。在此研究中,语言身份识别(判断当前语音片段属于英语还是法语)就是一个典型的辅助任务:它不影响模型最终被用作通用语音表示,却在训练期间给模型施加了"必须区分语言"的梯度信号,从而塑造出更具语言感知能力的内部表示空间。
其他区分性干预
原文提到的第二种干预手段同样指向强化语言区分,二者共同验证了核心假设——只要让模型更擅长分辨语言,其整体语言学习能力就能获得提升。
HuBERT(Hidden-Unit BERT)是Meta AI于2021年提出的自监督语音表示模型,其核心思想是借鉴NLP领域BERT的掩码预测机制。训练过程分两阶段:先用简单的聚类算法(如K-means)对音频特征生成伪标签,再让模型预测被随机掩盖的音频帧所对应的伪标签类别。这种"预测离散聚类中心"的方式使模型无需任何人工标注就能学到丰富的语音表示。选择HuBERT作为实验载体,是因为它架构成熟、社区基准完善,便于将干预效果与已有研究进行横向比较。
对多语言语音技术的启示
这项研究的价值不仅在于提出了一个具体技巧,更在于它挑战了一种常见假设:人们往往认为多语言模型的优势来自"模糊语言边界、强调共性"。而这里的证据表明,适度强调语言差异反而是更优的策略。
对于构建低资源语言的语音系统、开发多语言语音助手、或是在有限算力下训练覆盖多种语言的模型,这一发现都具有实际的指导意义。它提示工程师在设计预训练目标时,不应只追求跨语言的统一表示,而应在共享与区分之间找到平衡点。
说一下,当前实验仅在英语/法语两种相对接近的语言上进行验证。对于差异更大的语系(如中文与英语),这一结论是否同样成立,仍有待进一步研究。连续音位和高层语言学指标上的改善能否延伸到实际下游任务,也是后续值得关注的方向。
小结
这项工作揭示了多语言自监督语音模型中一个被忽视的维度:语言区分能力。通过辅助语言任务等干预手段强化这种能力,研究者成功缩小了多语言模型与单语言模型之间的性能差距,同时保留了跨语言共享的优势。这为未来更高效的多语言语音模型设计提供了一条值得探索的路径。
相关推荐
AI写代码越来越便宜,真正难的是验证
生成代码越来越便宜,软件团队的瓶颈转向验证。结合萨提亚·纳德拉访谈,解析编程智能体的规格说明、多模型审查、权限分离与组织调整,以及工程师如何把一次修复沉淀为团队可复用的能力。
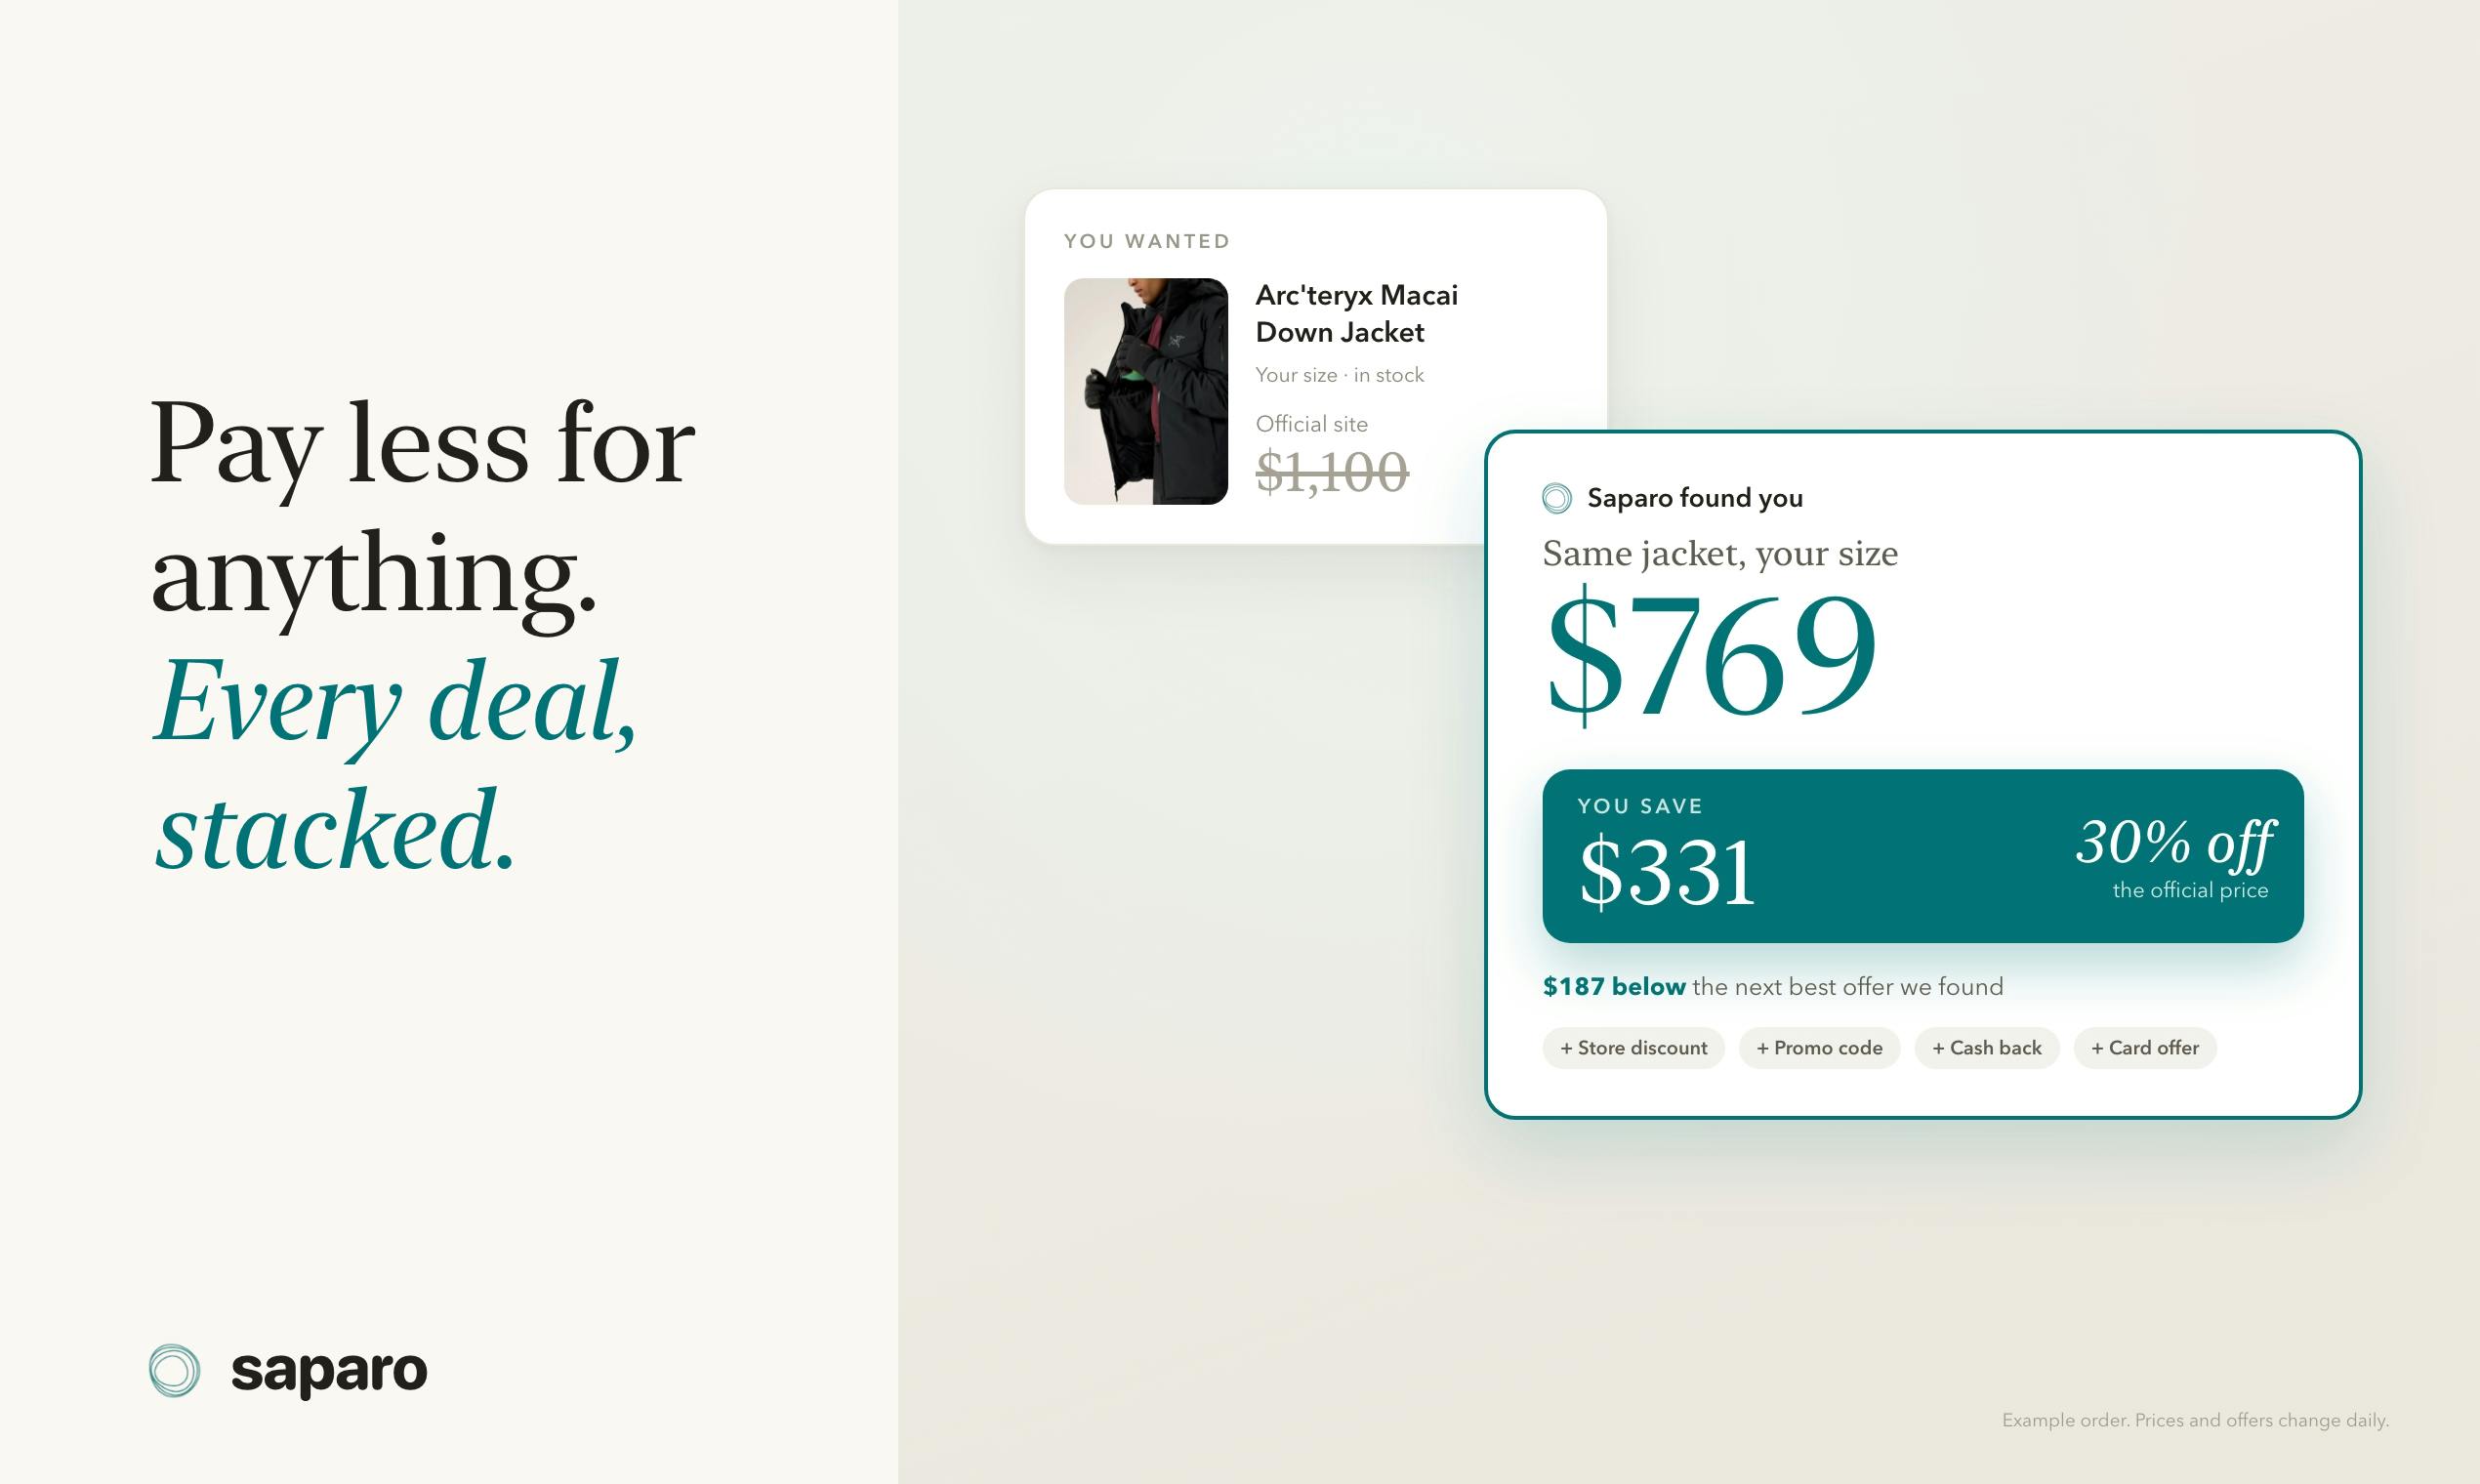
Saparo:自动叠加优惠的购物AI代理,登顶Product Hunt
Saparo 是一款自动叠加优惠的购物 AI 代理,登顶 Product Hunt。它能搜索同款、匹配尺码、组合促销码与返现,按含运费税费的总成本排序,最终支付由用户完成。
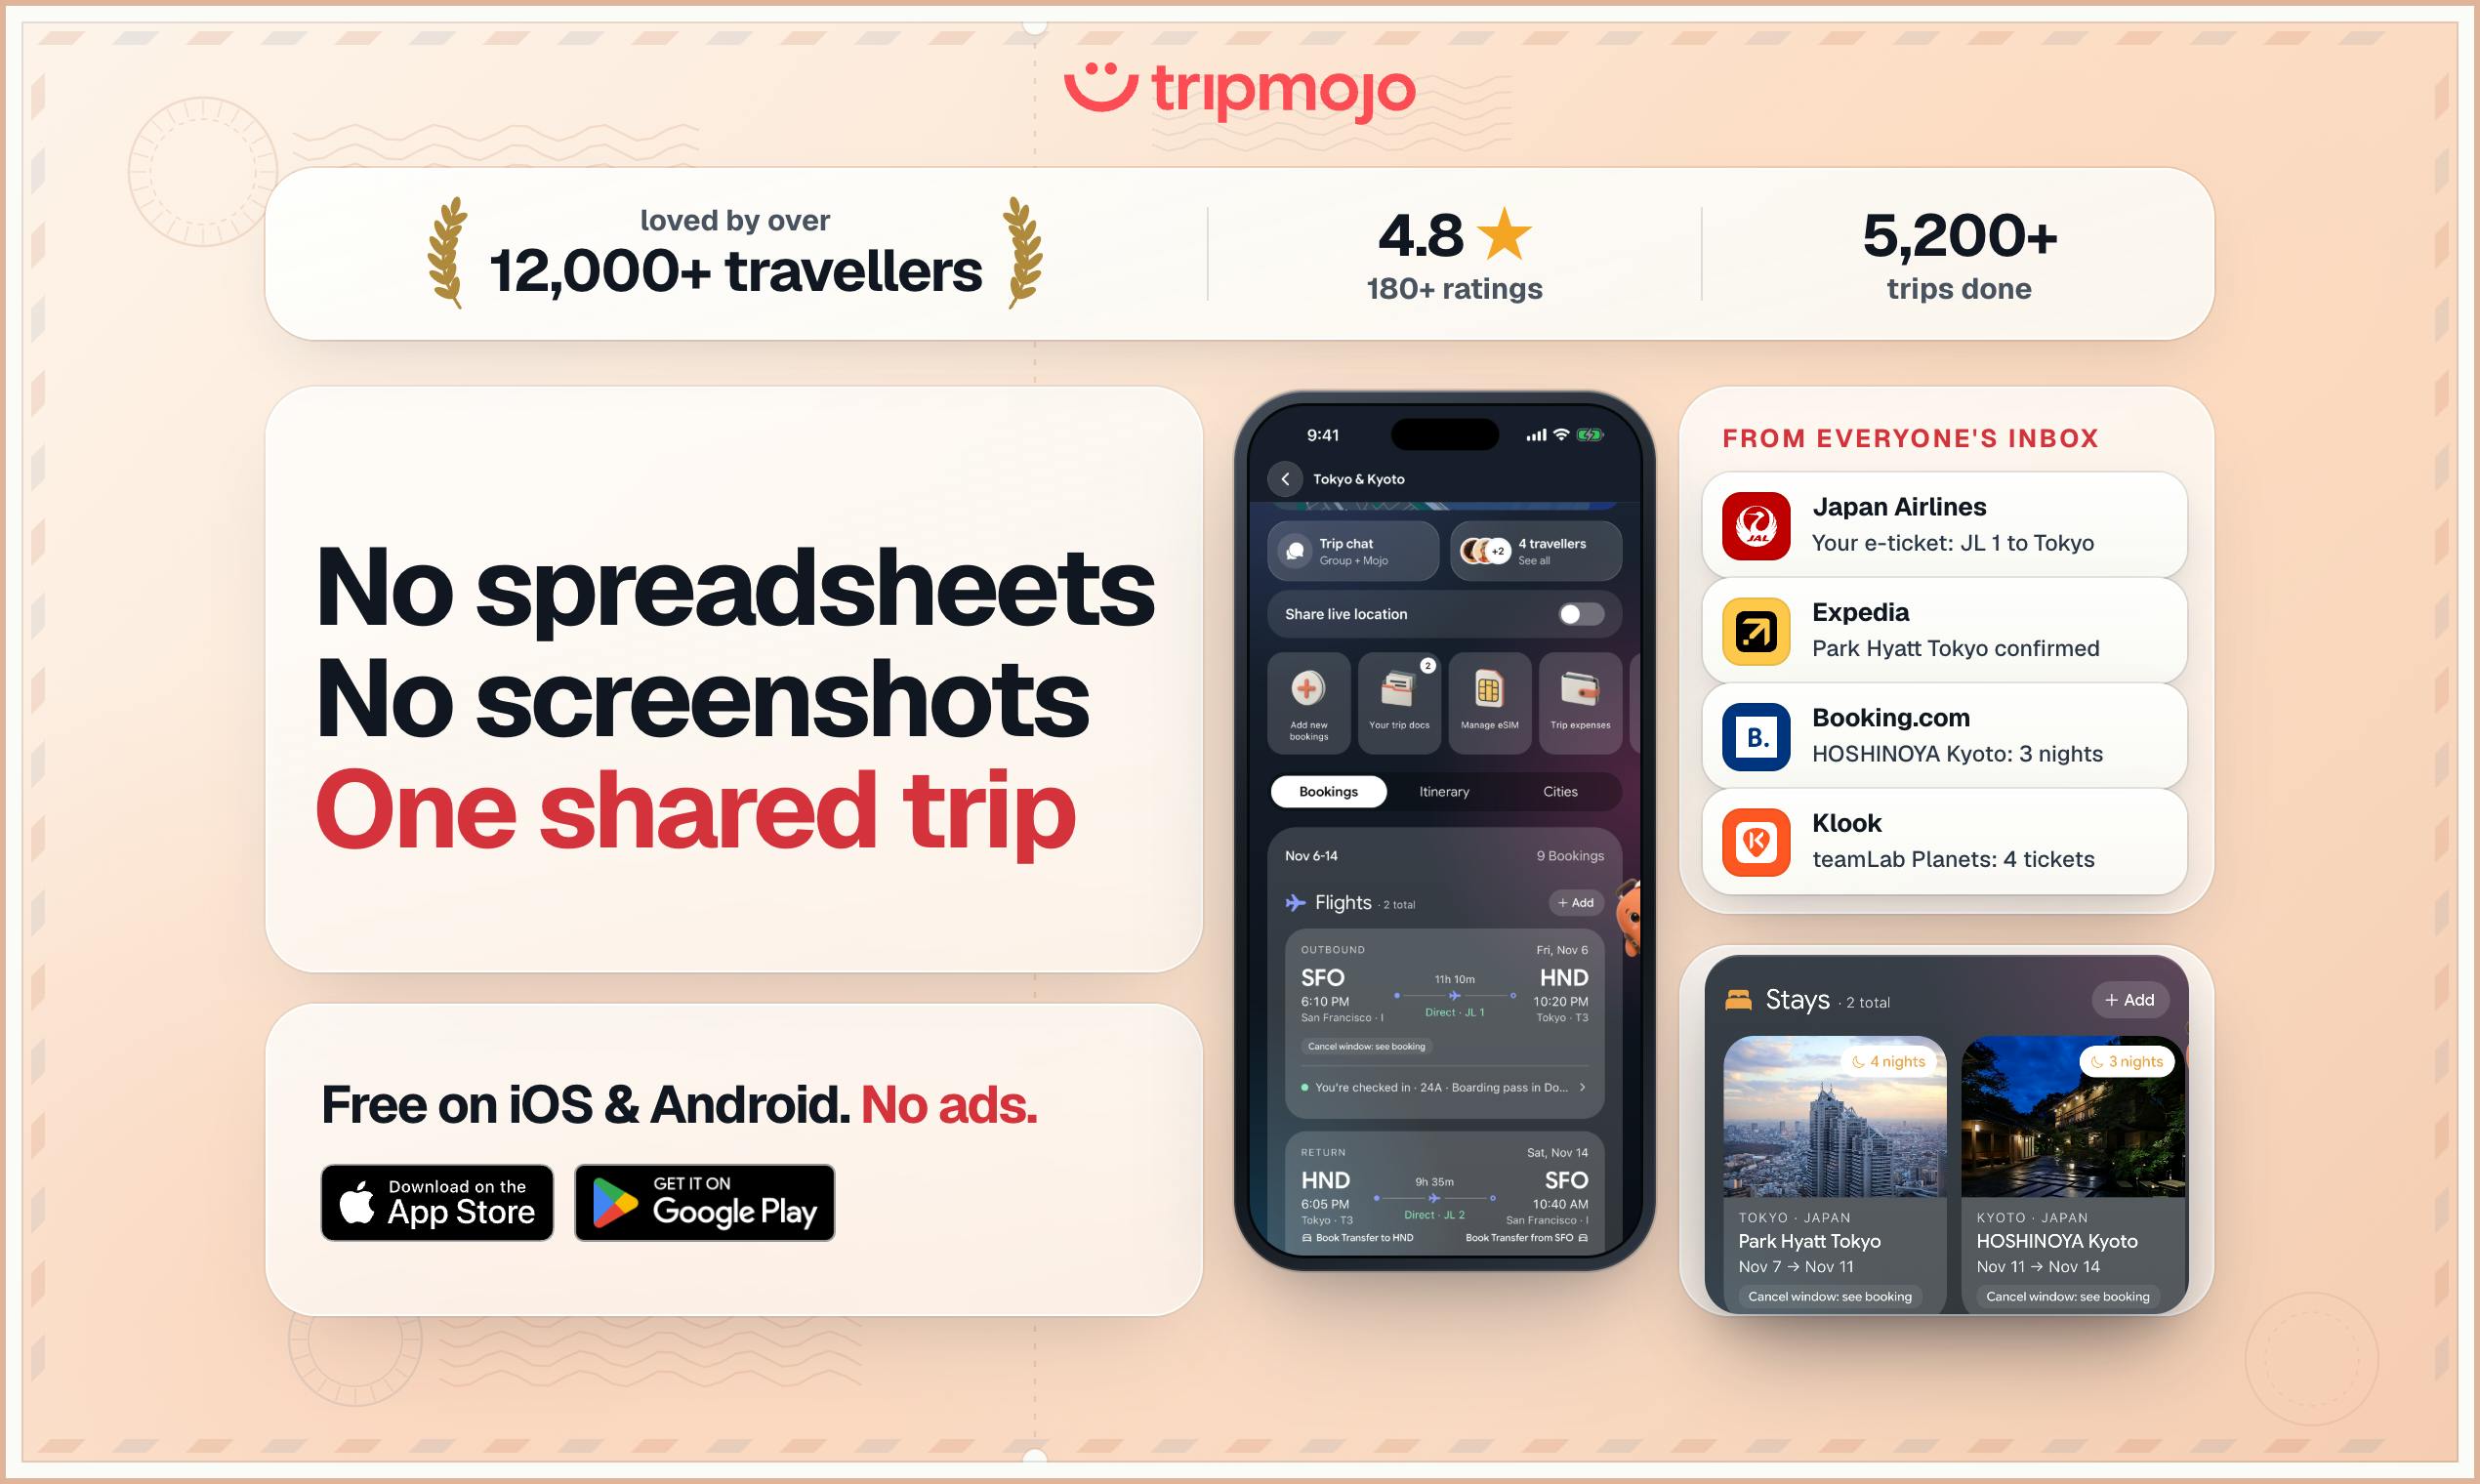
Tripmojo:会帮你值机的AI旅行Agent
Tripmojo是Product Hunt上排名第2的AI旅行Agent应用,能同步预订邮件生成共享行程,并由AI助手Mojo在出行当天尝试值机、保存登机牌、提醒延误与登机口变更,行程中维护计划并分摊费用,iOS与Android免费。