语义缓存实战:用Python和Redis为AI系统提速

用Python和Redis实现语义缓存,通过向量相似度复用历史回答并为AI系统提速。
文章从精确缓存的局限讲起,说明语义缓存如何通过embedding将查询映射为向量、以相似度匹配复用历史回答。演示先用NumPy手写核心逻辑:维护历史embedding与回答的平行列表,用矩阵乘法批量算相似度、argmax取最佳匹配,并强调只在产生原始回答时写入以避免缓存污染。接着重点拆解阈值调优,指出0.6、0.7会误判语义相反或意图不同的查询,0.9是较稳妥的默认值。随后介绍三类高风险场景(上下文对话、环境相关、个人及时效数据)及TTL、淘汰、作用域三种工程手段,最后用Redis VL的SemanticCache搭建可持久化、跨进程的生产级方案,并提醒其distance_threshold是距离而非相似度。
语义缓存实战:用Python和Redis为AI系统提速
当一个AI系统每天要处理海量用户请求时,真正拖慢速度的往往不是模型本身,而是那些重复或高度相似的问题被一遍遍地从零计算。语义缓存(Semantic Caching)正是解决这个问题的关键技术:它把用户查询嵌入到向量空间,只要新问题与历史问题足够相似,就直接复用已有结果,跳过整条推理链路。
本文基于一位AI工程师的实战演示,从最朴素的字典缓存讲起,逐步过渡到基于Redis的生产级方案,并重点拆解阈值调优、TTL、淘汰策略和作用域这几个容易被忽视的坑。
从精确缓存到语义缓存:差在哪里
传统缓存只能命中完全相同的字符串。用户问「What is the capital of France?」,下次有人一字不差地问同样的问题才能复用结果。这在某些系统里确实有用——总有人逐字重复同一个问题——但覆盖面很窄。
语义缓存换了个思路:先把查询通过embedding模型转成向量,再与缓存中的历史向量做相似度比较。如果相似度超过设定阈值,就认为两个问题「意思一样」,直接返回缓存答案。「What is the capital of France」「I would like to know the capital of France」「I want to know the capital of France」在向量空间里会靠得很近,因此都能命中同一条缓存。
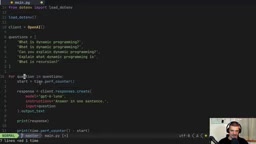
演示中先用一个不含缓存的基准脚本跑了五个问题,其中「What is dynamic programming」故意重复出现两次。结果显示每次请求耗时在2到4秒多不等,且两次相同问题的回答措辞也不完全一致——因为每次都是全新的推理。
Embedding与向量相似度是理解语义缓存的基础。Embedding模型(如OpenAI的text-embedding-3-small)将文本映射为一个高维稠密向量(通常数百到上千维),语义相近的文本在向量空间中的距离更近。衡量两个向量相似度的常用指标是余弦相似度(cosine similarity),即两向量夹角的余弦值,取值范围为-1到1,越接近1表示方向越一致、语义越相近。计算时通常先对向量做归一化,再用点积代替余弦计算以提升效率。演示中用NumPy矩阵乘法一次性算出当前向量与所有历史向量的相似度,正是利用了归一化后的点积等价于余弦相似度这一性质。
精确缓存的Python实现与它的天花板
在进入语义缓存之前,演示先用一个字典加SHA-256哈希实现了精确缓存。哈希的作用是把任意长度的查询压成固定长度的键,比直接拿原始字符串当键更规整。
效果非常直观:第一次「What is dynamic programming」正常推理,第二次命中缓存,耗时从秒级降到几乎瞬间(打印出来是极小的科学计数法数值),且返回的文本与第一次完全一致。
问题在于,除了那一条完全重复的查询,其他几个换了个说法的相似问题全部miss。「Can you explain dynamic programming」和「Explain what dynamic programming is」在语义上几乎等价,精确缓存却无能为力。这就是必须引入embedding的原因。
用NumPy手写语义缓存的核心逻辑
语义缓存的实现并不复杂,核心是维护两个平行的列表:一个存历史embedding,一个存对应的回答,通过索引关联。
每次新查询进来,先用OpenAI的text-embedding-3-small模型拿到向量,然后把历史embedding转成NumPy数组,与当前向量做矩阵乘法,一次性算出所有相似度。用np.argmax取出最相似的那条记录的索引,再读取对应的相似度值。
判断逻辑是:如果相似度超过阈值(演示中设为0.9),就返回缓存回答;否则走完整推理,并把新的embedding和回答分别追加进两个列表。
实际操作中有一个关键细节:只在产生原始回答时才写入缓存。如果命中了缓存还把复用的结果再写回去,缓存会被不断「污染」——每个新问题都可能与上一条足够相似,层层传递下去,最终可能把完全不同的查询匹配到错误的答案上。
跑通之后的效果:第一个问题冷启动耗时约2.9秒,完全重复的第二个问题相似度约为1(打印出来是接近1的数值,存在微小的数值误差),耗时降到0.14秒。「Can you explain dynamic programming」相似度0.933,「Explain what dynamic programming is」相似度0.92,都命中缓存。最后「What is recursion」相似度只有0.39,正常走推理,耗时约2秒。
缓存放大的风险值得单独说明。语义缓存不同于精确缓存,它的命中判断本身带有模糊性:如果每次命中都把复用的结果连同新查询的embedding再次写回,就会形成一条「语义漂移」的链条——A与B相似、B与C相似,但A与C可能已相距甚远。随着链条延长,缓存中会积累越来越多偏离原始意图的条目,最终把不相关的查询匹配到错误答案。因此写入操作必须与「是否真正调用了模型」绑定:只有冷启动产生原始回答时,才把当前的query embedding和answer落库,命中路径只读不写。这也是维持缓存质量最基本的一条纪律。
阈值调优:0.9是个不错的起点,但不是万能药
阈值是语义缓存里最需要反复试验的参数。演示专门写了一个调优脚本,用一组「陷阱问题」来测试不同阈值下的命中情况,包括应当命中的变体(如「explain dynamic programming」)和绝不该命中的近似问题(如「don't explain dynamic programming」「what is linear programming」「what is dynamic typing」)。
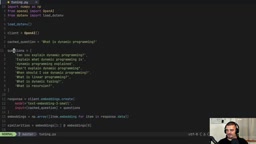
测试结果很说明问题:
- 0.6:过于宽松,「don't explain dynamic programming」被判为命中,但它的语义其实是否定的;「when should I use dynamic programming」也命中,返回的却是「什么是动态规划」而非「何时使用」。
- 0.7:同样糟糕,本该命中的「dynamic programming explained」反而miss了,而两个错误匹配依然存在。
- 0.8和0.9:主要差别在「when should I use dynamic programming」这一条,0.9更严格,表现更符合预期。
演示者的经验是:0.9是一个不错的默认值,具体取决于业务对准确性的要求有多严格。阈值越低召回越高但误答风险越大,越高越安全但缓存收益下降。
三类必须避开的缓存陷阱
语义缓存并不是万能加速器,有些场景用了反而会制造错误答案。演示中明确点出了几类高风险情况。
依赖上下文的对话。像「tell me more about this」「what do you mean by this」这类追问,正确答案完全取决于前文。如果把它们缓存起来,后续用户在完全不同的话题下问同样的话,就会拿到风马牛不相及的回答。
环境相关的查询。Windows用户和Linux用户问「how do I install something on my system」,答案理应不同。不区分环境就缓存,必然出错。
个人数据与时效性内容。「What's on my calendar」这类查询既绑定了具体用户,又随时间变化。哪怕十分钟后再问同一个问题,答案也应该更新。
TTL、淘汰与作用域:三个工程化手段
针对上面这些坑,演示给出了三种对应的工程手段。
TTL(生存时间)
给缓存条目设置过期时间,解决时效性问题。演示中把TTL设为5秒,连续三次问同一个问题、每次间隔3秒:第一次冷启动计算,第二次命中缓存,第三次因为距首次写入已超过5秒而被判定过期,重新计算。TTL的判断本质上是每次读取时做一次时间检查,确认条目是否仍然「新鲜」。
淘汰策略(Eviction)
限制缓存容量,满了就挤掉最老的条目。演示把最大容量设为2:依次问「what is dynamic programming」和「what is recursion」后缓存已满,再问「what is a hash map」时最老的动态规划条目被弹出。此后再问动态规划就会miss,而递归和哈希表仍在缓存中。
作用域(Scope)
把缓存按作用域隔离,避免不同上下文互相污染。演示中的两个作用域是「answer in one sentence」和「answer in one sentence in German」——同一个问题在不同作用域下使用不同的embedding池和缓存字典。这样用德语提问不会命中英语作用域下的缓存,反之亦然。
用Redis VL搭建接近生产的方案
前面所有实现都基于脚本内的字典和列表,进程一退出缓存就没了。演示最后用Redis VL(Redis Vector Library)展示了生产级做法。
安装redis-vl后,从redisvl.extensions.cache.llm导入SemanticCache类,从redisvl.utils.vectorize导入OpenAITextVectorizer。初始化时需要提供Redis连接地址(演示通过Docker在本地的6379端口启动Redis 8)、distance_threshold(注意这里是距离而非相似度,0.9的相似度门槛对应0.1的距离上限)、TTL以及向量化器实例。
读写接口很简洁:用cache.check()检查是否有匹配的历史prompt,命中则从返回结果的第一个元素里取response字段;未命中则正常调用模型,再用cache.store()把prompt和response写进Redis。
换成Redis后的运行结果与之前的列表实现完全一致——miss、hit、hit、hit、miss——说明语义匹配逻辑没有变化,只是存储从内存列表换成了可持久化、可跨进程共享的向量数据库。
Redis VL的SemanticCache底层依赖Redis的向量检索能力(如Redis Query Engine的向量索引),它把prompt向量存入索引,查询时执行最近邻(KNN)搜索并按距离阈值过滤。这与手写列表实现的「全量矩阵乘法」有本质区别:列表方案每次都要与所有历史向量比对,复杂度随缓存规模线性增长;而向量索引借助近似最近邻(ANN)算法,在海量条目下仍能保持较低的检索延迟,同时支持持久化、多进程共享和水平扩展。另一个易混点是距离度量:Redis VL默认使用余弦距离(1减去余弦相似度),所以相似度0.9对应距离0.1,阈值的比较方向与手写版本相反,配置时需格外留意,否则会出现「阈值调高反而更宽松」的反直觉现象。
什么场景值得用语义缓存
演示者对适用场景的判断相当克制。适合的包括:文档检索、内部支持机器人、大型商品目录的搜索引擎——这些场景的查询重复率高、对上下文的依赖低。
不适合的则是agent对话和高度依赖上下文的交互。换句话说,语义缓存是AI工程师工具箱里的一件利器,但前提是你能判断自己的业务形态是否匹配。用对了,它能把大量重复请求的响应时间从秒级压到毫秒级;用错了,它只会安静地返回错误答案。
相关推荐

llm-gemini 0.38.1 修复:Gemini 4 Hydrogen 与 Neon 新增 xhigh 推理级别
llm-gemini 0.38.1 修复了 Gemini 4 Hydrogen 和 Neon 缺失 xhigh 推理级别的问题。对比数据显示,xhigh 档位使 Hydrogen 的输出 token 与成本大幅上升,画面质量明显提升,达到可与 Neon 竞争的水平。
美SEC对英伟达展开调查:或涉会计问题
美SEC对英伟达展开调查:或涉会计问题
美国SEC对英伟达的调查聚焦潜在会计问题,而非产品本身。消息引发Hacker News热议,市场关注AI芯片巨头的财务披露质量与监管信号。

FBI犯罪数据库疑遭黑客攻击,特朗普回应“情况不妙”
FBI国家犯罪信息中心(NCIC)据报遭黑客攻击,FBI已展开调查,特朗普回应称“情况不妙”。本文梳理事件核心、NCIC数据库的重要性及执法数据安全面临的挑战。