月付8千的"AI SEO"值不值?没有可衡量数据就是收智商税
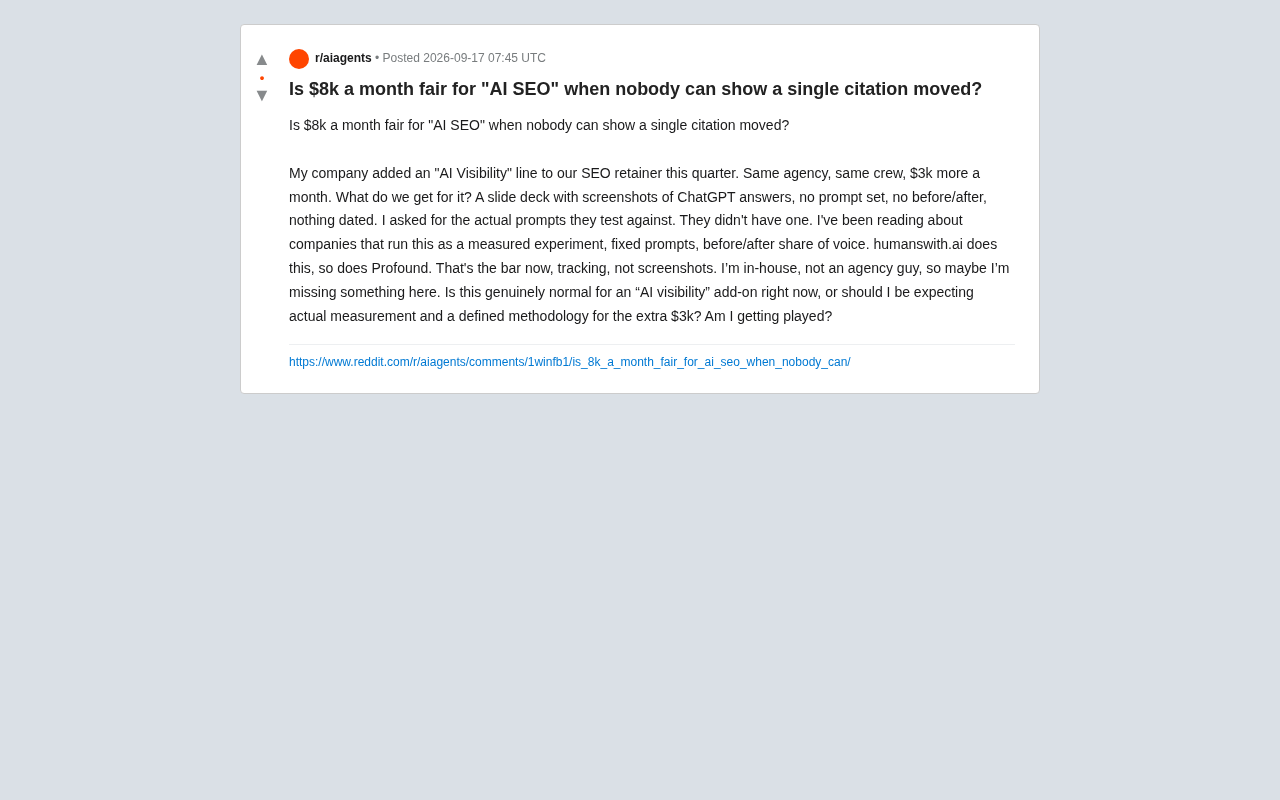
企业月付8千美元购买"AI可见度"服务,却只收到无方法论的ChatGPT截图,揭示GEO新兴赛道的交付乱象。
一位企业营销负责人在Reddit发帖质疑:同一家代理商在SEO合同中新增"AI可见度"服务,月费涨了3千美元,交付物却只是一堆没有提示词、没有日期、没有前后对比的ChatGPT截图。文章以此为切入点,系统梳理了"AI SEO/生成式引擎优化(GEO)"的衡量困境:大模型输出具有随机性,单张截图几乎没有证明力;严肃的做法必须包含固定提示词集合、定期采样、份额度量与时间戳记录。文章同时给出采购方的检验清单,指出Profound、humanswith.ai等工具所代表的"追踪份额"模式才是行业应有标准,并结论性地提醒:AI可见度是真实趋势,但趋势不等于免检,方法论是区分专业服务与营销话术的分水岭。
一场关于"AI可见度"的甲方拷问
一位企业内部营销负责人在Reddit上抛出了一个尖锐的问题:他所在的公司这个季度在SEO服务合同里新增了一条"AI可见度"(AI Visibility)服务,还是同一家代理商、同一批人,只是月费多了3千美元,总计达到8千美元。
问题在于——多付的这笔钱究竟买到了什么?答案令人失望:一份幻灯片,里面塞满了ChatGPT回答的截图,没有测试用的prompt集合,没有前后对比,甚至连一个日期标注都没有。当他要求对方提供实际测试所用的提示词时,代理商拿不出来。
这个帖子之所以引发共鸣,是因为它精准戳中了当下"AI SEO"或"生成式引擎优化"(GEO)这一新兴服务领域最混乱的一面:概念火热,交付标准却极度模糊。
截图不是方法论
发帖者的核心质疑非常专业:他不是在质疑"AI可见度"这件事本身没有价值,而是在质疑交付物的可衡量性。
他明确指出了自己期待的标准:固定的提示词集合(fixed prompts)、前后对比(before/after)、可追踪的"声量份额"(share of voice)。换句话说,AI SEO应该像一个可测量的实验来运行,而不是随手截几张对话框的图。
他提到自己读到过一些以严谨实验方式运营的做法,并点名了 humanswith.ai 和 Profound 这类工具,认为它们代表了行业应有的水准——"现在的标准是追踪(tracking),不是截图(screenshots)"。
这个判断是成立的。传统SEO之所以能形成成熟的服务市场,正是因为它有一整套可量化的指标体系:关键词排名、自然流量、点击率、转化。而AI可见度作为新赛道,如果连"用哪些prompt测试""测试频率如何""变化幅度多少"都说不清楚,那它本质上就是不可验证的。
Profound和humanswith.ai所代表的"AI可见度追踪"工具,其核心能力是对品牌在AI生成回答中的"声量份额"(Share of Voice)进行系统性监测。Share of Voice这一概念源自传统媒体广告监测,衡量的是某品牌在特定话题下的曝光比例相对于竞争对手的占比。迁移到AI场景后,它通常指:在一组预设的行业相关问题中,AI模型主动提及或推荐该品牌的查询比例。这与传统SEO的"关键词排名"逻辑类似,但统计单元从"页面位置"变为"模型回答中的提及率"。这类工具的价值在于提供可重复采样的基准数据,使优化动作(如更新官网内容、增加权威引用、完善结构化标注)与可见度变化之间的因果关系得以追踪和验证。
为什么"AI可见度"难以衡量
客观地说,AI SEO的测量确实比传统SEO更棘手,这也是乱象滋生的土壤。
ChatGPT、Claude、Perplexity等大模型的回答具有随机性,同一个问题在不同时间、不同上下文下的答案可能不同。这意味着单张截图几乎没有证明力——它只能说明"某一次某个模型提到了你",无法说明趋势,更无法归因到具体的优化动作。
正因如此,严肃的做法必须包含几个要素:
- 固定的提示词集合:用一组稳定、可复现的问题去反复查询,才能横向对比。
- 定期采样:多次运行取平均,抵消模型输出的随机性。
- 份额度量:不是看"有没有被提到",而是看在相关查询中被引用/推荐的比例变化。
- 时间戳与版本记录:模型会更新,没有日期的截图等于没有基准线。
缺少这套方法论,所谓的"AI可见度报告"就只是一份精心挑选的截图集,甚至可能是从成千上万次尝试里挑出对甲方最有利的那一张。
值得一提的是,主流AI产品在技术架构上的差异也加剧了衡量难度。ChatGPT、Claude、Gemini等模型各自拥有不同的训练数据截止日期、检索增强策略(RAG)和响应生成机制。部分产品(如Perplexity)会实时抓取网页内容,品牌能否被引用在很大程度上取决于该时刻被索引到的页面质量;而纯对话型模型则主要依赖预训练语料,品牌知名度、权威媒体覆盖和结构化数据标注(如Schema.org)的影响权重更高。这意味着"AI可见度"实际上是一个跨平台、跨机制的复合指标,无法用单一模型的截图来代表整体表现。专业的监测方案通常需要同时覆盖多个主流AI产品,并注明各自的版本号或API快照日期,否则数据之间根本无从对比。
3千美元到底该买到什么
回到发帖者最实际的诉求:多花的这3千美元,应该对应什么样的交付?
合理的期待清单应该是这样的:一份公开的提示词测试集(甲方有权知道测的是什么)、一条清晰的基准线(介入前的可见度水平)、周期性的追踪数据(而非一次性快照)、以及一套写明的方法论文档。如果代理商连"你们测哪些prompt"都答不上来,那基本可以判定其"AI可见度"服务尚未形成真正的工作流程,更像是蹭热点的溢价项目。
发帖者自称是甲方内部人员、非代理商出身,因此反复自我怀疑"是不是我漏掉了什么"。但从专业角度看,他的判断反而比很多从业者更清醒。在一个新概念爆发的窗口期,敢于要求"给我看方法论和数据"的甲方,恰恰是不容易被割韭菜的那一类。
给采购方的几点建议
对于正在考虑或已经购买"AI SEO / AI可见度"服务的企业,这个案例提供了几条可操作的检验标准:
- 索要提示词集合:如果对方拿不出固定的测试prompt,说明没有可复现的测量基础。
- 要求基准线与前后对比:任何优化都必须有"改动前"的数据作参照。
- 警惕纯截图交付:截图可以作为辅助展示,但绝不能是唯一的"成果"。
- 要求日期与采样频率:无时间戳的数据不具备可信度。
- 对标专业工具:Profound、humanswith.ai 等已经把"追踪份额"作为标准做法,可以用它们的输出形态作为衡量代理商的尺子。
这位发帖者的问题"我是不是被耍了?",答案其实已经写在他自己的观察里——当一项额外付费服务无法提供任何可衡量的证据时,付费方有充分理由要求方法论,而不是接受一沓漂亮的PPT。AI SEO是真实存在的趋势,但趋势不等于免检,衡量标准才是区分专业服务与营销话术的分水岭。
相关推荐
Cursor是什么?AI编程工具与传统IDE的核心区别
Cursor是什么?本文详解这款内置AI助手的编程工具,对比它与VS Code等传统IDE在代码补全、生成、重构、错误处理上的核心区别,并分析Cursor集成Claude、DeepSeek等大模型的特性及适用人群。
Coze扣子3.0入门指南:智能体与AI应用全景解析
Coze扣子3.0入门教程:解析字节跳动AI开发平台的智能体、AI应用、工作流与插件体系,涵盖单Agent与多Agent协作,并对比Coze与Dify的差异,帮助零基础用户快速搭建AI智能体。
DeepSeek Harness 环境搭建:Node.js 安装与配置全流程
零基础搭建 DeepSeek Harness 运行环境的完整教程,涵盖 Node.js 安装、Add to PATH 勾选、npm 全局目录与缓存目录迁移,以及系统环境变量配置全流程,附常见踩坑提示。