约束学习如何让科学建模更靠谱:CL4SM研讨会前瞻

NeurIPS 2026预会议CL4SM征稿,聚焦让机器学习模型真正遵守物理规律的约束学习方法。
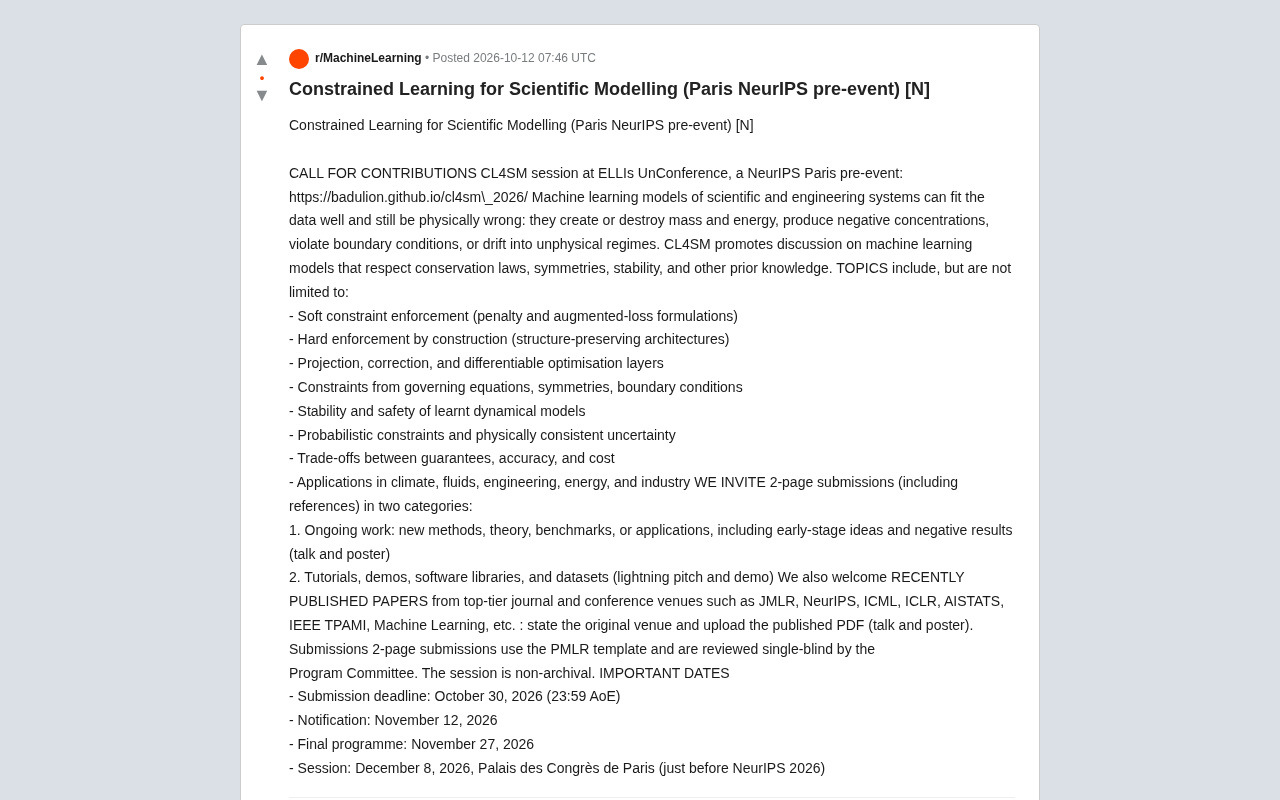
机器学习模型在科学工程领域可以拟合数据却违反物理规律,例如输出负浓度、违反能量守恒或在长期演化中发散。针对这一痛点,NeurIPS 2026巴黎预会议「约束学习与科学建模」研讨会(CL4SM)发起征稿,聚焦三条技术路线:通过惩罚项引导的软约束、通过结构保持架构实现的硬约束,以及将违规预测投影回合法解空间的可微优化层方法。研讨会特别强调约束保证、预测精度与计算成本之间不可回避的权衡,并覆盖气候、流体、能源等对物理一致性要求严苛的应用领域。投稿截止日期为2026年10月30日,会议定于12月8日在巴黎举行,接受两页短文及已发表论文,非存档性质。
机器学习在科学与工程建模中展现出强大的拟合能力,但一个长期被忽视的问题正逐渐浮出水面:模型可以把数据拟合得很好,却在物理上完全错误。它们可能凭空创造或消灭质量和能量,输出负的浓度值,违反边界条件,或者漂移到不符合物理规律的状态。针对这一痛点,巴黎NeurIPS预会议中的「科学建模约束学习」(Constrained Learning for Scientific Modelling,简称CL4SM)专题研讨会发起了征稿。
为什么科学建模需要「约束」
传统深度学习模型本质上是数据驱动的黑箱,它追求的是在训练集和测试集上的误差最小化。但在物理、气候、流体力学、能源等领域,一个模型的「正确」不仅取决于预测精度,更取决于它是否遵守基本的科学规律。
一个在数值上表现优秀的神经网络,如果预测出负的物质浓度,或者在模拟中让系统的总能量凭空增长,那么无论它的拟合误差多低,这个模型在实际应用中都是不可信的。更危险的是,这类违反物理约束的模型往往会在长时间演化或外推场景中「发散」,产生灾难性的错误。
CL4SM的核心主张正是推动机器学习模型尊重守恒定律、对称性、稳定性以及其他先验知识。这代表了科学机器学习(Scientific ML)领域一个重要的方向转变:从单纯追求拟合精度,转向在精度与物理一致性之间寻求平衡。
物理信息神经网络(Physics-Informed Neural Networks,PINN)是目前将物理约束引入机器学习最具代表性的框架之一,由Raissi等人于2019年在《Journal of Computational Physics》上系统提出。其基本思路是将偏微分方程(PDE)的残差作为额外损失项加入训练目标,使网络在拟合观测数据的同时满足方程约束。PINN的兴起极大推动了科学ML社区对「约束」问题的重视,但也暴露了软约束的固有局限:当PDE残差权重设置不当时,模型可能在物理约束与数据拟合之间产生梯度冲突,导致训练不稳定或约束实际上并未被充分满足。这正是CL4SM所讨论的更系统化约束方法论的出发点。
实现约束的三条技术路线
研讨会征稿的主题涵盖了当前约束学习的主要技术路线,大致可以归纳为三类思路。
软约束:通过损失函数引导
软约束(Soft constraint enforcement)是最直接的方法,通过惩罚项或增广损失(augmented-loss)的形式,把物理约束作为额外的损失加入到训练目标中。这类方法实现简单、灵活性高,但它只能「鼓励」模型遵守约束,无法提供严格的保证——模型在训练后仍可能出现小幅违反。
硬约束:从架构设计上保证
硬约束(Hard enforcement by construction)则更为彻底,通过设计结构保持型架构(structure-preserving architectures),让模型从数学结构上就无法违反约束。例如专门设计满足守恒律或对称性的网络结构。这类方法能提供严格保证,但往往限制了模型的表达能力,设计难度也更高。
结构保持型架构的典型代表包括:哈密顿神经网络(Hamiltonian Neural Networks)和拉格朗日神经网络(Lagrangian Neural Networks),它们通过学习系统的能量函数来保证能量守恒;辛积分器(symplectic integrators)将辛几何结构嵌入时间步进,确保相空间体积保持不变;以及等变神经网络(equivariant networks),通过群论约束使模型天然满足旋转、平移等对称性。这类方法的核心思路是:与其在训练时「惩罚」违规,不如让违规在数学上变得不可能。代价是模型的函数类被限制在一个更窄的子空间,对于不符合预设对称性的真实物理系统,表达能力会受到削减。
投影与可微优化层
介于两者之间的是投影(projection)、修正(correction)与可微优化层(differentiable optimisation layers)。这类方法在模型输出端加入一个修正步骤,把违反约束的预测「投影」回合法的解空间。可微优化层的出现使得这类修正可以端到端地参与训练,成为近年来的研究热点。
可微优化层(differentiable optimization layers)的代表性框架是 OptNet 和 cvxpylayers,它们将凸优化问题本身作为神经网络的一层,输入为网络中间特征,输出为满足约束的最优解,梯度可通过隐函数定理或KKT条件反向传播。这使得「把预测投影到合法解空间」这一修正步骤不再是独立的后处理,而是与整个模型端到端联合训练,约束的满足与预测精度可以同时被优化。物理信息神经网络(PINN)中的硬边界条件处理也属于类似思路——用满足边界条件的基函数重新参数化输出,使违反边界在结构上不可能发生。
不止方法,更关乎权衡
值得关注的是,CL4SM征稿主题中专门列出了「保证、精度与成本之间的权衡」(Trade-offs between guarantees, accuracy, and cost)。这反映出该领域研究者的成熟判断:没有一种约束方法是免费午餐。
硬约束提供了严格保证,却可能牺牲精度和增加设计复杂度;软约束灵活但缺乏可靠性;投影方法则引入额外计算开销。此外,研讨会还涵盖概率约束与物理一致的不确定性量化,以及学习动力学模型的稳定性与安全性——这些议题指向了约束学习在真实工业场景落地时必须面对的可靠性问题。
应用层面,征稿明确覆盖气候、流体、工程、能源与工业等领域,这些正是对物理一致性要求最严苛、同时数据驱动方法又最具潜力的场景。
投稿方式与重要时间节点
CL4SM作为ELLIS UnConference的一个专题,是NeurIPS 2026巴黎会议的预会议活动。研讨会接受两类两页篇幅的投稿(含参考文献):
- 进行中的工作:新方法、理论、基准或应用,包括早期想法和负面结果,以报告和海报形式呈现;
- 教程、演示、软件库与数据集:以闪电展示(lightning pitch)和演示形式呈现。
研讨会还欢迎已在JMLR、NeurIPS、ICML、ICLR、AISTATS、IEEE TPAMI等顶级期刊和会议发表的论文——投稿时注明原发表场所并上传已发表PDF即可。
投稿使用PMLR模板,采用单盲评审,由程序委员会审阅。需要注意的是,该研讨会为非存档性质(non-archival),这意味着投稿不影响论文日后在正式场所发表。
重要时间节点如下:
- 投稿截止:2026年10月30日(AoE时间23:59)
- 通知结果:2026年11月12日
- 最终日程:2026年11月27日
- 会议日期:2026年12月8日,地点为巴黎议会宫(Palais des Congrès de Paris),恰在NeurIPS 2026正式开幕前
对于从事科学机器学习、物理信息神经网络(PINN)、以及工程仿真方向的研究者来说,这是一个展示早期成果、交流约束学习方法论的高质量平台。详细信息可访问研讨会官网 badulion.github.io/cl4sm_2026 查看。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。