正则化强调时序差分学习:破解恒定步长下的稳定性难题
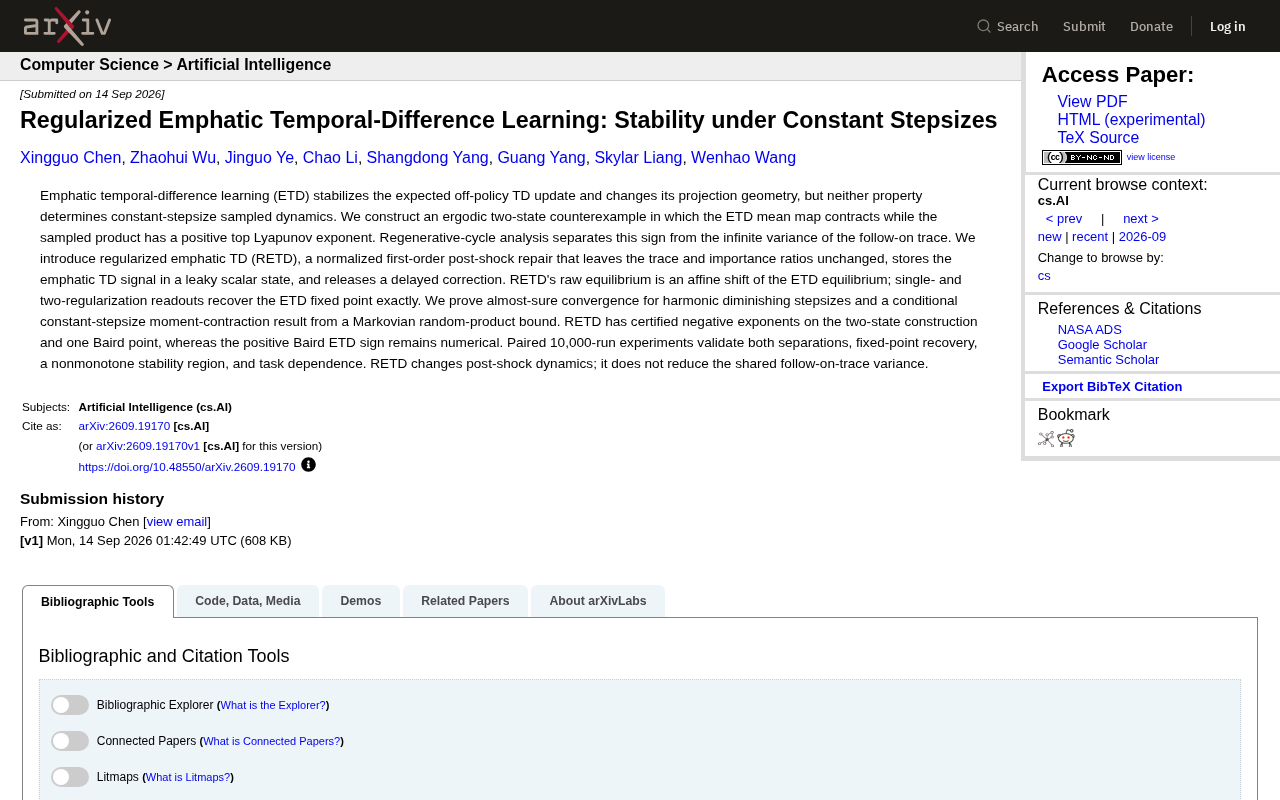
ETD期望稳定不等于采样稳定,RETD通过泄漏校正机制修复了这一理论漏洞
本文揭示了强化学习中强调时序差分学习(ETD)的一个隐蔽缺陷:尽管ETD能在期望意义上稳定离策略TD更新,但在恒定步长下的实际采样过程仍可能发散——两者是相互独立的稳定性问题。研究团队通过构造两状态遍历反例,证明ETD的均值映射具有收缩性质,但采样乘积的顶层李雅普诺夫指数为正,导致迭代发散。根源在于跟随迹的无穷方差,而再生周期分析将这一方差问题与李雅普诺夫指数问题区分开来。针对后者,论文提出RETD算法,通过泄漏标量状态延迟释放冲击后校正信号,在不破坏不动点的前提下实现了采样层面的稳定,并给出了递减步长下的几乎必然收敛证明及恒定步长下的矩收缩保证。
强化学习中的一个隐蔽难题
在离策略(off-policy)强化学习中,时序差分学习(Temporal-Difference Learning, TD)是价值函数估计的核心方法之一。然而,当行为策略与目标策略不一致时,标准TD算法可能出现发散现象。强调时序差分学习(Emphatic TD,简称ETD)被提出来稳定离策略TD更新的期望值,并改变其投影几何结构。
这篇发表于arXiv的研究(arXiv:2609.19170v1)指出了一个此前被忽视的关键问题:ETD虽然能稳定期望更新,但期望层面的稳定性并不能决定恒定步长(constant-stepsize)下的采样动态行为。换句话说,即便算法在"平均意义"上收敛,实际采样过程仍可能不稳定。
离策略学习与重要性采样:离策略强化学习的核心挑战在于,智能体用于收集数据的行为策略(behavior policy)与希望优化的目标策略(target policy)不同。为了修正这种分布偏移,算法通常引入重要性采样比率(importance sampling ratio)对更新进行加权。然而,这些比率可能随时间步累积,产生极高的方差,导致学习过程剧烈震荡。ETD通过引入"强调权重"(emphasis weight)重新分配各状态更新的重要性,从几何上改变了TD学习的投影方向,使得离策略更新在期望意义下对应一个收缩算子。这一设计的初衷是解决著名的"致命三角"(deadly triad)问题——即函数逼近、自举(bootstrapping)和离策略三者同时存在时TD可能发散的问题。李雅普诺夫指数的含义:顶层李雅普诺夫指数衡量的是线性随机迭代系统中误差的长期平均指数增长率,正值意味着迭代会以指数速度发散,负值则意味着稳定收缩。它捕捉的是"典型轨迹"的渐近行为,而非单次最坏情况,因此比谱半径更适合描述随机乘积的稳定性。
一个揭示矛盾的反例
研究团队构造了一个遍历(ergodic)的两状态反例,清晰地展示了这一矛盾。在该反例中,ETD的均值映射(mean map)表现为收缩性质——理论上应当收敛,但采样后的乘积却拥有正的顶层李雅普诺夫指数(top Lyapunov exponent),意味着实际的迭代过程会发散。
这一现象的根源在于跟随迹(follow-on trace)的无穷方差。作者通过再生周期分析(regenerative-cycle analysis)将李雅普诺夫指数的符号与跟随迹的无穷方差区分开来,说明这两者是不同的问题,需要分别处理。这一分析为理解ETD的失稳机制提供了新的理论视角。
**跟随迹(follow-on trace)**是ETD算法的核心辅助变量,用于累积折扣后的访问频率修正项,其递推形式为 $F_{t+1} = \gamma \rho_t F_t + 1$,其中 $\rho_t$ 为重要性采样比率,$\gamma$ 为折扣因子。在离策略场景下,当 $\rho_t$ 的波动较大时,$F_t$ 的乘积形式会导致其方差随时间步数增长而无界,即出现"无穷方差"现象。这与重尾分布中经典的矩不存在问题类似——序列的均值可能有限且稳定,但其二阶矩乃至更高阶矩会发散。再生周期分析(regenerative-cycle analysis)是概率论中分析马尔可夫链长期行为的经典工具:通过识别链的"再生时刻"(链返回某特定状态的时刻),将无限长的轨迹分解为独立同分布的周期片段,从而将渐近统计量归结为单个周期内的有限期望。本文利用这一框架,将李雅普诺夫指数的正负性与跟随迹的方差性质解耦,证明二者可以独立地呈现稳定或不稳定状态,为后续分别设计针对性修复方案奠定了理论基础。
RETD:正则化的修复方案
针对上述问题,论文提出了正则化强调时序差分学习(Regularized Emphatic TD,RETD)。它的核心思路是一种归一化的一阶"冲击后修复"(post-shock repair)机制,具有几个关键特性:
- 保持迹与重要性比率不变:RETD不改动跟随迹和重要性采样比率,避免引入额外偏差;
- 泄漏标量状态存储信号:将强调TD信号存储在一个泄漏的标量状态(leaky scalar state)中;
- 延迟释放修正:通过延迟机制释放校正信号,从而稳定冲击后的动态。
值得关注的是不动点的恢复问题。RETD的原始平衡点是ETD平衡点的仿射平移(affine shift),而通过单正则化和双正则化读出(single- and two-regularization readouts),可以精确恢复ETD的不动点。这意味着RETD在稳定性与解的正确性之间取得了平衡——既修复了动态不稳定,又不牺牲原算法的目标解。
"冲击后修复"机制的直觉:在随机迭代系统中,参数更新序列可以看作一系列随机矩阵的乘积。当某个时间步出现极端的重要性采样比率时,相当于系统受到一次"冲击"(shock),使参数值大幅偏离。RETD的思路不是阻止冲击发生,而是在冲击之后通过一个附加的标量状态缓慢地释放校正信号,将过激的更新"平滑摊销"到后续多个时间步中。"泄漏"(leaky)一词描述的是该标量状态会以一定衰减率逐渐归零,类似于电容放电,从而避免历史冲击信号的无限积累。仿射平移与不动点恢复:正则化通常会改变算法的不动点——例如L2正则化会将最优解向原点偏移。RETD引入的正则化项使得其自然平衡点是ETD平衡点的仿射(线性+常数)平移,而非原始不动点。论文通过在读出阶段施加相应的逆变换(单正则化或双正则化读出),精确抵消这一偏移,从而在获得稳定性的同时保证解的无偏性,避免了常见"稳定性-精确性"权衡的困境。
理论保证与实验验证
在理论层面,论文给出了两类收敛性结果:
- 递减步长下的几乎必然收敛:对于调和递减步长(harmonic diminishing stepsizes),证明了RETD几乎必然(almost-sure)收敛;
- 恒定步长下的条件矩收缩:基于马尔可夫随机乘积界(Markovian random-product bound),给出了条件性的恒定步长矩收缩结果。
在具体构造上,RETD在两状态反例和一个Baird点上均实现了经过认证的负李雅普诺夫指数(即稳定),而Baird反例中ETD的正指数符号目前仍停留在数值层面。
实验方面,研究进行了成对的1万次运行(10,000-run)对比实验,验证了多项结论:两种分离现象的存在、不动点的精确恢复、一个非单调的稳定区域(nonmonotone stability region),以及任务依赖性(task dependence)。
方法的边界与意义
论文也坦诚地指出了RETD的局限:它改变的是冲击后的动态行为,但并不能降低共享的跟随迹方差。这与前文的再生周期分析呼应——跟随迹的无穷方差是一个独立的问题,RETD解决的是李雅普诺夫指数符号问题,而非方差问题。
这项工作的价值在于,它厘清了离策略TD学习中长期被混淆的两个概念:期望层面的稳定性与采样层面的稳定性。对于强化学习理论研究者而言,这一区分有助于更精确地分析算法在实际部署中的行为;对于算法设计者而言,RETD提供了一种在不破坏原有理论保证前提下增强稳定性的实用思路。
非单调稳定区域和任务依赖性的发现也提醒实践者:在使用ETD类算法时,步长的选择需要更加谨慎,简单地依赖期望收敛性可能导致意外的发散。
相关推荐
AAAI-27第一阶段评审结果临近:投稿者需关注什么
AAAI-27第一阶段(Phase 1)评审结果预计9月24日公布,本文解读AAAI分阶段评审机制、投稿者应对策略以及学术社区在结果等待期的协作价值。
FAISS向量搜索实战入门:从Embedding到RAG的踩坑心得
一位开发者分享FAISS向量搜索的实战入门心得,讲解从Embedding到RAG的完整数据流,并深入探讨人名、日期、过滤条件和对话历史等真实场景下的检索难点与应对方案。
H3 Camera Control v3来袭:视频镜头控制与快速渲染上线
H3 Camera Control v3更新预告发布,将带来视频镜头控制与快速渲染两项核心升级,提升AI视频创作的可控性与效率。本文解读新功能方向与行业意义。