支持向量机(SVM)核心概念与Python代码实战
SVM通过最大间隔、软间隔与核技巧实现非线性分类,并用Python代码演示多项式核。
本文基于StatQuest讲解,系统介绍支持向量机(SVM)的核心概念与实战应用。从一维阈值分类的局限性出发,引出最大间隔分类器及其对异常值的敏感性,进而引入软间隔和支持向量分类器,通过允许误分类实现偏差-方差权衡。针对非线性问题,SVM利用核函数将数据映射到高维空间,核技巧避免实际升维计算,提升效率。最后通过Python代码在糖尿病数据集上演示多项式核SVM的完整流程,包括标准化、模型训练、评估和决策边界可视化,并验证手动升维与核技巧的等效性。
支持向量机(SVM)是机器学习中经典且强大的分类算法,但它的诸多术语和数学直觉常让人望而却步。本文基于StatQuest的讲解,从一维阈值分类的局限性出发,逐步引出最大间隔分类器、软间隔、核函数与核技巧,最后通过Python代码演示多项式核SVM的完整流程。
从阈值分类到最大间隔分类器
想象我们测量了一群小鼠的体重,红色代表非肥胖,绿色代表肥胖。最直接的做法是选一个阈值,体重超过阈值判为肥胖。但这种方法对临界样本极不稳定:一个体重略高于阈值但更接近非肥胖群体的新样本会被误判。
改进思路是关注两类数据边缘的观测点,将阈值放在它们的中点。此时阈值到最近观测点的距离称为间隔(margin)。当阈值位于中点时,间隔最大化,这样的分类器称为最大间隔分类器(maximal margin classifier)。
然而,最大间隔分类器对训练数据中的异常值极度敏感。一个被错误标记的离群点会大幅拉偏阈值,导致新数据分类表现糟糕。
软间隔与支持向量分类器
为降低对异常值的敏感度,我们允许部分误分类,选择一条不那么激进的阈值。此时观测点到阈值的距离称为软间隔(soft margin)。允许误分类本质上是在做偏差-方差权衡:牺牲少量训练集精度(提高偏差),换取更好的泛化能力(降低方差)。
如何确定软间隔的宽度?答案是用交叉验证(cross-validation):尝试多种划分方式,看哪种在验证集上表现最好。
位于软间隔边缘及内部的观测点被称为支持向量(support vectors),这也是支持向量分类器名称的由来。
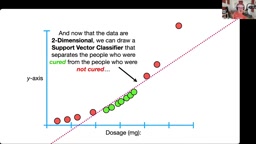
当数据从一维(体重)扩展到二维(体重+身高),支持向量分类器从点变为线;三维时变为平面;更高维时则称为超平面(hyperplane)。数学上统一称为平坦仿射子空间。
偏差-方差权衡是机器学习模型设计的核心原则之一。偏差衡量模型预测值与真实值的偏离程度,高偏差意味着模型过于简单,无法捕捉数据中的复杂模式,导致欠拟合;方差衡量模型对训练数据微小变化的敏感度,高方差意味着模型过于复杂,容易记住训练集中的噪声,导致过拟合。软间隔SVM通过引入松弛变量允许部分样本被误分类,从而在训练精度(偏差)和泛化能力(方差)之间取得平衡。类似地,正则化方法(如L2正则化)通过惩罚模型复杂度来控制方差,集成方法(如随机森林)通过平均多个模型来降低方差。理解这一权衡有助于在实际问题中合理调整模型复杂度,避免过拟合或欠拟合。
支持向量机:升维解决非线性问题
支持向量分类器能处理一定重叠,但面对大量重叠的数据(例如药物剂量与治愈率呈U型关系)就无能为力了。此时需要支持向量机(SVM)。
SVM的核心思路是:将低维数据通过某种变换映射到高维空间,在高维空间中找到线性分类器。例如,对剂量数据增加一列“剂量的平方”作为y轴,一维数据就变成了二维,原本非线性可分的数据在二维空间中可以用一条直线分开。
这个变换并非随意选择,SVM使用**核函数(kernel function)**系统化地完成映射。常用的有多项式核(通过参数d控制多项式阶数)和径向基核(RBF核,对应无限维空间)。
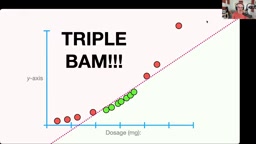
关键在于核技巧(kernel trick):核函数只计算高维空间中点与点的关系,而不实际执行变换。这使得计算在低维数据上完成,却等效于高维甚至无限维空间中的运算,极大提升了效率。
核函数的选择直接影响SVM的性能,常用的核函数包括线性核、多项式核、径向基核(RBF核)和Sigmoid核。线性核适用于线性可分或近似线性可分的数据,计算简单且解释性强;多项式核通过参数d控制映射的维度,能够捕捉特征间的交互关系,但当d较大时数值稳定性可能变差;RBF核将样本映射到无限维空间,具有很强的非线性拟合能力,是许多场景下的默认选择,但其参数gamma需要仔细调优。此外,核函数必须满足Mercer条件,即对应的核矩阵是半正定的,这保证了优化问题存在全局最优解。在实际应用中,通常通过交叉验证比较不同核函数及参数的性能,并结合数据规模和特征维度进行选择。
Python代码实战:多项式核SVM
下面用scikit-learn在糖尿病数据集上演示SVM。数据包含血糖和血压两个特征,目标变量为是否患糖尿病。为便于可视化,仅使用血糖一个特征。
首先加载数据并划分训练集/测试集,然后进行标准化。标准化用训练集的均值和标准差,避免数据泄露。
from sklearn.preprocessing import StandardScaler
from sklearn.svm import SVC
from sklearn.metrics import confusion_matrix, accuracy_score
from sklearn.model_selection import train_test_split

X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
使用多项式核,设置degree=2、coef0=0.5,拟合训练数据:
svm_poly = SVC(kernel='poly', degree=2, coef0=0.5)
svm_poly.fit(X_train_scaled, y_train)
y_pred = svm_poly.predict(X_test_scaled)
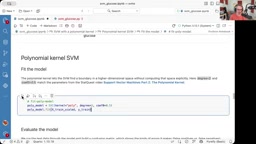
评估结果显示准确率约68%。考虑到数据重叠严重,这个结果不算太差。
由于核技巧不实际保存变换后的坐标,我们手动构造“血糖平方”列,再用线性核拟合,以可视化分类边界。线性核模型与多项式核模型得到完全相同的混淆矩阵和准确率,验证了核技巧的等效性。
手动计算斜率与截距后,可绘制抛物线状的数据分布和线性分类边界。最终模型将所有位于红线下方样本判为0,上方判为1。
完整代码可在GitHub获取,配合StatQuest视频学习效果更佳。
在SVM中,标准化(StandardScaler)是至关重要的预处理步骤,因为SVM的优化目标依赖于样本点之间的欧氏距离,若特征尺度差异较大,距离计算会被数值范围大的特征主导,导致分类边界偏离。标准化将每个特征转换为均值为0、标准差为1的分布,消除量纲影响。需要注意的是,必须仅在训练集上调用fit_transform计算均值和标准差,然后对测试集使用相同的参数进行transform,否则测试集的信息会泄露到训练过程中,造成过于乐观的性能评估。此外,对于核函数中的参数(如多项式核的degree、coef0,RBF核的gamma)以及惩罚系数C,应使用交叉验证网格搜索进行调优,而非依赖默认值。
核心要点
- 最大间隔分类器对异常值敏感,软间隔通过允许误分类提升泛化能力
- 核技巧在不实际升维的情况下计算高维关系,兼顾效率与表达能力
- 多项式核的degree参数控制映射维度,需通过交叉验证选择
- 标准化应在训练集上fit、测试集上transform,防止数据泄露
- 手动升维+线性核可还原SVM决策边界,便于可视化理解
SVM的术语繁多,但核心逻辑始终如一:当低维空间无法线性分割时,升维寻找线性边界。核技巧让这一过程在计算上可行。
相关推荐
Jon Krohn对话:LLM如何重塑数据科学家的价值
Super Data Science主播Jon Krohn与Josh Starmer、Luis Serrano对谈:LLM如何让二十年技术积累失去护城河,数据科学家和工程师的价值应转向上下文提供、商业理解和智能体编排。
Vergecast 电子书库技巧:多张虚拟借书证与 Kobo 整合
Vergecast 播客分享电子书库构建技巧:优先直接购买支持作者与独立书店,利用多张虚拟借书证通过 Libby、Overdrive 扩大图书馆借阅,Kobo 阅读器深度整合图书馆资源并支持多证管理。
GRPO强化学习详解:让大模型学会推理的组相对策略优化
深入解析GRPO强化学习算法:组内相对优势如何计算、损失函数中的截断与重要性采样比率如何运作、KL散度约束的作用,以及GRPO相比PPO在训练成本上的优势,附逐轮迭代的数学推演。