GRPO强化学习详解:让大模型学会推理的组相对策略优化
GRPO用同题组内相对比较替代价值网络,以标准化优势和截断机制高效优化推理能力。
文章以 StatQuest 的极简讲解为基础,系统梳理了 GRPO 的原理与工程细节。GRPO 的核心是用同一提示下生成的一组回复互相比较来构造优势,避免训练与策略同规模的价值网络,从而显著降低显存与工程复杂度。流程包括高温采样一组回复、任意评分、组内标准化得到优势、代入损失反向传播。作者重点拆解了损失函数:截断把优势缩放限制在 [1-ε,1+ε],正优势放大、负优势拉近零;首轮迭代比率恒为1、损失为0,缩放从第二轮才生效;KL 项约束新旧分布距离,权重可调低甚至为零。最后强调奖励尺度不重要,但组内区分度和采样温度需配合,否则优势趋零、梯度失效。
GRPO(Group Relative Policy Optimization,组相对策略优化)是近年来在大模型推理能力训练中备受关注的一种强化学习算法。它绕开了传统PPO方法中需要单独训练价值网络(critic)的麻烦,用同一提示下的一组回复互相比较来构造优势信号。StatQuest的Josh Starmer用极简的数学例子把GRPO拆解得相当清楚,下面结合他的讲解,把这套方法的核心逻辑与工程细节完整梳理一遍。
为什么需要GRPO:从组内比较说起
GRPO的核心动机可以用一句话概括:与其训练一个额外的价值模型去估计“这个回答有多好”,不如直接让模型对同一个问题生成一组回答,然后组内互相比一比。在这种设计下,优势函数不再依赖绝对基准,而是相对同组其他回复来计算,这正是“G”(Group)与“R”(Relative)的含义。
具体流程分四步:对每个训练提示,用较高的温度值生成一组回复;用任意评分机制(计算器或更强的模型)给每个回复打分;把组内奖励标准化,得到优势值;把优势值代入GRPO损失函数,通过反向传播做策略优化。
温度参数的设置是这套流程的前提。当温度设为1时,模型输出的多样性明显高于低温设置,这正是GRPO需要一组不同回复(有的正确、有的错误)的原因。温度越高,低概率词元的采样机会越大,组内样本的差异性也就越充分。
温度(Temperature) 是大模型生成时的采样参数,它作用于模型输出的 logits:先除以温度系数 T,再经 softmax 得到概率分布。T=1 时保持模型原始分布;T<1 会锐化分布,使高概率词元更易被选中,输出更确定、更保守;T>1 则压平分布,让低概率词元获得更大采样机会,输出更随机多样。GRPO 需要一组有对有错的回复才能构成有效比较,因此通常把温度调高(如 0.8~1.2),以保证组内存在足够的差异性。温度过低会导致组内回复高度相似、优势趋近于零,梯度信号消失。
为什么奖励值本身不重要:标准化与优势
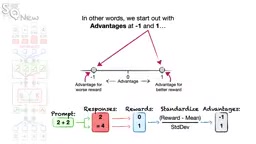
Josh Starmer用一个只有四个词元(2、+、=、4)的玩具语言模型演示整个过程。评分规则是答对得1、答错得0,但视频中特别强调:奖励的具体数值几乎不影响结果,因为紧接着要做标准化。
$$\hat{A}_i = \frac{r_i - \text{mean}(r)}{\text{std}(r)}$$
标准化之后,组内较好回答得到正优势,较差回答得到负优势,中心在零。视频里用了几组不同奖励值演示:奖励为0和1、为-2和-1、为-0.5和1.5时,标准化后的优势都是-1和1。也就是说,只要好回答的奖励高于差回答,标准化就会自动把优劣拉开,工程上无需纠结奖励尺度怎么定。
这一设计对实际训练很有价值。奖励信号可能来自规则校验、代码沙箱执行结果或另一个模型的打分,量纲差异很大,但经过组内标准化后都可以进入同一套优化框架。
GRPO损失函数的逐项拆解
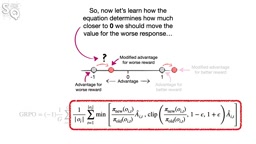
完整公式看起来复杂,但可以先抓住主干。视频中把损失函数分解为三层:第一层是截断函数(clip),把优势的缩放倍数限制在 $[1-\epsilon, 1+\epsilon]$ 区间内,$\epsilon$ 通常取0.1或0.2;第二层是重要性采样比率,即当前策略与旧策略对同一词元的概率之比;第三层是对词元平均、对组内回复平均,最后取负号得到损失。
截断的直观含义是:放宽正优势的放大空间,同时约束负优势的缩放幅度。也就是说,模型被鼓励进一步强化好回答,但对差回答的惩罚有上限,避免一次更新把概率分布拉得太远。
第一轮迭代的“空转”现象
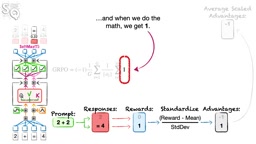
一个容易让人困惑的细节是:在刚初始化、尚未更新任何参数时,当前策略与旧策略完全相同,比率处处为1。由于1落在 $[1-\epsilon, 1+\epsilon]$ 内,截断函数原样返回1,优势不被缩放。视频中算出的结果是:两个回复的优势分别为-1和1,平均后为0,损失也是0。
这并不矛盾。损失为0只是当前参数点上的取值,通过对参数求导、沿梯度下降方向移动,损失可以继续降到负值。GRPO的缩放效果要到第二轮才真正显现——此时比率开始偏离1。
第二轮:比率开始偏离1
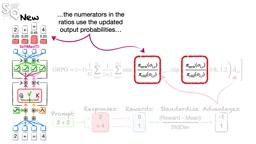
参数更新后,模型对“2”这个错误回答的概率从0.24降到0.20,比率变为0.83;对正确回答中“=”的概率从0.22升到0.45,比率达到2.05,超过上界后被截断为1.2。视频还处理了多词元的情况:第二个回复包含“=”和“4”两个词元,它们来自不同的条件概率分布,需要分别计算比率再取平均。
结果是:差回答的优势从-1被拉近到-0.83,好回答的优势被放大到1.17,平均后损失为-0.17。损失从0降到-0.17,说明优化在推进。这个数字演变的路径,恰好对应了GRPO“压制错误路径、强化正确路径”的训练动力学。
重要性采样比率(importance sampling ratio) 是 PPO 系列算法的核心构件,定义为当前策略与行为策略(即采样数据时的旧策略)对同一动作的概率之比 $\rho = \pi_\theta(a|s) / \pi_{\theta_{old}}(a|s)$。它用于修正“数据由旧策略采集、却用新策略优化”带来的分布偏移,使离策略(off-policy)更新在期望上无偏。比率大于 1 表示新策略更倾向该词元,小于 1 则相反。GRPO 沿用这一机制,但把动作粒度落到词元上,并对多词元回复逐词元计算后取平均。
KL散度项:别让模型跑太偏
公式中还有一个常被忽略的KL散度项,用于度量整个原始概率分布与新分布之间的距离,而不仅是单个词元的概率差异。理论上,GRPO只应做细微调整,不应把原本的语言能力大幅改写,KL项就是施加这一约束的“缰绳”。视频提到,实践中这一项在损失函数中的权重影响可以调低甚至设为零,是否启用取决于具体训练目标。对希望保留基座模型广泛能力的场景,这一项值得保留并仔细调参;如果目标只是单纯的推理能力强化,放松约束也能工作。
KL 散度(Kullback-Leibler divergence) 衡量两个概率分布之间的差异,定义为 $D_{KL}(P|Q)=\sum_x P(x)\log\frac{P(x)}{Q(x)}$,恒为非负,两分布完全相同时取 0。在强化学习微调中,通常把当前策略与参考策略(原始基座模型)之间的 KL 散度作为惩罚项加入损失,防止模型为追逐奖励而过度偏离原有语言分布,导致输出退化或奖励作弊。工程上常采用逐词元近似估计(k1/k2/k3 估计器)以降低计算开销,并用一个系数 $\beta$ 控制约束强度。
几点实践层面的观察
GRPO相比PPO的最大收益在于显存与工程复杂度:不再需要与策略模型同规模的价值网络,训练成本明显下降,这也是它在推理模型训练中被广泛采用的重要原因。组大小的选择则是一个权衡——组越大,标准化后的优势估计越稳定,但采样成本同步上升。
另一个容易被低估的细节是奖励设计的质量。由于标准化会消除量纲差异,奖励函数可以相对自由地组合规则校验与模型打分,但组内奖励若区分度不足(比如全部正确或全部错误),标准化后优势会趋近于零,这一批样本就贡献不了有效梯度。因此采样温度与题目难度分布需要配合调整,保证组内存在对错混合。
从方法论角度看,GRPO把“如何评估一个回答好不好”这个难题,转化成了“同一问题下哪个回答相对更好”的排序问题,用相对比较替代绝对打分,这正是它简洁而有效的根源。
相关推荐
Azure HorizonDB+VS Code:AI应用开发新工作台
Azure Horizon DB 是微软企业级 Postgres 服务,与 VS Code 深度整合:GitHub Copilot 写 SQL、可视化查询计划、内置向量索引与 AI 模型,数据库运维与 AI 应用开发在同一工作台完成。

苹果为macOS加装AI安全阀:新权限控制如何应对智能体隐私风险
苹果披露macOS 27.3全新Mac安全控制:针对AI智能体的细粒度权限、运行时警告与操作透明度功能,如何应对智能体动态访问敏感数据的隐私风险,以及对开发者和用户的影响分析。

民主党挡不住数据中心?美国最大核电商不担心
Constellation Energy CEO Joe Dominguez在财报电话会上表示不担心民主党放缓数据中心开发,本文分析核能行业为何对数据中心电力需求保持长期信心,以及政治周期与基础设施投资之间的博弈。