智能体开发核心课:Python+大模型Agent实战路径
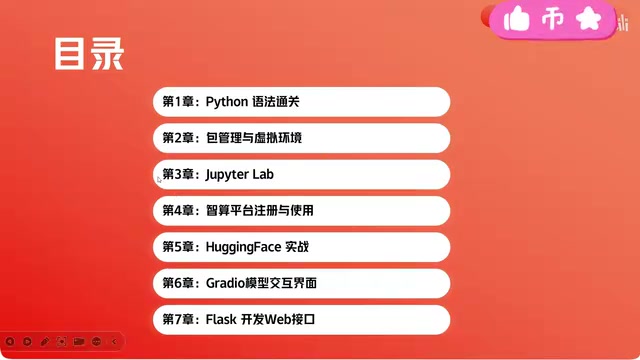
B站智能体课用七章串起从Python环境到模型对外服务的完整开发链路。
文章拆解了B站一门智能体开发核心课的七章结构:前三章补Python语法、包管理、虚拟环境与Jupyter,解决依赖冲突与调试环境问题;第四章用智算平台绕开高端显卡门槛并统一运行环境;第五章以Hugging Face为入口练习模型检索、下载与使用;最后两章分别用Gradio搭建交互界面、用Flask提供对外API,完成从Demo到产品的交付。文章认为这套路径的核心价值在于“先跑通全链路、再深挖细节”,适合希望建立完整认知的入门者,已有Python基础者可略过前三章,聚焦算力、模型社区与交付三部分。
大模型智能体(Agent)开发的门槛,往往不在算法本身,而在"环境"与"链路"。B站上一门智能体开发核心课把这层窗户纸捅破了:它没有一上来就讲复杂的Agent框架,而是用七个模块把从Python语法到模型对外服务的完整闭环走了一遍。对于想动手做大模型应用、却卡在环境配置和工具链上的开发者来说,这套路径值得拆开来看。
为什么先补Python和虚拟环境
课程的前三章全部落在Python基础上:快速通关语法、掌握包管理与虚拟环境、熟悉Jupyter Notebook。这个安排看似"退步",实则切中了大模型开发的真实痛点。Agent项目通常依赖大量第三方库,版本冲突是家常便饭;虚拟环境管理不好,一个项目跑通、换一个就崩。Jupyter则承担了实验与调试的角色,模型调用、提示词迭代、中间结果检查都在这个交互式环境里完成。
把这三块打牢,后面所有环节才有稳定的运行底座。很多教程跳过这一步直接讲框架,学员复制代码后报错连连,根源往往就在这里。
虚拟环境是Python中用于隔离项目依赖的机制。不同项目可能依赖同一库的不同版本,若全部装在系统全局环境里,版本冲突几乎无法避免。venv、conda 等工具可以为每个项目创建独立的解释器和包目录,安装的库只对该项目可见。对大模型项目而言,transformers、torch、gradio 等库版本迭代快、相互依赖复杂,虚拟环境几乎是必备基础设施。
Jupyter Notebook 是一种以“单元格”为单位的交互式编程环境,代码可以分块执行,变量在内存中保持,输出(文本、表格、图片)直接显示在代码下方。它特别适合模型调用的探索性工作:改一次提示词就能立刻看到结果,无需反复运行整个脚本。
智算平台:没有高端显卡也能跑大模型
第四章引入智算平台,解决的是算力门槛问题。本地机器没有高端显卡,照样可以通过云端算力调用各种大模型,同时消除不同电脑之间的环境差异——同一份代码在队友机器上跑不起来的情况会大幅减少。
这一点对学习者和中小团队尤其关键。大模型推理对显存的要求把不少人挡在门外,而智算平台把"买卡"变成了"租用",试错成本明显下降。课程把它放在模型实战之前,逻辑上是为了让后续的模型下载与调用有一个统一的运行环境。
显存(VRAM) 是决定能否本地运行大模型的关键指标。模型权重以参数形式常驻显存,粗略估算,FP16精度下每10亿参数约占2GB显存,因此一个70亿参数模型仅加载就需十几GB,再加上推理时的中间激活值,消费级显卡往往不够用。智算平台通过GPU租赁的方式提供A100、V100等专业卡,按小时计费,让开发者无需一次性投入数万元购置硬件。
常见的智算平台通常提供预装环境镜像、Jupyter入口和持久化存储,相当于把本地开发体验搬到了云端。
Hugging Face:大模型界的GitHub
第五章进入Hugging Face实战。课程把它比作"大模型界的GitHub",这个类比相当准确:社区里有大量公司和个人爱好者上传分享的各种模型,开发者可以直接检索、下载、试用,而不必从零训练。
对Agent开发而言,Hugging Face的价值不只是模型仓库,更是理解模型生态的入口——不同参数规模、不同任务类型的模型如何选择,模型卡片怎么读,权重怎么加载,这些实操经验都从这里积累。课程将其列为独立一章,说明作者认为"找模型、用模型"本身就是一项需要专门练习的技能。
模型卡片(Model Card) 是Hugging Face上每个模型附带的说明文档,通常包含模型简介、训练数据、适用与不适用场景、偏见与风险提示、使用示例代码。学会读模型卡片,是判断一个模型能否用于自己任务的第一步。
Hugging Face的核心工具库是 transformers,它提供统一的 from_pretrained() 接口加载模型权重和分词器,屏蔽了不同模型架构的差异;配套的 datasets 库负责数据加载,spaces 则允许直接在网页上托管和体验Demo。国内网络访问Hugging Face可能受限,实践中常使用镜像站(如 hf-mirror)或通过 HF_ENDPOINT 环境变量指定镜像地址。
Gradio与Flask:让模型有界面、能对外服务
最后两章转向交付。第六章用Gradio开发大模型的交互界面,把命令行里的模型调用变成可点击、可输入的网页应用,适合快速验证和演示;第七章用Flask开发大模型的对外接口,让模型以API形式对外提供服务,这是把Demo变成产品的关键一步。
Gradio偏向前端交互的快速搭建,Flask偏向服务端的接口设计,两者结合正好覆盖了从"自己用"到"给别人用"的过渡。课程的说法是,掌握这七章内容,AI生态的核心流程就全部演练通过了,剩下的细节边用边学即可。
Gradio 的核心是 Interface 和 Blocks 两种构建方式:前者用几行代码把函数映射为输入框和输出框,后者支持更灵活的多组件布局。它的典型用法是把“接收用户输入→调用模型→返回结果”包装成一个函数,Gradio自动生成网页界面,并通过 launch() 启动本地或公网服务。
Flask 是轻量级Python Web框架,通过路由装饰器(如 @app.route('/chat', methods=['POST']))把HTTP请求映射到处理函数。把模型推理封装成REST API时,需要注意请求体解析、返回JSON格式、超时控制和并发处理——单进程Flask默认串行处理请求,面对真实流量需配合gunicorn等WSGI服务器部署。
这套路径适合谁
从课程结构看,它面向的是希望快速建立完整认知的入门者,而非深耕某一框架的进阶开发者。七章内容覆盖语法、环境、算力、模型社区、界面、接口,形成一条可运行的链路,每一环都能独立产出可见成果。这种"先跑通、再深挖"的思路,比一上来啃Agent框架论文更务实。
需要说明的是,课程以视频形式发布,配套资料通过私信方式获取,具体内容细节需以实际课程为准。对于已经熟悉Python的开发者,前三章可以快速略过,把时间集中在智算平台、Hugging Face和Gradio/Flask这三段上。
智能体开发的门槛正在从"会不会写代码"转向"会不会把整条链路串起来"。这门课的价值,恰恰在于把这条链路完整地演示了一遍。
相关推荐
别急着让AI写代码:4个Skills把设计变成可执行任务
20年经验工程师分享:AI编程时代人类该专注设计与规划,而非写代码。用architecture.md锚定架构,配合设计、架构评审、HTML文档、规划四大Skills,把技术方案自动拆解为可执行任务,提升软件开发质量。
AI革命早期史:谷歌、马斯克与那场改变一切的竞赛
从谷歌收购DeepMind到ChatGPT的意外爆红,The Vergecast访谈Kevin Roose新书,揭秘AI革命早期那些改变世界的决定:谷歌为何错失先机、数据原罪如何形成、以及AGI定义之争。
恐怖模式下的Gmod TTT:吸血鬼与狼人新角色实测
Yogscast万圣节特别版Gmod TTT实测:吸血鬼转化机制、狼人银弹弱点、法国人法棍穿墙击杀,以及角色轮抽带来的策略变化。附对局中的平衡性反馈。