智能体系统的授权该发生在哪一层?执行边界的安全思考
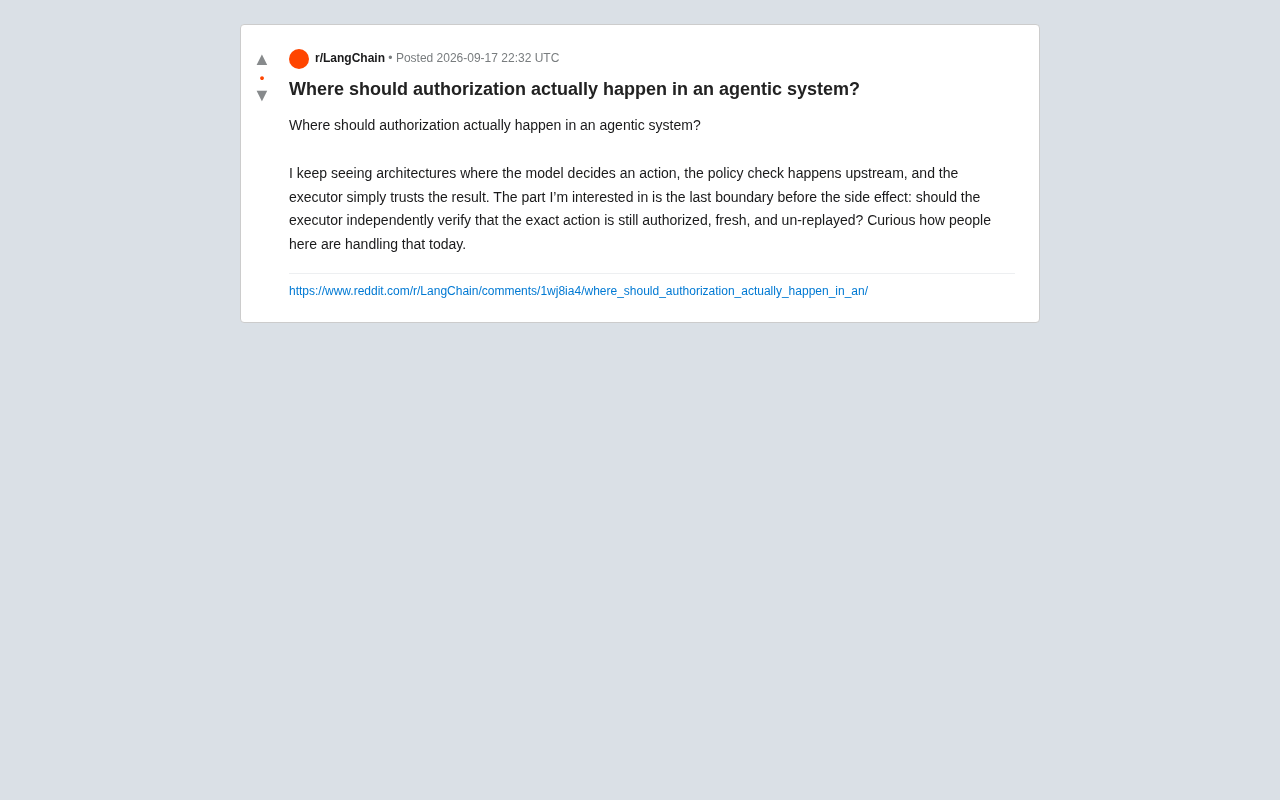
智能体系统中,执行器应在落地动作前独立验证授权,而非完全信任上游检查。
本文围绕智能体(Agentic)系统中一个被忽视的安全问题展开:授权检查应该在哪一层发生?常见架构将策略检查置于上游,执行器默认信任其结果,但从授权通过到动作真正落地之间存在时间窗口,可能引发状态漂移(权限被撤销)、动作篡改(参数被替换)和重放攻击(令牌被复用)。文章借用纵深防御原则,主张执行器作为距离副作用最近的一层,应独立验证动作的授权绑定完整性、凭证新鲜度和防重放约束。这一设计有额外延迟代价,建议按风险分级:高风险、不可逆操作必须独立校验,低风险只读操作可信任上游。随着 AI agent 自主能力增强,「执行边界验证」将从学术讨论变为工程必选项。
一个被忽视的安全边界
在构建智能体(agentic)系统时,一个反复出现却少有人深究的问题是:授权检查究竟应该发生在哪一层?
一位 Reddit 开发者提出了这个尖锐的问题。他观察到,许多主流架构遵循一个看似合理的流程:模型决定要执行的动作,策略检查(policy check)在上游发生,而执行器(executor)则默认信任检查结果,直接执行动作。
这种设计在直觉上没有问题——职责分离,各司其职。但作者关注的恰恰是最后那道边界:产生副作用(side effect)之前的最后一步。执行器是否应该独立验证,这个即将执行的动作此刻依然是被授权的、时效有效的、且未被重放的?
为什么上游检查还不够
把授权放在上游是常见做法,因为它集中管理、逻辑清晰。但智能体系统引入了传统应用没有的复杂性。
模型的决策是动态且不可完全预测的。从策略检查通过,到执行器真正落地动作,中间存在一个时间窗口。在这个窗口里,几件事可能出错:
- 状态漂移:授权在检查时有效,但执行时权限可能已被撤销。一个被批准的转账动作,如果延迟执行,账户状态或权限早已改变。
- 动作篡改:如果上游只验证了「动作类型」,而执行器拿到的是具体参数,中间任何环节的篡改都可能让实际执行的动作偏离被授权的那一个。
- 重放攻击(replay):同一个通过检查的授权令牌,若没有一次性约束,可能被重复使用,触发多次意料之外的副作用。
换句话说,上游检查回答的是「这类动作是否被允许」,而执行边界需要回答的是「这一个动作、此时此刻、是否仍然合法且唯一」。这是两个不同层次的问题。
重放攻击(Replay Attack) 是一种经典的网络安全威胁:攻击者截获一条合法的授权消息,并在之后将其原样重新发送,以欺骗系统再次执行同一操作。在传统 Web 应用中,通常通过 HTTPS + Session Token 等手段天然规避,但智能体系统中授权令牌往往在内部服务间传递,链路更长、中间环节更多,重放窗口也随之扩大。防御手段包括:为令牌附加单调递增的序列号、绑定请求发起方的身份指纹(如 IP 或 Agent ID),以及最简洁的方案——一次性 nonce(Number used Once),即每个授权凭证携带一个随机字符串,服务端消费后立即标记为已用,后续相同 nonce 的请求一律拒绝。在不可逆副作用(转账、删除、外部 API 写入)场景中,nonce 机制的引入几乎是零成本的幂等性保障。
纵深防御的思路
作者的核心主张——执行器应当独立验证——本质上是安全领域经典的**纵深防御(defense in depth)**原则在智能体架构中的应用。
不要让任何单一环节成为唯一的信任来源。上游的策略引擎负责粗粒度的授权决策,而执行器作为距离副作用最近的一层,应当承担最后的完整性校验责任。
在实践中,这通常意味着几种机制的组合:
绑定动作与授权凭证
授权凭证不应只授权一个动作「类型」,而应绑定到具体动作的完整内容(参数、目标、上下文)。执行器验证凭证时,同时校验即将执行的动作与凭证签发时的动作是否一致,防止参数被替换。
一种实用的技术实现是对授权凭证采用 HMAC 或数字签名:策略引擎在签发凭证时,将完整的动作描述(方法名、参数列表、目标资源、时间戳、nonce)序列化后一起纳入签名范围。执行器收到凭证后,将即将执行的动作重新序列化并验签——若参数在传递途中被任意修改,哪怕只改动一个字节,签名校验都会立即失败。这一方案与 JWT(JSON Web Token)的思路类似,但 JWT 通常只携带身份声明,而此处需要将「具体动作意图」也锁入签名,才能真正防止动作篡改。实施时需注意序列化的确定性(Deterministic Serialization),避免因字段顺序或空白字符差异导致合法请求被误判为篡改。
新鲜度检查
为授权引入短时效(TTL)或时间戳,执行器在落地前确认凭证未过期。对于高风险操作,甚至可以要求执行时二次确认当前权限状态,而非依赖检查时的快照。
防重放机制
为每次授权引入唯一的 nonce 或一次性令牌,执行器记录已使用的凭证,拒绝重复请求。这一点在涉及金钱、删除、外部 API 调用等不可逆副作用时尤为关键。
纵深防御(Defense in Depth) 源自军事战略,指通过多道独立防线来削弱攻击者的推进能力,而非依赖单一的坚固屏障。引入信息安全领域后,它的核心假设是「任何单一防御机制都可能被绕过」,因此系统应设计为:即使某一层失效,后续层仍能阻止损害扩大。在软件架构中,常见的体现是网络层防火墙 + 应用层输入校验 + 数据库层权限控制三者并存,而非只依赖其中之一。将这一原则映射到智能体系统:策略引擎(Policy Engine)相当于边界防火墙,负责粗粒度的意图过滤;而执行器(Executor)紧邻真实副作用,相当于最内层的数据库权限控制,负责在「扣动扳机」前做最后的精确核验。两层防御的职责不同、失效模式不同,组合后的整体鲁棒性远高于任一单层。
权衡:安全与延迟
这套设计并非没有代价。让执行器独立验证意味着额外的计算、额外的状态查询,可能引入延迟,也增加了系统复杂度。
合理的做法是按风险分级。对于只读、可逆、低影响的动作,信任上游检查可能已经足够;而对于产生真实世界副作用、不可逆或涉及敏感资源的动作,执行边界的独立验证就成为必需。智能体系统的自主程度越高、动作影响越大,这道边界的价值就越高。
这为什么对智能体时代格外重要
传统软件中,动作序列是开发者写死的,路径可预测,授权可以静态推理。但智能体系统里,是模型在运行时决定做什么。这种自主性正是价值所在,也正是风险所在。
当一个 AI agent 可以自主调用工具、访问数据、执行操作时,「模型决定了动作」和「动作真的被安全执行」之间的鸿沟必须由架构来填补。把最后一道防线交给执行器,是承认一个现实:上游再完美的决策,也需要在落地那一刻被再次确认。
这个 Reddit 讨论虽然简短,却点中了智能体安全架构中一个真实且尚未形成共识的痛点。随着 agent 能力的增强,「授权应该发生在哪一层」将不再是一个学术问题,而是每一个部署自主智能体的团队都必须回答的工程决策。
相关推荐
NVIDIA TensorRT Model Connect:两行命令部署开源模型
NVIDIA TensorRT Model Connect 让开源模型部署仅需两条命令,无需 ONNX 转换。支持 LLM、扩散、视频生成等多类模型,兼容 RTX 消费级 GPU,并新增双 DGX Spark 多设备推理能力。
NVIDIA cuML 加速谱聚类:Scikit-Learn 提速100倍实测
NVIDIA cuML 让 Scikit-Learn 谱聚类无需重写代码即可在 GPU 上运行,大规模数据下提速超 200 倍。本文解析其原理、接入方式及在金融期权数据中的实测表现。
谷歌DeepMind成立新机构:把AGI大辩论摆上台面
Google DeepMind成立新机构,旨在把通用人工智能(AGI)的重大问题带入公共辩论。本文分析这一举措背后的行业信号,以及从技术竞赛走向公共治理的转向意义。