中国ML论文高产之谜:数量背后的质量与生态争议
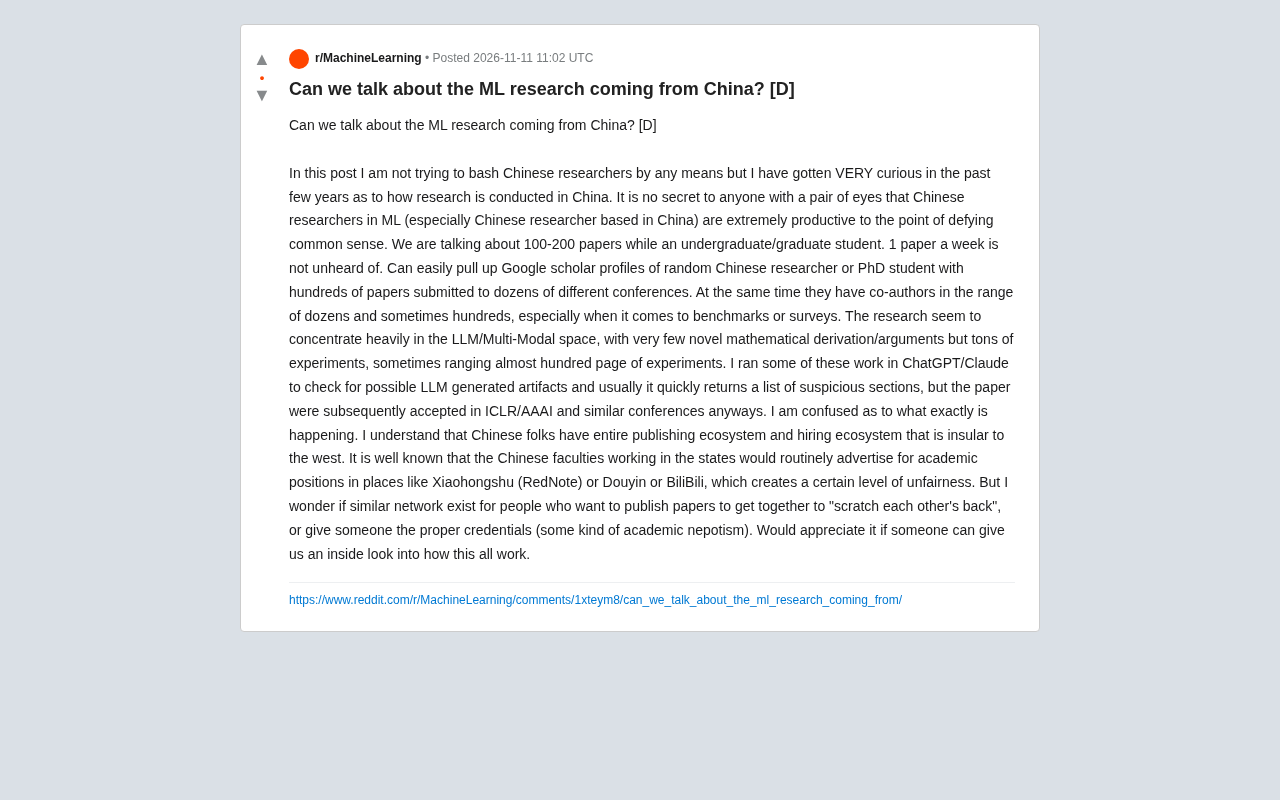
Reddit讨论揭示中国ML研究高产现象:论文数量惊人、合作者众多,引发质量与公平性质疑。
本文基于Reddit讨论,梳理了中国机器学习研究生态中的高产现象:本科生或研究生阶段发表100-200篇论文并不罕见,合作者规模常达数十人,研究高度集中于LLM和多模态领域,实验量巨大但数学推导较少。作者用LLM检测工具发现可疑段落,但这些论文仍被ICLR、AAAI等顶会接收。帖子还猜测存在相对封闭的学术出版和招聘网络,可能涉及互惠机制。文章指出,这种现象涉及学术评价体系、会议评审机制和人际网络等多重因素,单纯数量增长不等于质量提升,需要更多透明度和跨文化对话来理解。
引言
近期,Reddit上的一则讨论引发了对中国机器学习研究生态的广泛关注。帖子作者并非试图贬低中国研究者,而是对中国研究者——尤其是身处中国的学者——在ML领域“ defy common sense”的高产现象感到困惑:本科生或研究生阶段发表100-200篇论文,一周一篇并不罕见,Google Scholar上随便一个中国研究者或博士生都有数百篇论文投稿至数十个会议。同时,合作者动辄数十甚至上百人,尤其在基准测试或综述中。研究高度集中在LLM/多模态领域,新颖的数学推导较少,但实验量巨大,有时实验部分近乎百页。作者用ChatGPT/Claude检测这些工作,常快速返回可疑章节列表,但论文仍被ICLR/AAAI等会议接收。这背后究竟发生了什么?
高产现象:数量与合作的膨胀
中国研究者在ML领域的产出速度令人咋舌。据帖子描述,一名本科生或研究生阶段发表100-200篇论文并非天方夜谭,每周一篇的情况也时有耳闻。在Google Scholar上,随意点开一位中国研究者或博士生的主页,数百篇论文投向数十个不同会议的现象并不鲜见。更引人注目的是合作者规模:数十人乃至上百人的合作团队在基准测试或综述论文中尤为常见。这种“人海战术”式的合作模式,与西方学术界通常的小团队、深度合作形成鲜明对比。
这种高产背后,可能涉及复杂的学术评价体系、毕业要求以及资源分配机制。但单纯的数量增长是否意味着研究质量的同步提升?帖子作者对此持怀疑态度。
Google Scholar 引用与论文数:Google Scholar 是一个免费学术搜索引擎,其个人主页会聚合学者的论文列表、引用次数、h-index 等指标。由于它自动抓取网络上的论文信息,并不严格审核作者身份与论文质量,因此论文数量在主页上非常直观。在部分学术评价体系中,论文数量与引用数被简化为量化指标,这可能激励研究者追求“数量优先”的策略。
h-index:h-index 指一位学者有 h 篇论文每篇至少被引用 h 次,用于衡量产出与影响力的平衡。但 h-index 对高产但引用分散的作者可能产生“虚高”印象,尤其当大量论文发表于门槛较低的会议或期刊时。理解这些指标有助于分析高产现象背后的激励结构。
研究风格:实验驱动与数学深度的失衡
帖子指出,中国研究者的工作高度集中在LLM和多模态空间,实验部分极其庞大——有时接近百页——但新颖的数学推导或论证相对匮乏。这种“重实验、轻理论”的风格,或许与当前AI领域对基准测试和性能指标的过度追捧有关。然而,这种倾向也引发了对研究深度和创新性的担忧。
作者使用ChatGPT/Claude检测论文中可能的LLM生成痕迹,常能快速列出一系列可疑段落,但这些论文仍被ICLR、AAAI等顶级会议接收。这不禁让人质疑:会议评审机制是否存在漏洞?还是说,实验的丰富性足以掩盖理论深度的不足?
LLM 生成痕迹检测:文中提到用 ChatGPT/Claude 检测论文中可能的 LLM 生成段落,这属于“机器生成文本检测”范畴。常见方法包括分析文本的困惑度(perplexity)、词汇多样性、句法模式以及水印技术。但这类检测工具本身存在较高误报率,且对经过人工修改的文本效果有限。因此,检测结果只能作为参考,不能直接作为学术不端的证据。
ICLR 与 AAAI:ICLR(International Conference on Learning Representations)是深度学习领域的顶级会议,以开放评审(OpenReview)著称;AAAI 则是人工智能领域的综合性顶级会议。两者录用率通常在 20%-30% 左右,评审过程强调创新性、实验充分性与写作质量。实验量大的论文若缺乏理论贡献,仍可能因“工程性强”而获得接收,这反映了会议评审的多元标准与潜在偏好。
学术生态:封闭网络与潜在不公平
帖子作者理解中国拥有与西方相对隔离的出版和招聘生态系统。一个这个不用我讲的现象是,在美国工作的中国教师会经常在小红书、抖音或B站上发布学术职位招聘信息,这在一定程度上造成了不公平。作者进一步猜测,是否存在类似的网络,让想要发表论文的人相互“挠背”,或给予某人适当的 credentials(某种学术裙带关系)。
这种猜测虽无确凿证据,但反映了外界对中国学术生态透明度的疑虑。合作者数量庞大、会议投稿密集,可能暗示着一种基于人际网络的互惠机制。然而,这并非中国独有,全球学术界都存在类似现象,只是规模和形式可能不同。
学术裙带关系与互惠引用:文中猜测的“相互挠背”现象在学术界常被称为“互惠引用”(reciprocal citation)或“引用 cartel”。研究者通过小圈子互相引用、共同署名来提升引用指标,或利用人际网络获取评审便利。这种现象并非中国独有,全球学术界均有案例,但大规模、系统性的互惠网络会损害学术公平与创新。
小红书、抖音、B站上的招聘信息:这些中国社交平台已成为部分海外中国教师发布学术招聘的渠道。由于信息传播范围有限且圈子化,可能导致招聘机会的不对称分布,加剧学术资源获取的不公平。这反映了学术劳动力市场中信息透明度和渠道多样化的重要性。
多源视角与未解之谜
本次讨论主要基于单一Reddit帖子,缺乏其他独立来源的交叉验证。帖子中的观察和猜测代表了部分研究者的困惑,但需要更多实证研究来揭示中国ML研究高产背后的真实机制。例如,高产是否与特定的评价指标(如论文数量与毕业挂钩)有关?会议评审是否对实验量大的论文有偏好?这些问题的答案,需要更深入的调查。
基准测试与综述论文的合作膨胀:基准测试(benchmark)论文通常需要构建数据集、设计评测协议并运行大量实验,综述论文则需要覆盖广泛文献,因此合作者数量自然较多。但在某些情况下,合作者名单可能包含仅提供少量贡献或资源支持的作者,导致“挂名”现象。这引发了关于作者贡献标准(如 ICMJE 准则)的讨论:当合作者规模达到数十人时,如何确保每位作者都对论文有实质贡献?这需要更透明的贡献声明机制。
结语
中国ML研究的高产现象是一个复杂的话题,涉及学术文化、评价体系、会议评审和人际网络等多重因素。单纯的数量增长不应被简单等同于质量提升,但也不应被一概否定。理解这一现象,需要更多透明度和跨文化的对话,而非简单的猜测或偏见。
(注:本文基于Reddit讨论整理,观点仅代表原帖作者及讨论者,不代表本平台立场。)
相关推荐

Cursor、Devin、TRAE、Copilot价格怎么比?先算额度再比月费
横向对比Cursor、Devin Desktop、TRAE、Copilot四家AI编程工具的个人与团队定价,拆解额度规则、第三方模型是否含在月费、超额计费方式,并给出付费前测消耗、设支出上限和选型的实操方法。

Copilot下架三款模型:Pro用户替代选择只剩一个
GitHub Copilot 自 11 月 16 日起下架 Claude Opus 4.8、Claude Opus 5、GPT-5.6 Tera 三款模型,覆盖 Chat、代码补全与 Agent 模式。Pro 用户三个替代中仅剩 GPT-6 Luna 可用,年付 Legacy 计划拿不到 Opus 5.5,管理员需手动开启替代模型。

Gemini 4 Carbon登场:大模型竞赛进入百万上下文与万亿开源时代
谷歌发布Gemini 4 Carbon并推出多智能体工具Swarm,Anthropic推出百万上下文Fable 5.2与Mythos 5.2,OpenAI发布安全专版GPT-6 Cyber,Mistral与Kimi同步开源万亿参数模型,大模型竞赛全面提速。