重回LangChain还是坚持自研?2026年AI Agent技术栈选型思考

一位开发者的Agent框架选型困惑,折射出整个行业在自研vs框架、Python vs TypeScript上的集体权衡。
一位从LangChain早期用户转型为全自研TypeScript Agent运行时开发者的技术人,在启动新项目时重新面临框架选型难题,并在Reddit上引发了广泛讨论。文章围绕这一真实案例,系统梳理了生产级Agent系统的核心选型维度:包括模型提供商切换能力、第一天就要落地的可观测性与评估体系、Human-in-the-loop机制,以及ZDR、HIPAA等合规硬约束。同时深入探讨了TypeScript与Python在Agent开发生态中的现实差距——前者在Web全栈集成上有优势,后者在框架功能完整性和ML生态上仍更成熟。文章最终给出务实的判断逻辑:合规与可观测性应作为一票否决项前置过滤,语言选择需兼顾产品形态与团队招聘,而AI辅助编程的成熟已显著降低了自研的门槛。
一位早期LangChain用户的回归之问
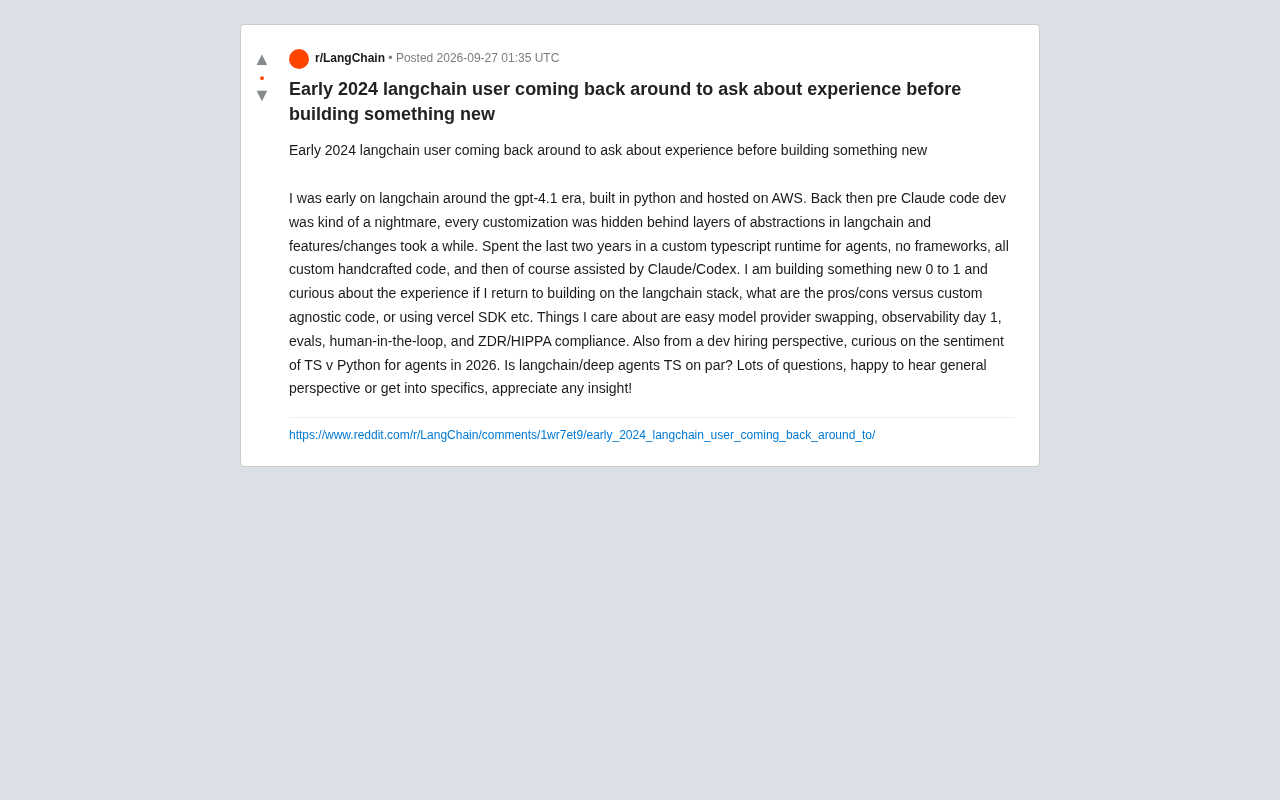
一位在GPT-4.1时代就开始使用LangChain的开发者,最近在Reddit上发起了一场关于Agent技术栈选型的讨论。他的经历颇具代表性:早期用Python搭建、部署在AWS上,随后花了整整两年时间投入到完全自研的TypeScript Agent运行时中——不依赖任何框架,全部手工编写代码,再辅以Claude和Codex的AI编程协助。
如今他要从零开始(0 to 1)构建新项目,站在了一个熟悉又陌生的十字路口:是重新拥抱已经迭代多次的LangChain生态,还是继续走自研路线,抑或转向 Vercel AI SDK 这类新兴方案?这个问题背后,其实是当下无数Agent开发者都在纠结的现实抉择。
框架抽象层的痛与自研的自由
这位开发者对早期LangChain的吐槽相当直接:在Claude Code辅助编程尚未成熟的时代,LangChain的开发体验"简直是噩梦"。每一处定制化需求都被埋藏在层层抽象之下,功能更新和变更往往需要漫长等待。这正是许多早期用户放弃框架、转向自研的核心原因——抽象层在带来便利的同时,也剥夺了对底层逻辑的掌控力。
他选择了另一条路:用TypeScript手写一套自定义Agent运行时,彻底摆脱框架束缚。这种做法在AI编程工具成熟后变得更具可行性——当Claude、Codex能够高效协助你编写和维护自定义代码时,"造轮子"的成本被显著压低,而换来的是完全的架构自主权。
这也引出了框架选型的根本矛盾:框架用约定和抽象换取开发速度,自研用工作量换取灵活性和可控性。在Agent这个仍在快速演进的领域,这个权衡尤其微妙。
从零构建时真正该关心的几件事
这位开发者列出的选型考量清单,几乎是一份生产级Agent系统的需求模板,值得每个技术决策者对照参考:
模型提供商的便捷切换
在模型能力日新月异、价格频繁调整的当下,能否轻松在不同模型供应商之间切换,直接关系到系统的长期成本和能力上限。这也是抽象层真正能创造价值的地方——一个设计良好的provider抽象,能让你在OpenAI、Anthropic等供应商之间无痛迁移。
Day 1 的可观测性与评估体系
他特别强调了"第一天就要有可观测性(observability day 1)"和评估(evals)能力。这反映出成熟团队的共识:Agent系统的可观测性和评估不是事后补丁,而应是架构的基础设施。没有完善的追踪和评估,Agent的行为就是黑盒,迭代和调试将寸步难行。
可观测性(Observability)在Agent系统中通常包含三个层面:**追踪(Tracing)**记录每次LLM调用的输入输出、耗时与Token消耗;**日志(Logging)**捕获工具调用、状态变更等离散事件;**指标(Metrics)**汇总成功率、延迟分布、成本趋势等聚合数据。主流的Agent可观测性工具包括LangSmith(LangChain官方)、Langfuse(开源)、以及Arize Phoenix等。
评估(Evals)则是另一个独立维度,指对Agent输出质量的系统性测量,分为自动评估(如LLM-as-judge、规则匹配)和人工评估两类。与传统软件的单元测试不同,Agent的输出具有概率性和开放性,很难用简单的断言来验证,因此Evals体系需要专门设计评测数据集和评分标准。在"第一天就接入可观测性"的实践背后,隐藏的逻辑是:没有足够的追踪数据积累,就无法构建有意义的评测基准,调试和迭代将完全依赖直觉。
Human-in-the-loop 与合规要求
人在回路(human-in-the-loop)机制以及ZDR(零数据保留)、HIPAA合规,是面向企业和医疗等敏感场景的硬性门槛。这类需求往往决定了技术栈的可选范围——很多框架在合规能力上的支持深浅,会直接筛掉一批候选方案。
Human-in-the-loop(HITL)是指在Agent自动执行链路中设置人工审核或干预节点,常见于高风险操作(如执行数据库写入、发送外部通信、处理金融交易)前的确认步骤。其实现方式通常依赖框架对"暂停-恢复"工作流的原生支持,即Agent在某个步骤挂起并等待人工输入,随后恢复执行——这对底层的状态持久化机制有较高要求。
ZDR(Zero Data Retention,零数据保留)是云服务提供商(如Anthropic、OpenAI)提供的一种合规选项,承诺API请求和响应数据不会被保留用于模型训练或日志存储,通常需要签署企业级协议并支付额外费用。HIPAA(美国健康保险流通与责任法案)则要求处理受保护健康信息(PHI)的系统满足严格的数据安全和访问控制标准。这两类要求对框架选型的影响往往体现在:框架是否支持将LLM调用路由到合规端点、是否允许禁用默认的追踪数据上传,以及第三方集成组件是否持有相应认证。
TypeScript 还是 Python?2026年的Agent语言之争
讨论中一个格外有价值的问题是:从招聘角度看,2026年做Agent开发,TypeScript和Python的社区情绪如何?LangChain的TS版本、以及 deep agents 的TS实现,是否已经和Python版本平起平坐?
这个问题触及了一个长期存在的生态失衡。Python凭借其在机器学习和数据科学领域的深厚积累,长期是AI开发的默认语言,LangChain等主流框架的Python版本通常功能最完整、更新最及时。而TypeScript则在全栈开发、前端集成和Serverless部署(如Vercel生态)上拥有天然优势。
对于一个需要与Web应用深度集成的Agent产品来说,TS技术栈能让前后端共享类型定义、简化部署链路;但如果框架的TS版本在功能上滞后于Python版本,团队就要在语言统一性和功能完整性之间做取舍。这位开发者关于"TS版是否已与Python版对等"的疑问,恰恰说明这个鸿沟在业界仍未完全弥合。
Vercel AI SDK是Next.js母公司Vercel推出的面向TypeScript/JavaScript生态的AI开发工具包,提供了统一的模型调用接口、流式响应处理、以及与React Server Components的深度集成。它的设计哲学更偏向"薄封装"——保持接近底层API的透明度,同时抹平不同模型提供商之间的接口差异。相比LangChain的重度抽象,Vercel AI SDK在Web全栈场景下的开发体验通常更为轻量,但在复杂多步骤Agent、持久化工作流等方面的内置支持相对有限。对于以Web产品为主要形态、且团队已深耕TypeScript技术栈的团队,它是一个值得认真评估的替代选项。
给同类决策者的思考框架
虽然这是一个开放式提问、尚无标准答案,但从这场讨论中可以提炼出几点务实的判断逻辑:
没有绝对正确的选择,只有匹配场景的选择。 如果你的核心诉求是快速验证、依赖大量现成集成,框架(LangChain / Vercel AI SDK)能显著加速;如果你追求极致的可控性、且已具备成熟的AI辅助编程工作流,自研运行时的成本已不像从前那样高昂。
把合规和可观测性作为选型的一票否决项。 ZDR、HIPAA这类硬约束,应该在评估初期就用来过滤方案,而不是等到落地阶段才发现框架不支持。
语言选择要兼顾产品形态和团队招聘。 如果产品与Web前端紧密耦合,TS的全栈优势值得认真考虑;若重度依赖ML生态和最新框架特性,Python仍是更稳妥的选择。
这位开发者的回归之问,本质上是整个Agent开发社区在框架成熟度、AI辅助编程能力、以及生产级需求三者交汇点上的集体思考。答案因项目而异,但清晰的需求清单和权衡框架,永远是做出正确决策的前提。
相关推荐

顶尖企业用好AI的秘诀:从实验走向成熟管理层
基于KPMG第三季度AI Pulse调查,解析用好AI的顶尖企业与实验阶段企业的关键差距:模型路由、数据主权、AI管理层、成本与价值管理,以及从效率到机会的用途转变。

付费用户因"网络滥用"遭ChatGPT封号:1分钟秒拒的申诉机制引众怒
一名付费ChatGPT用户因"网络滥用"被无预警封号,三次申诉均在一分钟内被机器人驳回,全程无人工审核。本文梳理事件经过、可能的误判原因,并剖析AI平台自动化治理的申诉困境与开发者应对建议。

OpenSOP:用Git管理多语音Agent提示词的开源方案
OpenSOP 是一个开源工具,用 Git、YAML 和 Markdown 管理多个AI语音Agent的提示词,解决提示词重复、漂移和手动同步难题,支持改动影响预览和一键回滚。