重新思考On-Policy蒸馏的监督扩展:超长轨迹未必更优

研究发现OPD监督收益随深度递减,提出随机视野SH-OPD以更低成本取得相当或更优性能。
本文质疑 on-policy 蒸馏中“轨迹越长、稠密监督越多越好”的默认假设。控制实验发现,增加被监督 token 的边际收益持续下降,但深层位置仍可学习,并存在跨位置监督迁移。梯度分解进一步揭示,不同响应位置共享大量更新成分,而深层位置的特异性残差在多次 rollout 间一致性下降,造成监督冗余与噪声。基于此,作者提出 SH-OPD:为每个训练批次采样共享的随机视野上限,在保留深层状态访问的同时削减冗余监督,并理论刻画了重加权偏差与计算量权衡。实验显示,数学推理在约 45% 成本下准确率略高,代码生成在约 60% 成本下保持竞争力。
On-policy 蒸馏(OPD)通过学生模型自生成的轨迹提供稠密的 token 级监督,但更长的轨迹是否带来成比例的学习收益?一篇最新研究对此提出了质疑,并给出了更高效的替代方案。
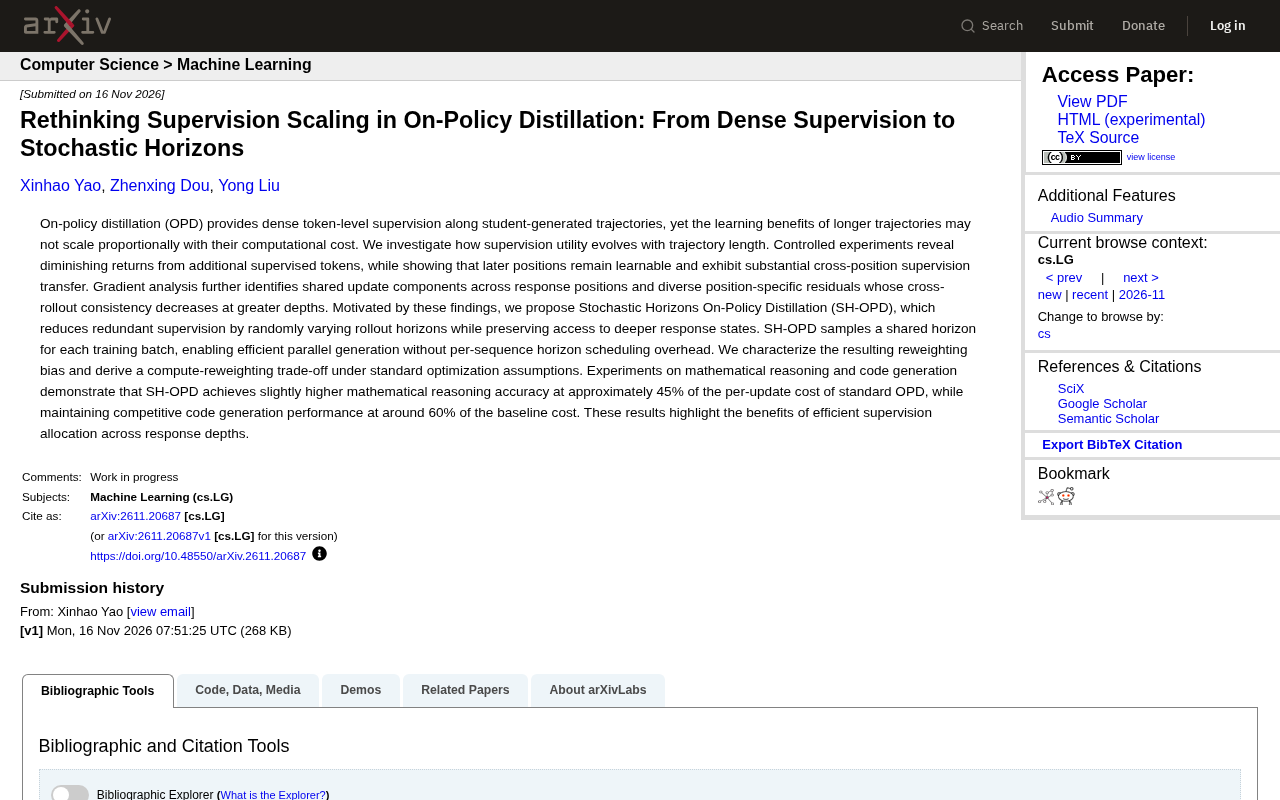
核心发现:监督收益递减与跨位置迁移
研究团队通过控制实验观察监督效用随轨迹长度的演变,发现两个关键现象。
收益递减:增加更多被监督的 token 所带来的边际收益持续下降。换句话说,后半段轨迹虽包含大量监督信号,但对模型能力提升的贡献远小于前半段。
深层位置仍可学习,且存在跨位置迁移:尽管收益递减,靠后的响应位置并非“无效信息”——它们依然可被学习,并且表现出显著的跨位置监督迁移。这意味着,对深层位置的监督能间接改善其他位置的预测质量。
这一发现挑战了“监督越稠密越好”的直觉:真正的问题不是能否监督到每个 token,而是监督信号在深度维度上如何分配才最划算。
On-policy 蒸馏(OPD) 是一种知识蒸馏范式:学生模型在训练过程中自行生成响应轨迹(rollout),教师模型则对这些自生成轨迹逐 token 提供监督信号。与离线蒸馏使用固定数据集不同,OPD 的监督分布随学生模型能力变化而动态演进,因此属于“在线”学习。其典型优势在于能提供稠密的 token 级奖励或概率分布监督,缓解稀疏序列级奖励的信用分配难题;代价则是需要频繁生成 rollout,计算开销较大,这也是本文关注监督效率的背景。
跨位置监督迁移 指对某一响应位置的监督信号,能改善模型在其他(尤其邻近或更深)位置上的预测质量。在自回归模型中,不同位置的梯度更新并非彼此独立,而是共享底层表示与参数;因此监督某个深层 token 时,模型学到的模式可能迁移到其他位置。这一现象说明深层监督并非完全无效,但其边际收益会因共享成分的重复而衰减。
梯度分析揭示监督冗余的结构性根源
为了理解收益递减的机制,作者对梯度进行了分解分析。
结果显示,不同响应位置之间存在共享的更新成分,同时也存在多样的位置特异性残差。随着响应深度增加,这些残差在多次 rollout 之间的一致性下降——即深层位置的梯度方向更不稳定、更具噪声。
这解释了为何稠密监督到深层时效率不高:模型在深层收到的更新中,有相当一部分是重复的共享信号,而真正有用的特异性信号则被稀释。冗余监督不仅浪费计算,还可能引入噪声。
梯度分解分析 是一种诊断手段:将每个响应位置产生的梯度向量拆解为两部分——所有位置共有的“共享更新成分”和该位置特有的“特异性残差”。若共享成分占主导,说明不同位置的监督在更新方向上高度重叠,增加更多位置只是重复强化同一信号;若特异性残差在多次 rollout 间方向一致,则说明该位置提供了稳定且可泛化的新信息。本文发现深层位置的特异性残差跨 rollout 一致性下降,意味着这些位置的梯度更像噪声,稠密监督到深层时效率自然降低。
SH-OPD:用随机视野削减冗余监督
基于上述洞察,作者提出 Stochastic Horizons On-Policy Distillation(SH-OPD)。其核心思路是:随机变化 rollout 的视野长度,在保留对深层响应状态访问的同时,减少对冗余位置的监督。
具体实现上,SH-OPD 为每个训练批次采样一个共享的视野上限,而非对每条序列单独调度。这一设计使得并行生成可以高效进行,避免了逐序列 horizon 调度带来的开销。
作者进一步刻画了这种随机视野引入的重加权偏差,并在标准优化假设下推导了计算量与重加权之间的权衡关系。简言之,SH-OPD 用统计上的随机性换取计算效率,同时通过理论分析保证这种近似是可控的。
随机视野(Stochastic Horizons) 借用了强化学习或序列决策中“视野(horizon)”的概念:一次 rollout 中被监督的响应长度上限。传统 OPD 通常对完整轨迹逐 token 监督,而 SH-OPD 在每次训练批次中随机采样一个共享的视野上限,只对视野内的 token 施加监督。批次级共享意味着同一批并行生成的序列使用同一 horizon,从而避免逐序列调度带来的同步与通信开销。随机化则保证模型仍能以一定概率访问深层响应状态,同时减少对高冗余位置的重复监督。
重加权偏差 是随机视野引入的统计问题:由于不同视野下各 token 被纳入监督的概率不同,简单平均会导致梯度估计偏离全轨迹监督的目标。作者刻画了这一偏差,并在标准优化假设下推导了计算量与重加权之间的权衡,说明通过适当的重加权或接受可控偏差,可以在显著降低计算量的同时保持学习效果。
实验结果:更少成本,相当甚至更好的性能
在数学推理和代码生成两类任务上的实验表明:
- 数学推理:SH-OPD 在约 45% 的单次更新成本下,取得了略高的数学推理准确率。
- 代码生成:在约 60% 的基线成本下,保持了有竞争力的代码生成性能。
这些结果说明,将监督预算更智能地分配到响应深度上,比一味拉长轨迹更划算。对于需要大量 rollout 的 on-policy 训练场景,这种成本削减具有直接的工程价值。
对蒸馏实践的启示
这项工作的价值不止于一个具体算法。它提示我们重新审视 on-policy 蒸馏中“稠密监督”的默认假设:学生模型生成的轨迹越长,并不自动意味着学习信号越丰富。
从工程角度看,SH-OPD 的批次级共享视野设计降低了实现复杂度,适合并行化部署;从研究角度看,梯度一致性随深度下降的现象,为后续设计更精细的监督分配策略提供了方向。
当然,该方法的有效性目前主要在数学推理与代码生成任务上得到验证,向更开放域任务的迁移仍需进一步观察。但“从稠密监督到随机视野”这一思路转变,本身已为 on-policy 蒸馏的效率优化提供了有价值的参考。
相关推荐

OpenAI 11月30日关停Agent Builder等三项服务,开发者需紧急迁移
OpenAI 将于 11 月 30 日关停 Agent Builder、evals 仪表盘和可复用提示三项开发者功能,evals 已转为只读。本文梳理受影响范围、OpenAI 官方给出的迁移路径(Agent SDK、PromptFu、自有代码)以及开发者本周应完成的导出与重建动作。

RankSpot:按次付费的SEO与AI搜索执行层,让Agent替你写文、发布、换外链
RankSpot 是面向 AI Agent 的 SEO 与 AI 搜索执行层,通过 MCP 接入 Claude 或 ChatGPT,让 Agent 完成写文、发布和外链获取。按次付费,每篇文章 3 美元,读数据免费,支持 100 多种语言。

Appxiom:给AI编程助手装上生产环境上下文
Appxiom为AI编程Agent提供生产环境上下文,覆盖崩溃、卡顿、内存泄漏与失败的网络调用,支持Android、iOS、Flutter、KMP和Web,并通过Goal Friction Impact按业务目标排序Bug。