最近邻基线挑战深度学习:MS/MS指纹预测的严格基准

最近邻检索可媲美深度学习的MS/MS分子指纹预测,揭示领域基准测试存在系统性缺陷。
一篇 arXiv 报告指出,在从 MS/MS 质谱预测分子指纹这一计算质谱学核心任务上,基于最近邻检索的简单方法能够匹配甚至超越当前深度学习模型。报告的关键洞察在于:"最近邻"并非单一算法,而是一个方法家族,各变体在推理阶段对可用参考信息的假设不同,这些假设的细微差异会显著影响所报告的性能数字。当深度学习论文采用信息假设宽松(甚至隐含数据优势)的最近邻变体作为比较基线时,新模型的性能优势往往被人为放大。该报告呼吁系统性地比较多种最近邻变体、建立更严格的基线,以确保领域内的比较研究真实可靠。其方法论启示超越了质谱这一单一领域,对所有依赖神经网络模型的科学计算方向均有参考价值。
一个被低估的简单方法
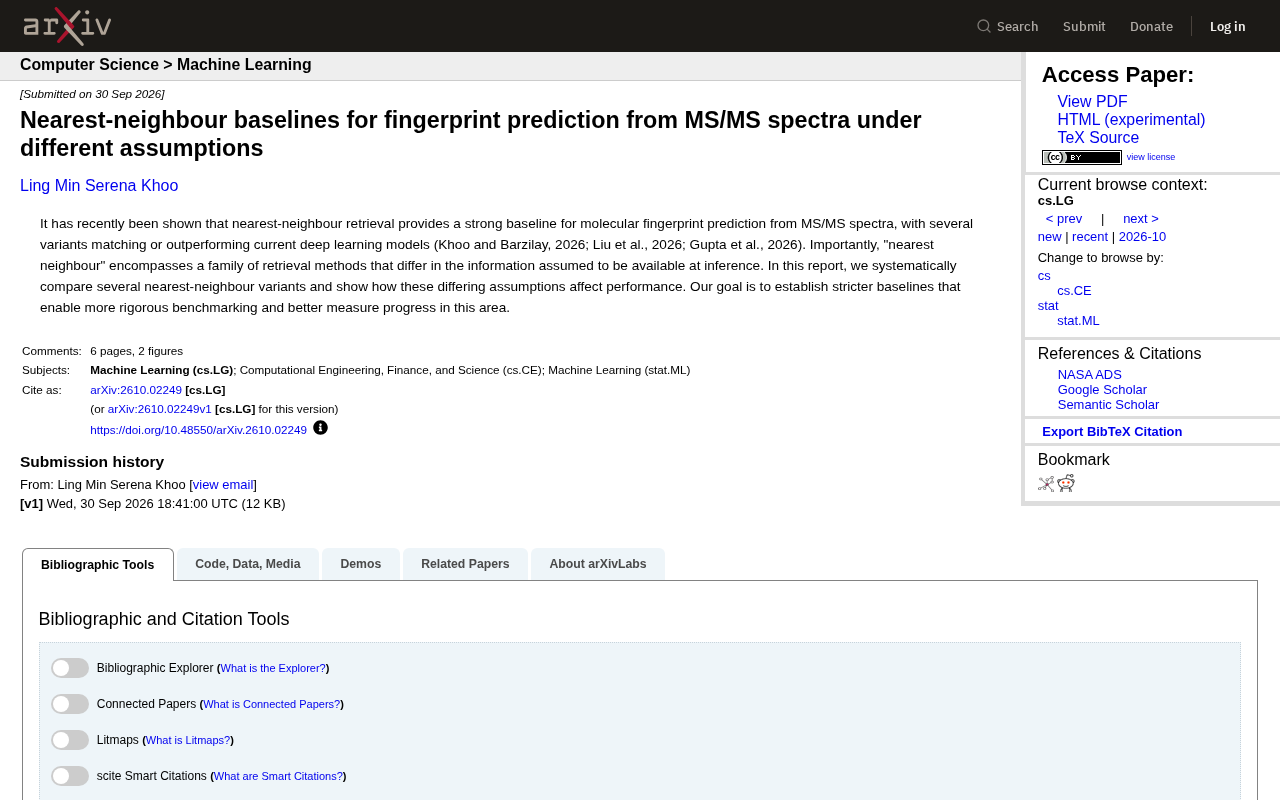
在分子指纹预测这一计算质谱学的核心任务上,深度学习长期被视为主流解决方案。然而最新的一篇 arXiv 报告(arXiv:2610.02249v1)提出了一个值得关注的观点:基于最近邻(nearest-neighbour)检索的简单方法,在从 MS/MS 质谱预测分子指纹时,能够匹配甚至超越当前的深度学习模型。
这一结论并非孤例。报告援引了多项近期研究(Khoo and Barzilay;Liu et al.;Gupta et al.)的结果,它们都指向同一个方向——最近邻检索构成了一条被长期低估的强基线。对于一个高度依赖复杂神经网络架构的领域来说,这样的发现无疑具有警示意义。
为什么要关注分子指纹预测
分子指纹是将化学结构编码为固定长度向量的表示方式,广泛用于化合物鉴定、相似性搜索和虚拟筛选。而 MS/MS(串联质谱)是代谢组学与天然产物研究中用于推断分子结构的关键实验手段。
从 MS/MS 谱图直接预测分子指纹,意味着可以在没有标准品的情况下对未知化合物进行结构线索提取。这正是 CSI:FingerID 等著名工具试图解决的问题。深度学习方法近年来在该任务上投入大量研究资源,因此一条简单的检索基线如果能够与之比肩,就引出了一个尖锐的问题:这些复杂模型究竟带来了多少实质进步?
分子指纹的具体形式通常是一个二进制或实值向量,每个维度对应一种特定的子结构或化学特征是否存在。常见类型包括 ECFP(Extended Connectivity Fingerprints,扩展连通性指纹)和 MACCS Keys 等。MS/MS 则通过将母离子碎裂后测量碎片的质荷比(m/z)和丰度,形成一张"碎裂谱图"。不同化合物的碎裂模式各异,理论上蕴含了推断原始分子结构所需的信息。
CSI:FingerID 是由 Böcker 团队开发的代表性工具,其核心思路是用机器学习模型将 MS/MS 谱图映射到分子指纹空间,再通过指纹在数据库中检索候选结构。这一两阶段流程(谱图→指纹→结构)已成为该领域的标准范式,也正是"预测分子指纹"这一中间步骤如此重要的原因:指纹预测的质量直接决定最终结构鉴定的成败。
「最近邻」不是单一方法
报告的核心洞察在于指出:「最近邻」并非一个单一算法,而是一个方法家族。不同变体之间的关键差异,在于它们在推理阶段假设可以获得哪些信息。
推理假设决定性能
举例来说,某些变体可能假设检索库中包含与查询谱图高度相似的已知谱图;另一些变体则可能对可用的参考信息做出更严格或更宽松的限定。这些看似细微的假设差异,会显著影响最终报告的性能指标。
换言之,如果一篇论文声称其深度学习模型超越了「最近邻基线」,却没有明确说明该基线采用了哪种假设,那么这个比较本身可能缺乏说服力。基线过弱会人为放大新模型的优势。
所谓"推理阶段的信息假设",本质上是指在预测时允许模型或基线方法"看到"哪些参考数据。对于最近邻检索而言,最强的假设是:检索库中存在与待测谱图来自同一化合物(或结构极相似化合物)的参考谱图——此时检索方法几乎可以直接"抄答案",性能自然极高。而更严格的假设则要求检索库仅包含结构上不重叠的化合物,即标准的跨化合物泛化评估场景。
深度学习论文中的常见问题是:将自身模型在严格假设下评估,却拿一个信息更宽松、隐含"数据泄露"的最近邻变体作为对比基线。这种不对等比较会系统性地高估深度学习的相对优势。因此,明确声明各方法在评估时共享相同的信息约束,是保证比较有效性的前提条件。
建立更严格的基准
报告的目标非常明确:系统性地比较多种最近邻变体,揭示不同假设如何影响性能,从而建立更严格的基线。这对整个领域的意义在于——只有当基线足够扎实,我们才能真正衡量深度学习模型带来的进步。
这种做法呼应了机器学习界近年来反复出现的一种反思:许多宣称的「突破」在面对经过认真调优的简单基线时会大幅缩水。强基线不是为了否定深度学习,而是为了确保基准测试的诚实与严谨,让后续研究能够站在可靠的参照系上。
机器学习领域对"简单基线被忽视"的批评由来已久。Lipton 和 Steinhardt(2019)在《Troubling Trends in Machine Learning Scholarship》中系统梳理了论文写作中的常见误区,基线选择不当正是其中之一。在自然语言处理和推荐系统领域,也曾多次出现类似情况:精心调优的线性模型或 BM25 检索在与复杂神经网络的对比中表现相当,甚至更优。
这一现象在化学信息学领域尤为值得警惕,原因在于该领域的训练数据集(如 GNPS 公开谱图库)规模相对有限,且谱图质量参差不齐。在数据量受限的情形下,基于记忆与检索的方法往往具有天然优势——它们直接利用已知数据而非试图从中归纳泛化规律,因此在分布内样本上的表现可能超过依赖统计泛化的深度模型。
对研究实践的启示
对于从事质谱数据分析或分子表示学习的研究者,这份报告提供了几点实用提醒:
- 报告性能时必须明确说明基线在推理阶段的信息假设;
- 评估新模型前,应先用调优良好的检索方法建立参照;
- 警惕因基线设置不当而产生的虚假进步感。
需要说明的是,作为一份报告摘要,原文尚未公开具体的实验数值与各变体的详细定义,因此我们无法在此给出量化结论。但其提出的方法论问题——如何公平地比较检索方法与深度学习——具有超越单一任务的普适价值。
结语
这项工作并不以炫目的新模型取胜,而是回归到科学评估的根本:一个公平、严格的比较框架。在深度学习方法层出不穷的今天,提醒大家认真对待简单基线,本身就是一种有价值的贡献。对于希望推动 MS/MS 指纹预测领域真正前进的研究者而言,严格的基准设定或许比又一个新架构更为迫切。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。