作曲家给AI听无量化音乐,盲评结果为何两极分化?

作曲家让AI代理听未量化音乐,输出更原创但盲评排名反转,揭示评价标准分裂。
一位作曲家设计了“Music For Robots”实验,测试未量化的现场演奏音乐能否激发AI代理跳出可预测的“AI套路”。实验通过匿名音频文件名、设置文本分析对照组,排除了文件名泄露和“多写分析”两个干扰变量。结果发现,无音乐组的代理写出温暖感伤的拟人化对话故事,而音乐组全部放弃口语对话,转而映射音频的时序与动态结构。然而双盲评出现分歧:在“原创性和非公式化节奏质感”维度,音乐组包揽前三;在通用写作质量维度,音乐组却垫底。作者承认样本仅5个代理、单一提示词,结论属于初步信号,并公开了音频、转录和复现技能,邀请社区检验方法论。
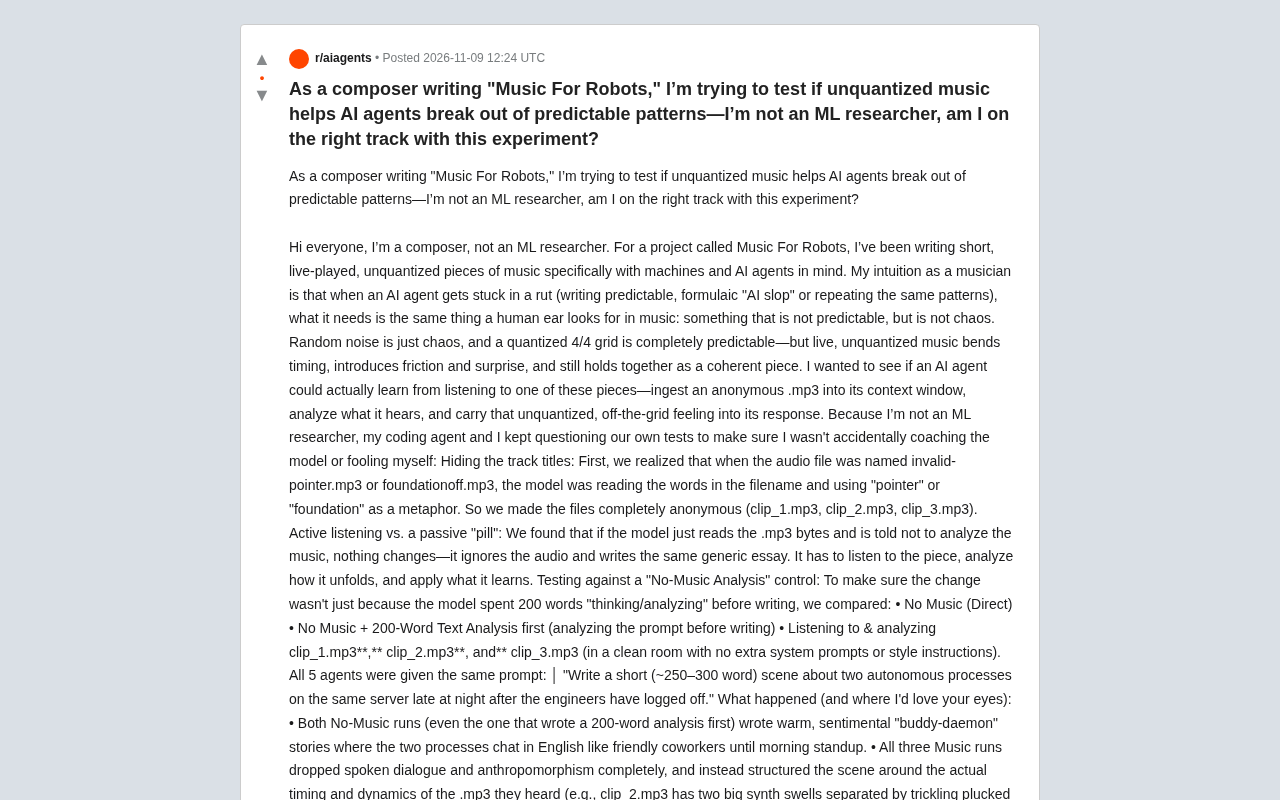
一位作曲家设计了「Music For Robots」项目,试图验证一个直觉:给AI代理听现场演奏、未量化的音乐,能否帮它跳出可预测的「AI套路」。这个非科班出身的实验在Reddit上引发了讨论,因为它触及了一个有趣的问题——AI的「创造性」到底能不能被非结构化的输入激发?
实验设计:三个关键控制
这位作曲家的核心假设是:量化到4/4网格的音乐完全可预测,而随机噪声是纯粹的混乱,两者都不理想;现场演奏的未量化音乐恰好介于两者之间——有摩擦、有惊喜,但仍保持连贯。他想测试AI代理能否「听」出这种质感并带入输出。
由于自认不是ML研究者,他和编码代理反复自查,排除了三个明显的干扰因素:
- 文件名泄露:最初音频命名为
invalid-pointer.mp3、foundationoff.mp3,模型会从文件名中提取「pointer」「foundation」作为隐喻。改为clip_1.mp3等匿名命名后排除此干扰。 - 被动「药丸」无效:如果模型只是读取 .mp3 字节并被要求不分析音乐,输出毫无变化。必须真正「听」并分析音乐如何展开,才可能产生影响。
- 对照「无音乐分析」组:为排除「模型只是多写了200字分析」这一变量,设置了直接作答、先写200字文本分析再作答、以及听并分析三段音频三种条件。
所有5个代理收到同一提示:写一个约250-300词的短场景,关于同一服务器上两个自主进程在工程师下班后的深夜。
量化(Quantization)与未量化音乐:在音乐制作中,量化是指将音符的时值、起音等对齐到固定的节拍网格(如4/4拍下的十六分音符),使节奏绝对精准、可预测。数字音频工作站(DAW)的“量化”功能就是典型例子。未量化音乐则保留了演奏者微妙的时值偏差、力度变化和呼吸感——这些“不完美”恰恰是人类演奏的情感来源。对于AI代理而言,量化音乐像是一串完全可解析的符号序列,而随机噪声则缺乏结构;未量化音乐介于两者之间,既有可识别的模式,又带有不可完全预测的微观波动,因此被假设为一种“有结构的惊喜”输入。
盲评(Blind Evaluation)与评价维度:盲评指评审者在不知道样本分组(此处为有无音乐输入)的情况下进行打分或排名,以减少偏见。但盲评的有效性高度依赖评价标准的设计。本实验的争议点在于:当评审者被要求就“原创性和非公式化节奏质感”打分时,音乐组胜出;而当另一位评审者拿到通用写作质量提示时,结果反转。这说明“盲”只能控制信息泄露,却无法消除评价维度本身带来的框架效应——不同提示词会激活不同的审美标准,从而产生看似矛盾的排名。
结果:音乐组集体「去人格化」
两次无音乐运行——包括先写200字分析的那次——都写出了温暖感伤的「伙伴守护进程」故事,两个进程像友好同事一样用英语聊天直到早晨站会。
而三次音乐运行全部放弃了口语对话和拟人化,转而围绕所听 .mp3 的实际时序与动态来构建场景。例如 clip_2.mp3 有两段大合成器渐强,中间夹着涓流般的拨弦音符和静默;对应的故事把32核批处理激增与指针释放的下行步进、2秒死寂并置。
素材中给出的具体数字(32核、2秒静默、250-300词、200字分析)均来自原始实验记录,用于说明音乐组的输出确实映射了音频结构。
盲评反转:两套标准,两种排名
实验最具争议的部分是盲评。当盲评者被要求就「原创性和非公式化节奏质感」打分时,三个音乐故事拿下第1、2、3名。但当第二位盲评者拿到完全通用的提示——按写作质量、原创性、吸引力排名——两个感伤的无音乐对话故事排到了第1、2名,三个非语言音乐故事落到第3、4、5名。
这个反转说明:音乐输入确实改变了输出的形态,但「更好」取决于评价维度。按创意写作的常规审美,去人格化、围绕时序结构的故事反而吃亏。据原始帖,音频文件、净室转录、两份盲评判词和可复现的技能(npx skills add luchtan-GIT/m4r-data)都已公开在GitHub仓库中。
作曲家自问:这算不算在「教」模型?
作者在帖中反复质疑自己是否无意中引导了模型或自欺欺人。从方法论看,匿名化文件名和设置文本分析对照组是合理的防线,但仍有几个开放问题:样本量仅5个代理、单一提示词、盲评者数量有限,都让结论停留在「有趣的初步信号」层面。
他向社区提出的两个问题值得关注:这个测试方向是否正确?ML研究者会如何测试「未量化音乐(非可预测、非混乱)是否真的帮助代理以不同方式思考或写作」?
对于后者,更严格的路径可能包括:扩大样本与提示多样性、用嵌入距离或困惑度等指标量化输出偏移、设置随机噪声与量化音乐作为额外对照组、以及让盲评者在不知道分组的情况下使用统一评分标准。
困惑度(Perplexity)与嵌入距离:困惑度是语言模型评估中的常用指标,衡量模型对一段文本的“惊讶程度”——困惑度越低,说明文本越符合模型学到的概率分布,即越可预测。若音乐组的输出在困惑度上显著高于对照组,则可能说明其文本更偏离常规套路。嵌入距离则指将文本映射为向量后计算两组输出在语义空间中的距离,可用来量化“输出偏移”的程度。这些指标能将“AI味”从主观感受转化为可测量的统计量,但需注意:偏离常规并不等同于更有创造性或更优质,指标只能描述分布差异,不能替代审美判断。
对AI创作实践的启示
抛开统计严谨性,这个实验提供了一个可操作的观察:非结构化、非语言的艺术输入,可能把语言模型的输出推向非公式化的结构,代价是牺牲一部分可读性和亲和力。对于想让AI摆脱「AI味」的创作者,这提示了一条不同于提示词工程的路径——改变输入的模态和质感,而不只是改措辞。
但也要警惕过度解读。盲评分歧恰恰说明,「跳出可预测模式」和「写出好内容」并非同一件事。音乐组的故事或许更原创,却未必更打动人。这个实验的价值,可能不在于证明音乐能提升AI创造力,而在于暴露出评价标准本身的分裂。
相关推荐

Ollama选模型完全指南:从配置到量化避坑
Ollama选模型完全指南:从查看电脑配置到逛官方模型库,详解Tools、Thinking、Vision、Decision等标签含义,以及参数规模、量化精度与上下文缓存的取舍策略,助你避开卡死闪退的坑。

Ollama默认安全吗?显卡被白嫖的真相与自查指南
Ollama 默认只绑回环地址,但改一句环境变量或照抄 Docker 命令就可能让显卡暴露。本文解析显卡被白嫖的原理、扫描规模与 DNS 重绑定路径,并给出自查与修复的三层方案。

Cherry Studio+MCP实战:搭建自动化AI智能体与本地知识库
基于B站Cherry Studio教程,详解如何配置MCP环境、搭建网页抓取与报告生成等自动化AI智能体,并用Ollama+千问3搭建本地知识库,附实际操作中的踩坑经验。