所有文章
共 17316 篇文章
沃尔沃XC40插混版回归:传感器升级+Gemini AI加持
沃尔沃XC40 PHEV插电式混动版时隔三年重返市场,带来全新外观设计、升级传感器套件及谷歌Gemini AI车机系统。了解这款车型的核心升级亮点、插混回归的市场逻辑及生成式AI进入座舱的深远意义。
暴雪工会赢得历史性合同:游戏业劳工运动迎来转折点
暴雪娱乐员工成功签订历史性工会合同,成为游戏行业劳工运动的里程碑事件。本文深入分析游戏业长期缺乏工会的结构性原因、微软收购后的态度转变,以及这一先例对整个科技和游戏行业劳工权益的深远影响。
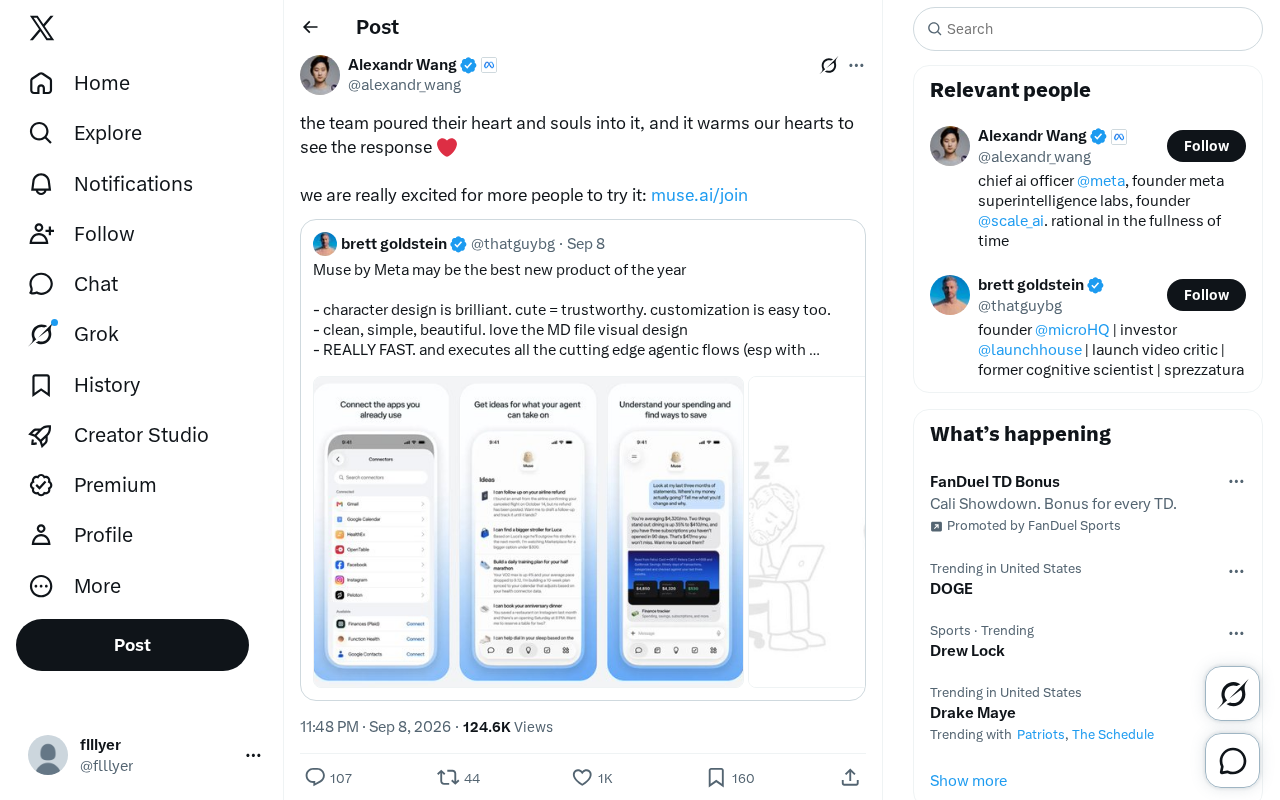
AI产品发布新范式:团队心血与用户社区的双向奔赴
探析AI产品发布中情感叙事与社区驱动增长的新趋势。从一条引发行业关注的推文出发,解读AI团队如何通过真诚投入、开放试用和社区建设,实现产品与用户的双向奔赴,构筑长期竞争壁垒。
Muse使用量超预期10倍:AI产品爆发式增长意味着什么
AI产品Muse上线后实际使用量达到测试组的10倍,远超团队预期。本文深入分析超预期增长背后的产品逻辑、AI行业需求信号,以及这一现象对AI创业者的启示。
Muse:专为说服身边人相信AI有用而生的工具
Muse是一款以「说服家人朋友相信AI真的有用」为定位的AI工具,主打易用性与即时价值。本文深入分析Muse的产品哲学、面向非技术用户的设计思路,以及它对AI应用日常化趋势的行业启示。
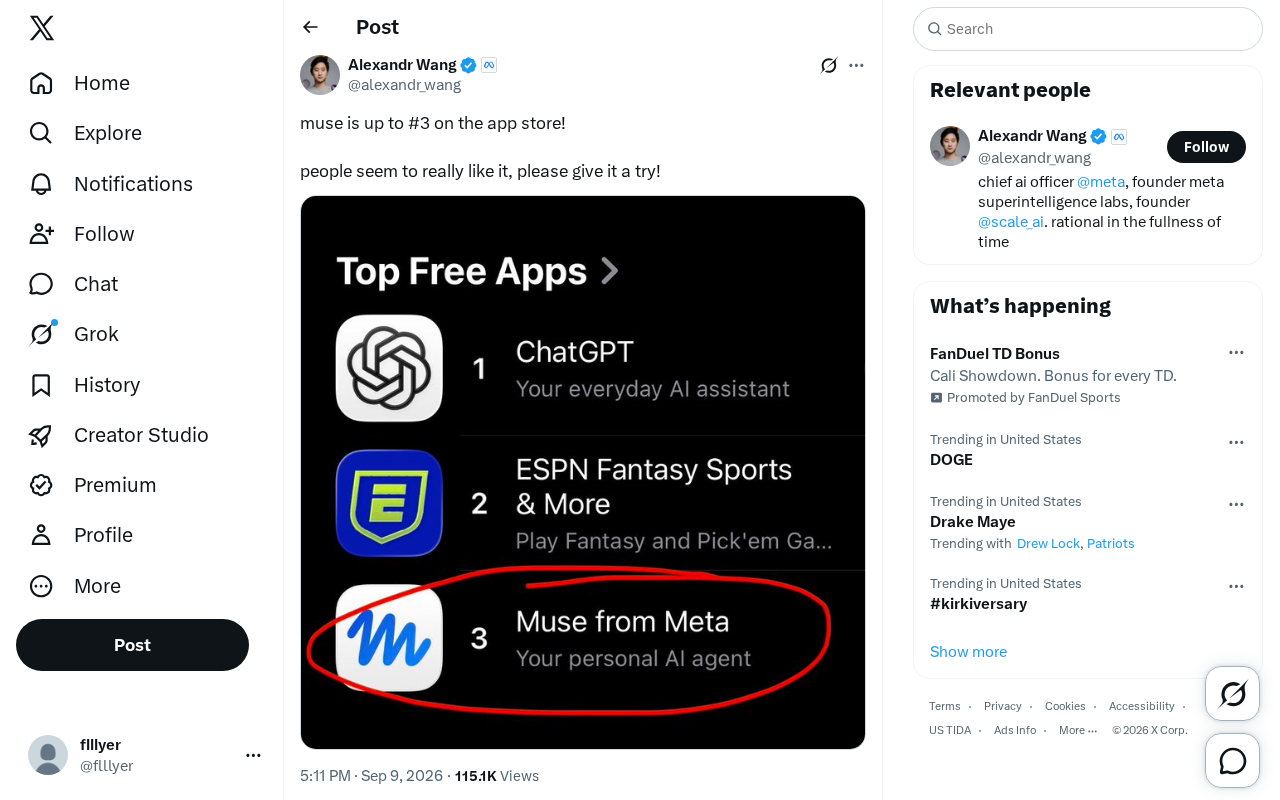
Muse登顶App Store第三名:这款AI社交App为何爆火
AI社交应用Muse迅速冲上App Store总榜第三名,凭借口碑驱动实现爆发式增长。本文解析Muse快速登顶背后的产品逻辑、增长策略及对AI应用赛道的启示。
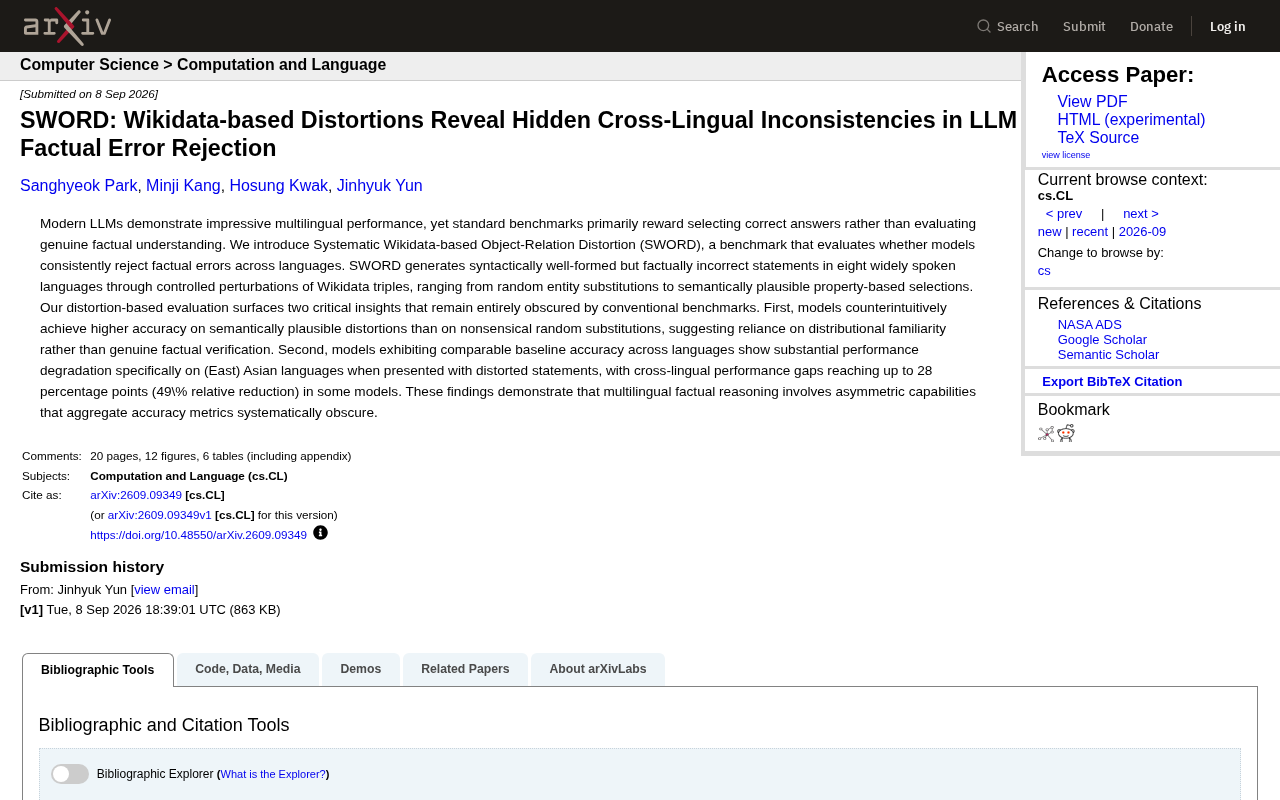
SWORD基准揭示大模型跨语言事实核查的隐藏漏洞
SWORD基准通过反向事实核查评估,揭示大语言模型在跨语言场景下的两大隐藏缺陷:依赖统计熟悉度而非真正事实验证,以及东亚语言性能最高下降49%。深入解读研究发现及其对AI部署的启示。
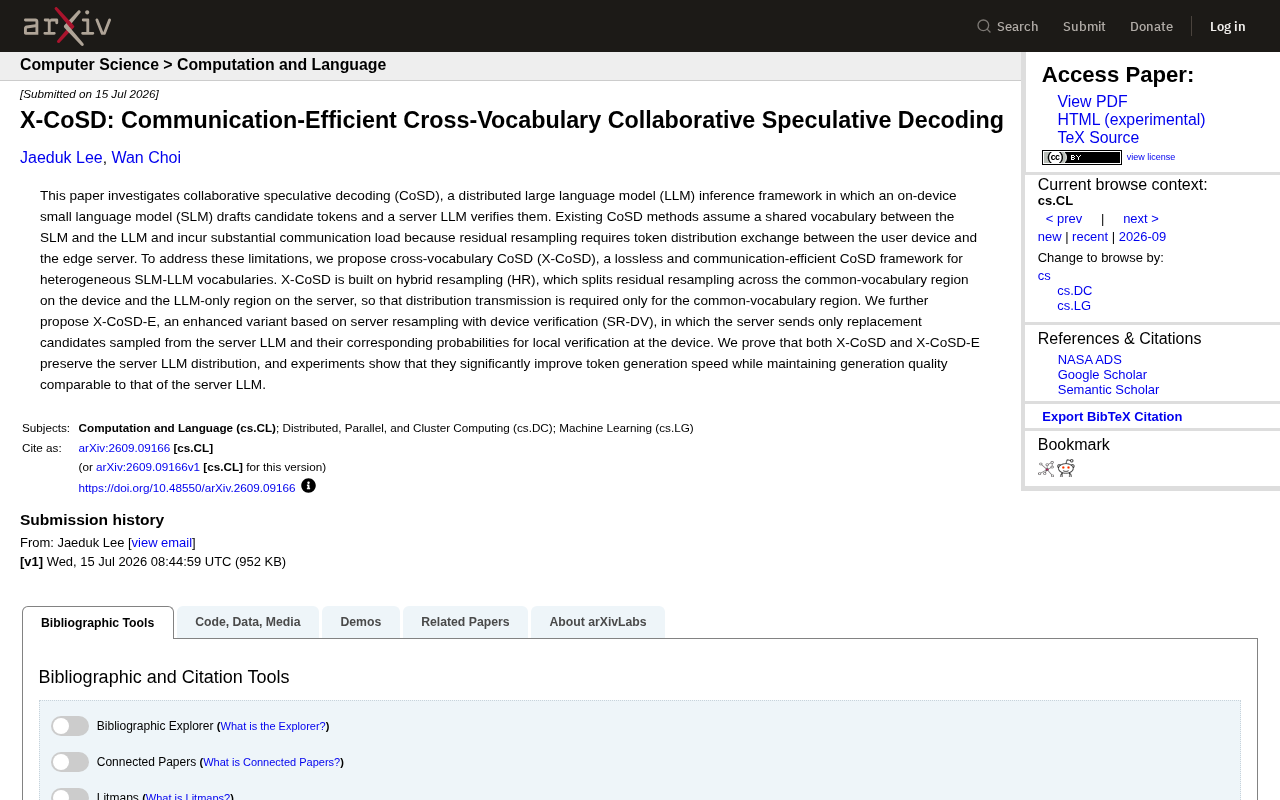
X-CoSD框架详解:跨词表协作推测解码如何加速LLM推理
深入解析X-CoSD跨词表协作推测解码框架,通过混合重采样机制打破共享词表限制,大幅降低分布式LLM推理通信开销,实现无损加速。涵盖核心原理、增强版X-CoSD-E及应用前景。
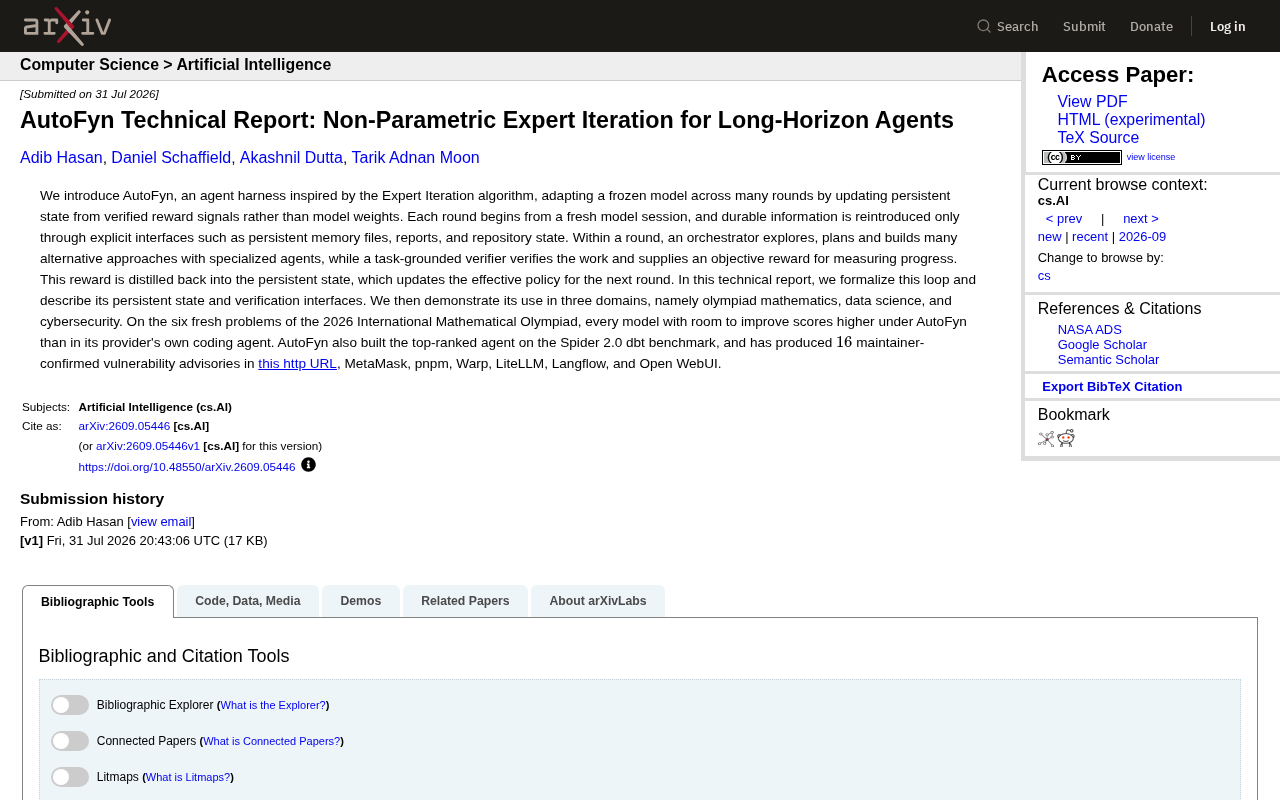
AutoFyn框架:冻结模型的专家迭代优化方法
AutoFyn是一种创新的智能体架构,通过持久化状态和验证奖励实现冻结模型的性能提升。已在数学竞赛、数据科学和网络安全领域验证有效,Spider 2.0排名第一,发现16个开源项目漏洞。
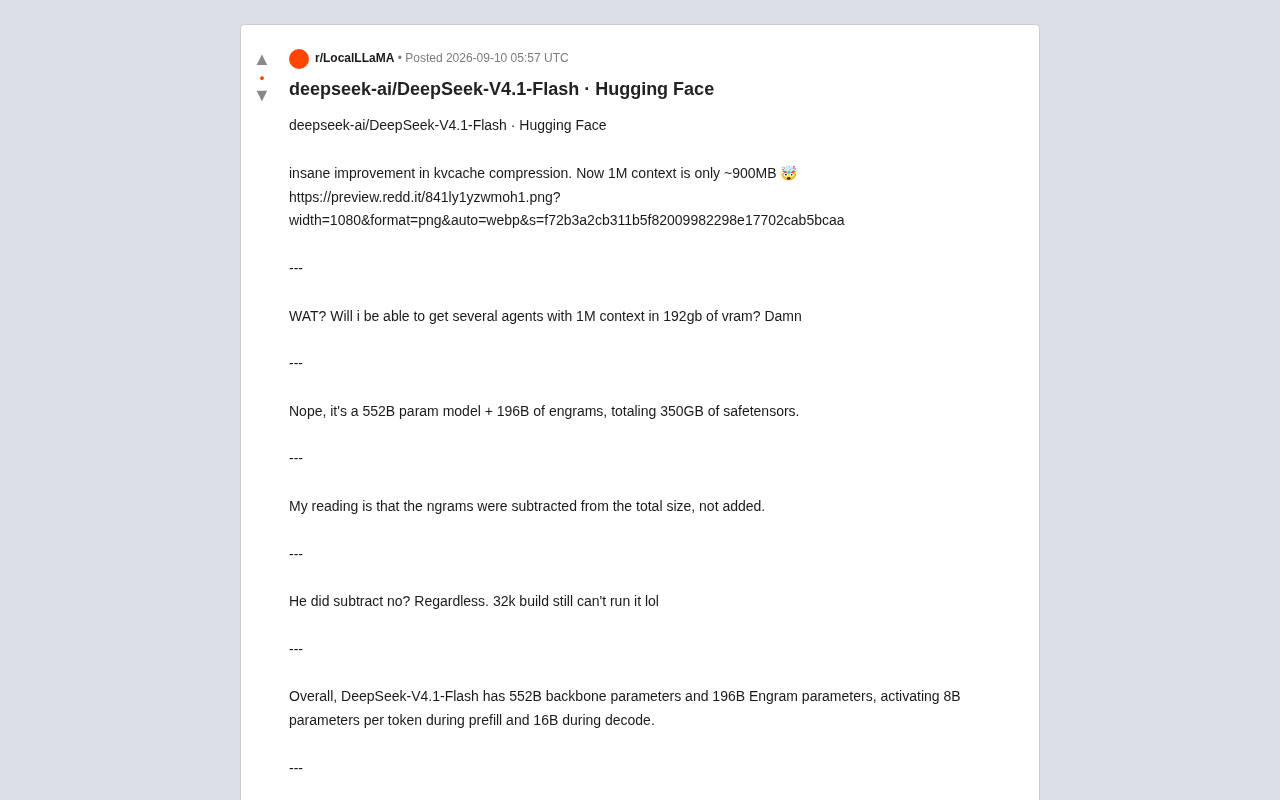
DeepSeek-V4.1-Flash深度解析:1M上下文仅需900MB显存的秘密
DeepSeek-V4.1-Flash模型KV缓存压缩取得突破,1M token上下文窗口仅占用约900MB显存。本文解析其552B主干+196B Engram架构、激活参数机制及对长上下文推理成本的颠覆性影响。
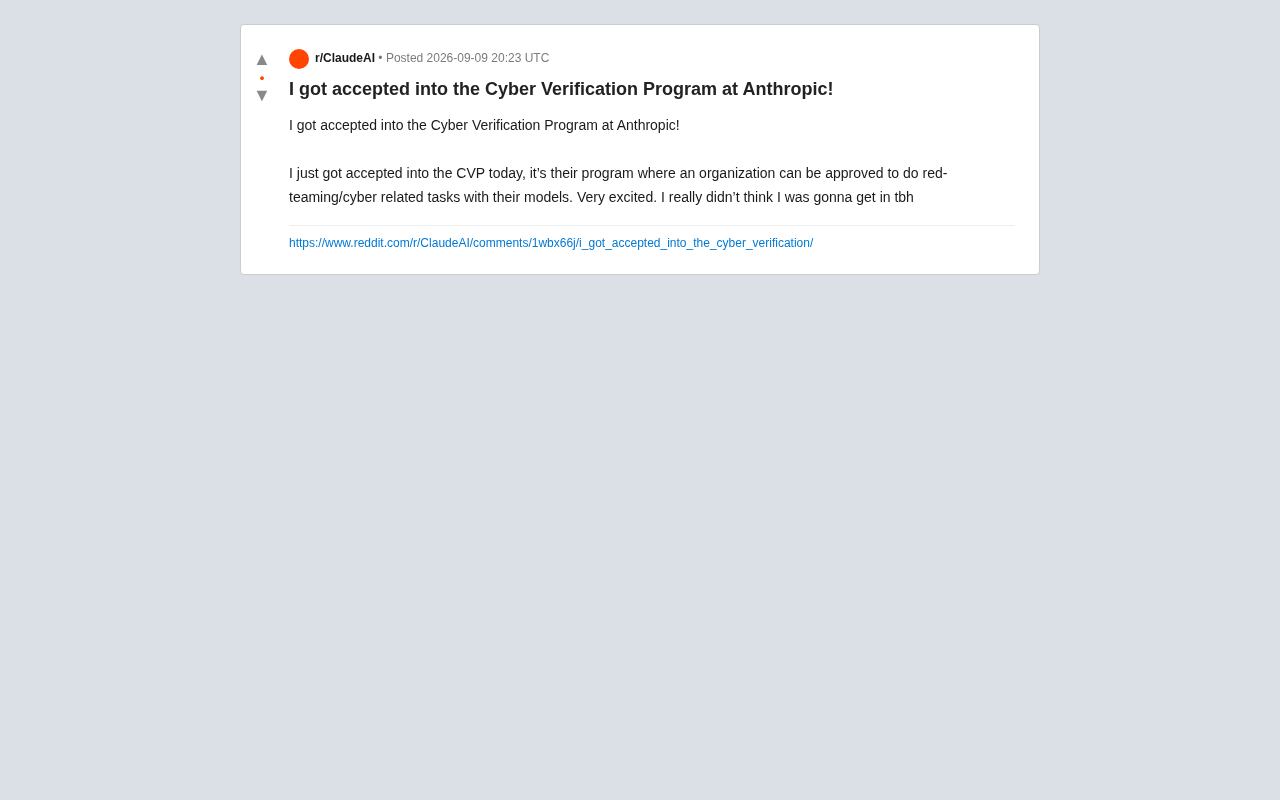
Anthropic网络验证计划(CVP)详解:AI红队测试的官方授权通道
深入解读Anthropic网络验证计划(CVP)的运作机制与申请价值。CVP为经审核的安全组织提供AI红队测试授权,允许在Claude模型上执行网络安全探测任务,标志着AI安全进入厂商与外部研究者协同防御的新阶段。
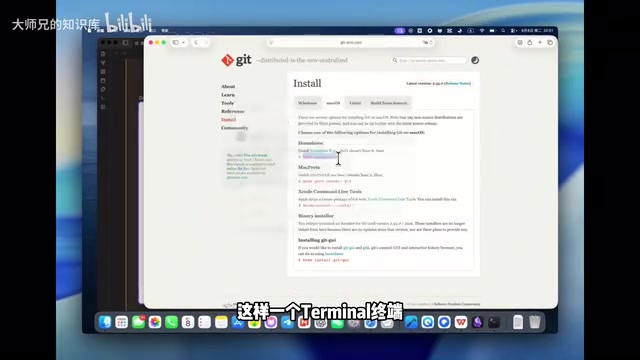
Claude Code和Codex做数学建模:从提示词到Agent工作流实战
详解如何用Claude Code、Codex等代码智能体构建数学建模Agent工作流,深入拆解Tools、Hooks、Skills、Subagent五大核心能力,告别提示词仓鼠式用法,让AI真正自主完成建模全流程。
AI恶搞基准测试走红:跑分文化背后的社区减压与反思
Reddit社区恶搞AI基准测试项目走红,以荒诞幽默解构模型跑分军备竞赛。本文解析这一现象背后的技术社区文化,探讨开发者如何用玩梗消解AI焦虑,以及基准测试过度营销带来的行业反思。
AI合成病毒是真实威胁还是技术恐慌?理性分析生物工程风险
AI能否设计超级病毒?本文从生物工程现实门槛、技术可行性、安全监管等角度,理性分析AI合成病毒威胁的真实性,探讨值得关注的AI安全问题。
VGDL编译为因果模型:游戏AI如何理解真实规则
探索将视频游戏描述语言VGDL编译为动态结构因果模型的创新方法,解决强化学习和大语言模型在游戏AI中的因果推理难题,实现100%因果保真度,支持反事实推理与可解释AI。
LLM面对输入数据与内部记忆冲突时会犯更多错误吗?
最新研究探讨大语言模型在输入数据与参数记忆冲突时的忠实度表现。通过多语言实验对比事实、反事实和虚构数据,发现上下文-记忆冲突对LLM忠实度的影响出人意料地微弱,对RAG系统设计具有重要启示。
StochBench:首个随机过程Lean形式化证明基准详解
StochBench是首个针对随机过程领域的Lean 4形式化证明基准,包含450道研究生级别题目,覆盖马尔可夫链、鞅理论、布朗运动等核心主题。本文解析其设计思路、AI测试结果及对形式化数学发展的意义。
SciLitBench:评估LLM系统性文献综述能力的全流程基准测试
SciLitBench是首个覆盖系统性文献综述全流程的LLM基准测试,涵盖标题摘要筛选、全文筛选和数据提取三个阶段。研究发现LLM在高召回筛选中表现可靠,但证据提取准确率仍有明显不足,明确了人机协作的实用边界。