279M文本排序器击败2B/7B视觉语言模型:乌尔都语GUI定位新突破
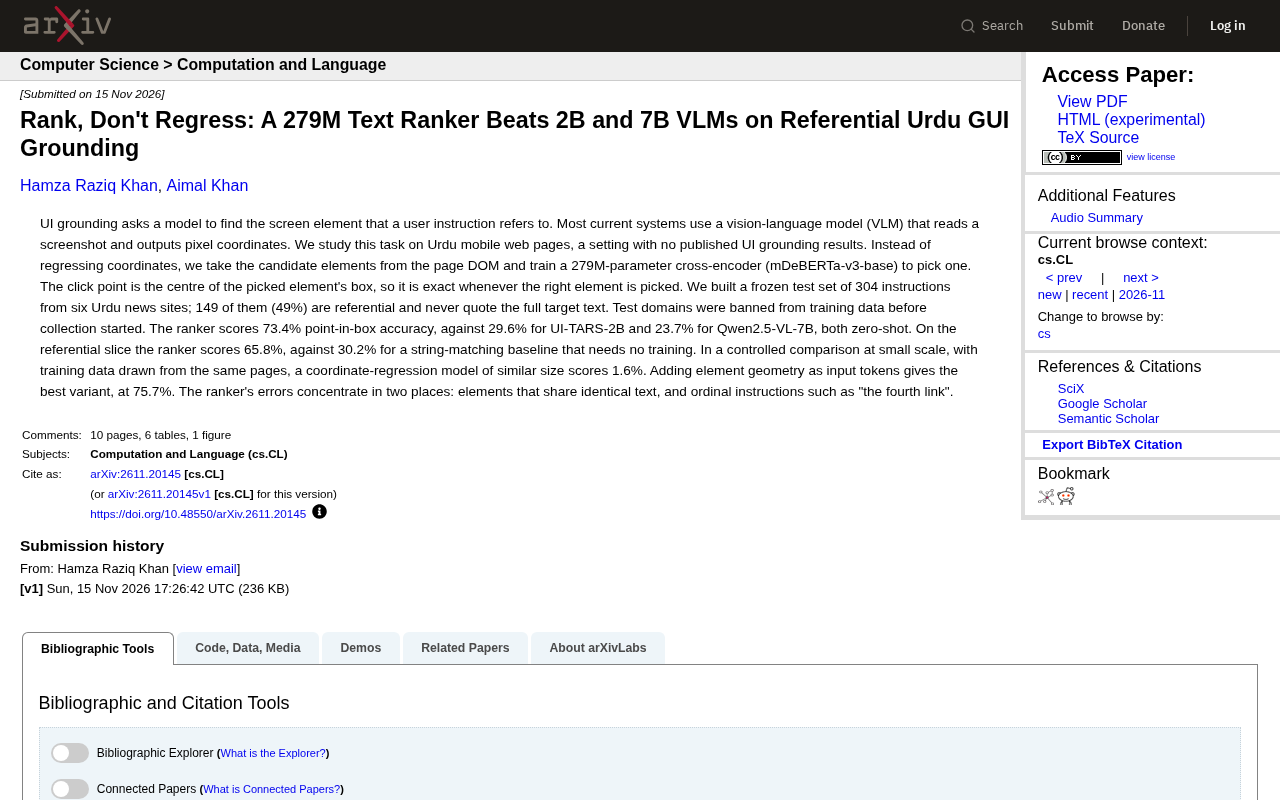
279M文本排序器利用DOM候选元素排序,在乌尔都语GUI定位上以73.4%准确率远超2B/7B视觉语言模型。
一项针对乌尔都语移动网页的UI定位研究提出“排序而非回归”的新思路:不直接回归坐标,而是从页面DOM提取候选元素,用279M参数的交叉编码器(基于mDeBERTa-v3-base)选择正确元素。在包含304条指令的冻结测试集上,该排序器点中框准确率达73.4%,而零样本UI-TARS-2B和Qwen2.5-VL-7B分别仅为29.6%和23.7%。在指代性指令子集上,排序器得65.8%,字符串匹配基线仅30.2%。相同数据下坐标回归模型准确率仅1.6%,加入元素几何信息后最佳变体达75.7%。错误主要集中在文本相同的元素和序数指令。研究证明小模型在特定语言GUI定位任务上可显著超越大VLM,但方法依赖DOM结构且需改进元素区分与序数推理。
UI定位任务要求模型找到用户指令所指的屏幕元素。主流方案使用视觉语言模型(VLM)读取截图并输出像素坐标。然而,一项针对乌尔都语移动网页的研究提出了不同思路:不回归坐标,而是从页面DOM中提取候选元素,训练一个279M参数的交叉编码器(基于mDeBERTa-v3-base)来选择正确元素。
方法:排序而非回归
研究团队构建了一个包含304条指令的冻结测试集,来自六个乌尔都语新闻网站。其中149条(49%)为指代性指令,从不引用完整的目标文本。测试域名在数据收集开始前就被禁止进入训练数据,确保评估的公正性。
与直接输出坐标的VLM不同,该方法利用页面DOM获取候选元素列表,让模型从中挑选。点击点即为所选元素框的中心,因此只要选对元素,点击位置就精确无误。
交叉编码器(Cross-Encoder) 是一种将两个输入序列(如查询和候选文档)拼接后送入同一Transformer编码器进行联合建模的架构,输出一个相关性分数。与双编码器(分别编码查询和文档再计算相似度)不同,交叉编码器能捕捉查询与候选之间的细粒度交互,但计算成本随候选数量线性增长。本文中,模型将乌尔都语指令和DOM元素文本拼接,由mDeBERTa-v3-base编码后输出匹配分数,再对所有候选排序。
mDeBERTa-v3-base 是微软提出的多语言DeBERTa V3基础版模型,参数量约2.79亿,支持100多种语言。DeBERTa V3采用解耦注意力机制和ELECTRA风格替换令牌检测预训练,在多语言自然语言理解任务上表现优异。本文选择该模型作为排序器 backbone,正是看中其多语言能力与适中规模,便于在乌尔都语等低资源语言上微调。
实验结果:小模型大幅领先
在点中框(point-in-box)准确率上,279M排序器达到73.4%,而零样本的UI-TARS-2B仅为29.6%,Qwen2.5-VL-7B为23.7%。在指代性指令子集上,排序器得分为65.8%,无需训练的字符串匹配基线为30.2%。
一项小规模受控对比显示,类似大小的坐标回归模型准确率仅为1.6%。加入元素几何信息作为输入token后,最佳变体达到75.7%。
点中框(point-in-box)准确率 是UI定位任务中常用的评估指标:模型预测的点击坐标若落在目标元素的边界框内,则视为正确。该指标直接反映用户能否成功点击目标,比坐标绝对误差更贴近实际体验。本文所有准确率均基于该指标计算。
错误分析:重复文本与序数指令
排序器的错误集中在两类情况:文本完全相同的元素,以及序数指令(如“第四个链接”)。这表明模型在区分相同文本元素和处理相对位置指令时仍有困难。
序数指令 指用户通过相对位置(如“第四个链接”“第二个按钮”)来指代界面元素,而非依赖元素文本内容。这类指令要求模型理解页面元素的排列顺序并计数,对仅基于文本排序的模型构成挑战,因为候选元素文本本身不包含位置信息。本文错误分析显示,排序器在序数指令上表现较弱,提示未来需引入布局或顺序特征。
意义与局限
该研究首次在乌尔都语移动网页上建立UI定位基准,证明排序方法在参数量远小于VLM的情况下显著更优。但方法依赖于DOM结构,且错误模式提示需要进一步改进元素区分和序数推理能力。
相关推荐
B站UP主预告烟花vlog:AI科技内容创作的新风向?
B站UP主发布乌尔都语对话片段,预告烟花vlog即将到来。素材缺乏AI科技实质内容,本文如实分析其信息局限,探讨内容创作预热策略。
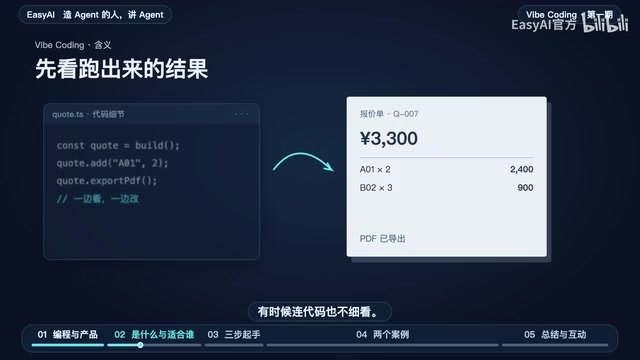
Vibe Coding做出来的东西没人用?编程容易产品难
Vibe Coding让AI写代码变简单,但demo跑通不等于产品可用。从报价工具到Agent Hub左手操作,拆解编程容易产品难的原因,给出不懂技术也能做出可用工具的三步方法。
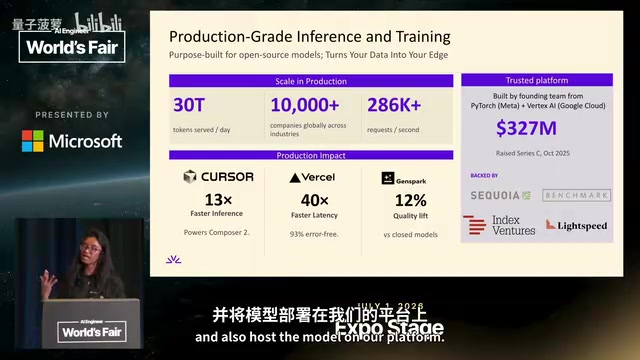
Fireworks AI:开源模型如何靠训练部署飞轮比肩闭源
Fireworks AI 应用机器学习负责人 Jet 详解开源模型如何通过自研推理引擎、三种训练形态与训练推理同平台的数据飞轮,在延迟、成本和质量上比肩闭源模型。