#学术诚信
共 8 篇相关文章

·6 分钟
30个AI模型面对42篇问题论文:93%不质疑直接续写
一项针对30个主流AI模型的测试发现,面对42篇撤稿、造假或伪科学论文,模型平均93%的情况下会顺着问题前提继续设计实验。表现最好的Claude Sonnet 5失败率仍达72%。文章解析测试方法、模型"记忆而非推理"的机制,以及对研究类AI产品的具体改进建议。
阅读全文 →

·7 分钟
AI检测器如何工作?揭秘AI内容识别背后的原理
AI检测器究竟如何工作?本文深入解析AI内容识别背后的原理,包括困惑度、突发性和机器学习分类,剖析其准确性、误报局限以及与查重工具的区别,帮助你负责任地解读检测结果。
阅读全文 →
·3 分钟
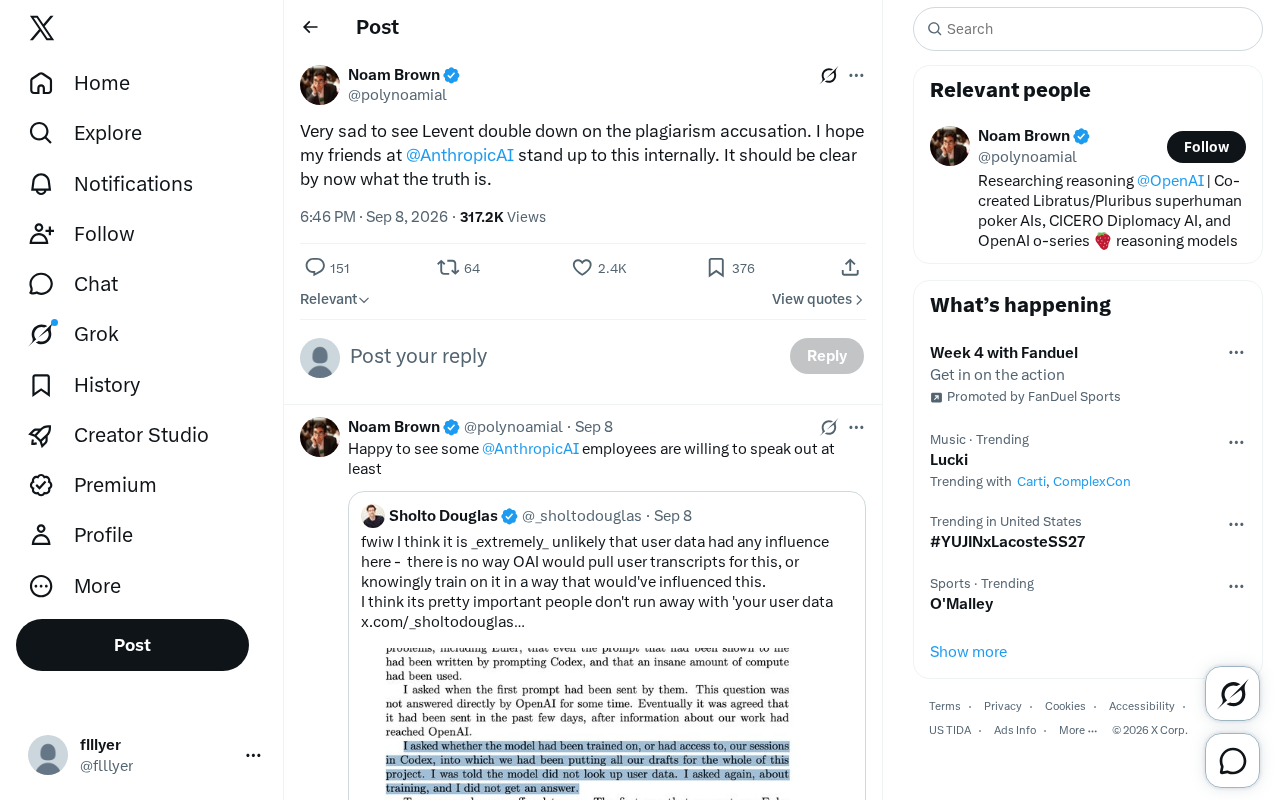
AI圈剽窃指控争议:一条推文背后的信任危机
一条科技圈推文揭示AI行业的剽窃指控争议,发帖者呼吁Anthropic内部发声澄清真相。本文梳理事件背景,并探讨AI领域成果归属与信任机制面临的治理挑战。
阅读全文 →
·3 分钟
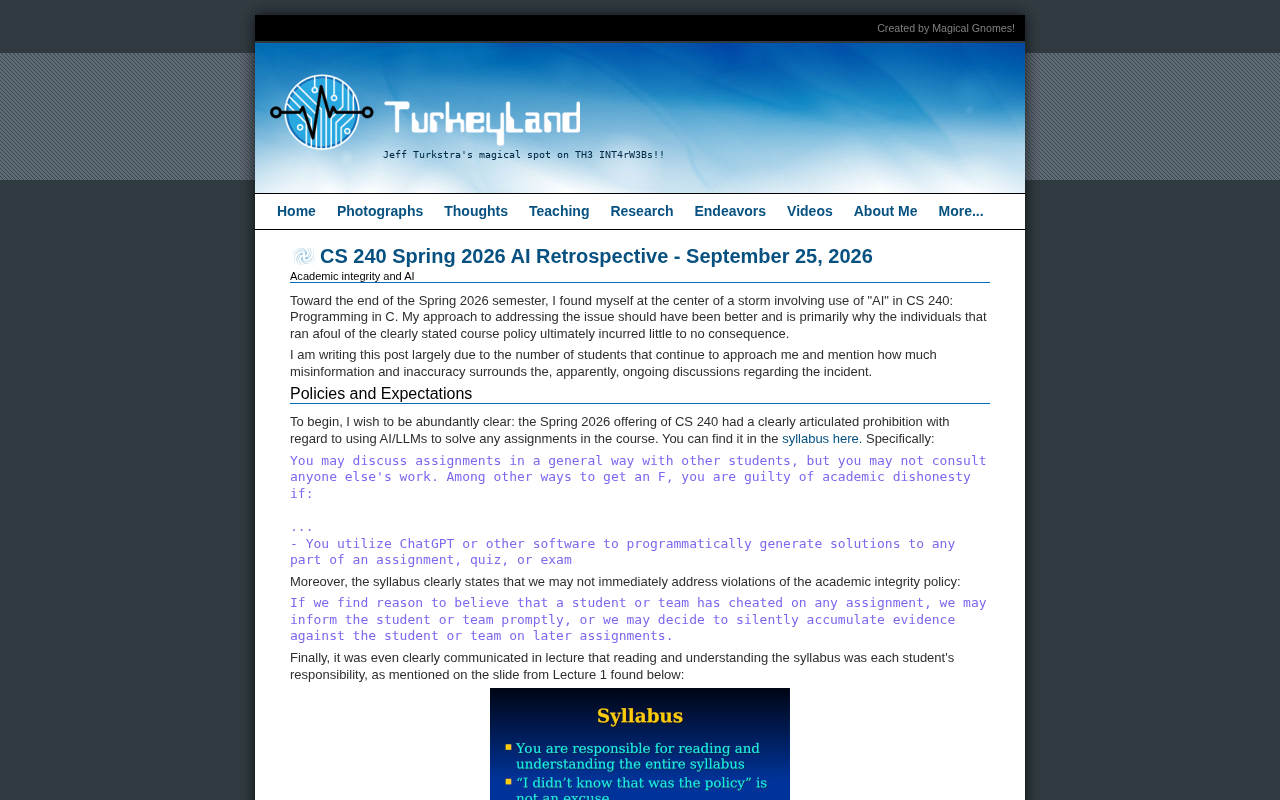
CS240作弊事件复盘:AI时代的学术诚信困境
CS240编程课AI作弊事件复盘:分析生成式AI为何冲击传统编程教学,探讨代码作弊检测难题与教学评估方式的改革方向,折射AI时代学术诚信的普遍困境。
阅读全文 →
·7 分钟
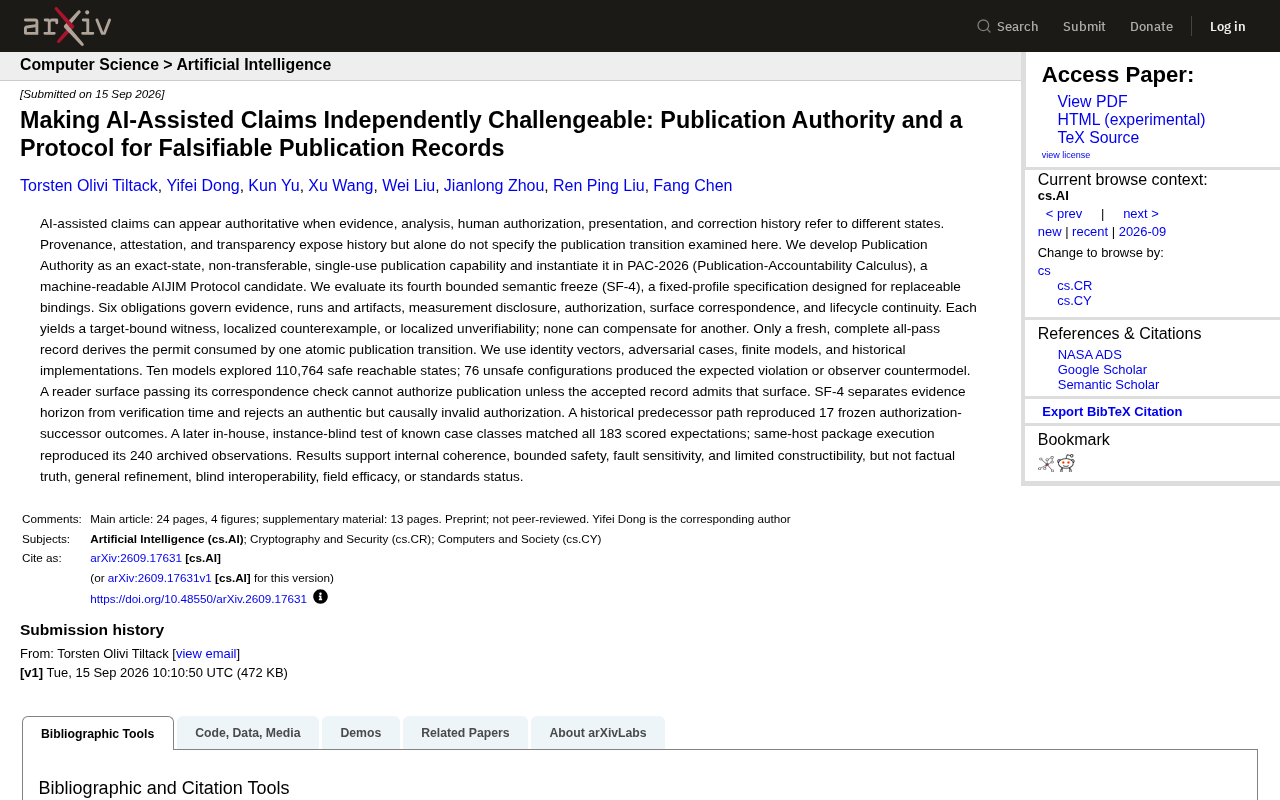
让AI辅助结论可被独立质疑:PAC-2026可证伪发布协议解析
arXiv研究提出PAC-2026发布问责演算与Publication Authority概念,通过六项不可相互补偿的义务和11万状态验证,让AI辅助结论的发布动作变得可证伪、可独立质疑。本文解析其核心机制与边界。
阅读全文 →
·4 分钟
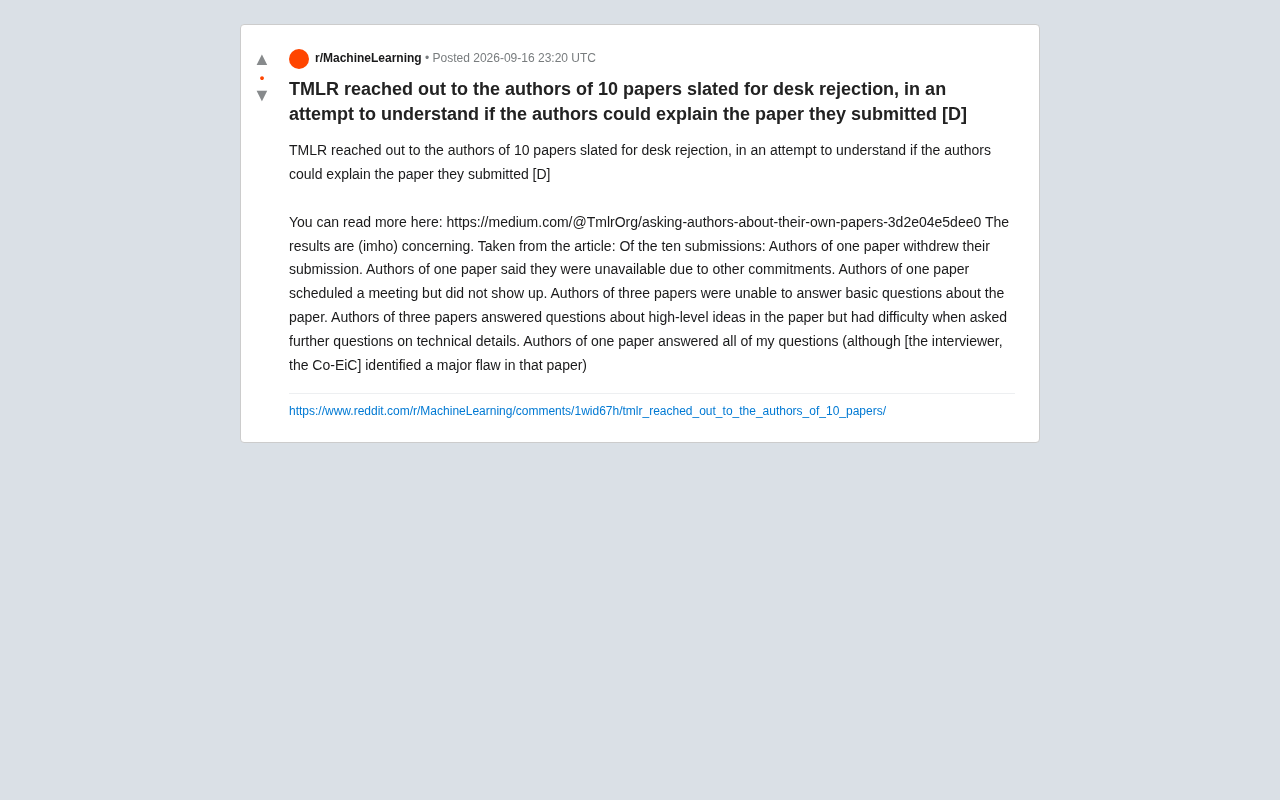
TMLR新实验:让作者解释自己的论文,结果令人担忧
机器学习期刊TMLR联系10篇桌拒论文的作者,请他们亲口解释自己的投稿,结果令人担忧:多数作者无法回答基础问题或讲不清技术细节。本文解读这一实验及其对AI时代学术诚信与同行评审的启示。
阅读全文 →

