TMLR新实验:让作者解释自己的论文,结果令人担忧
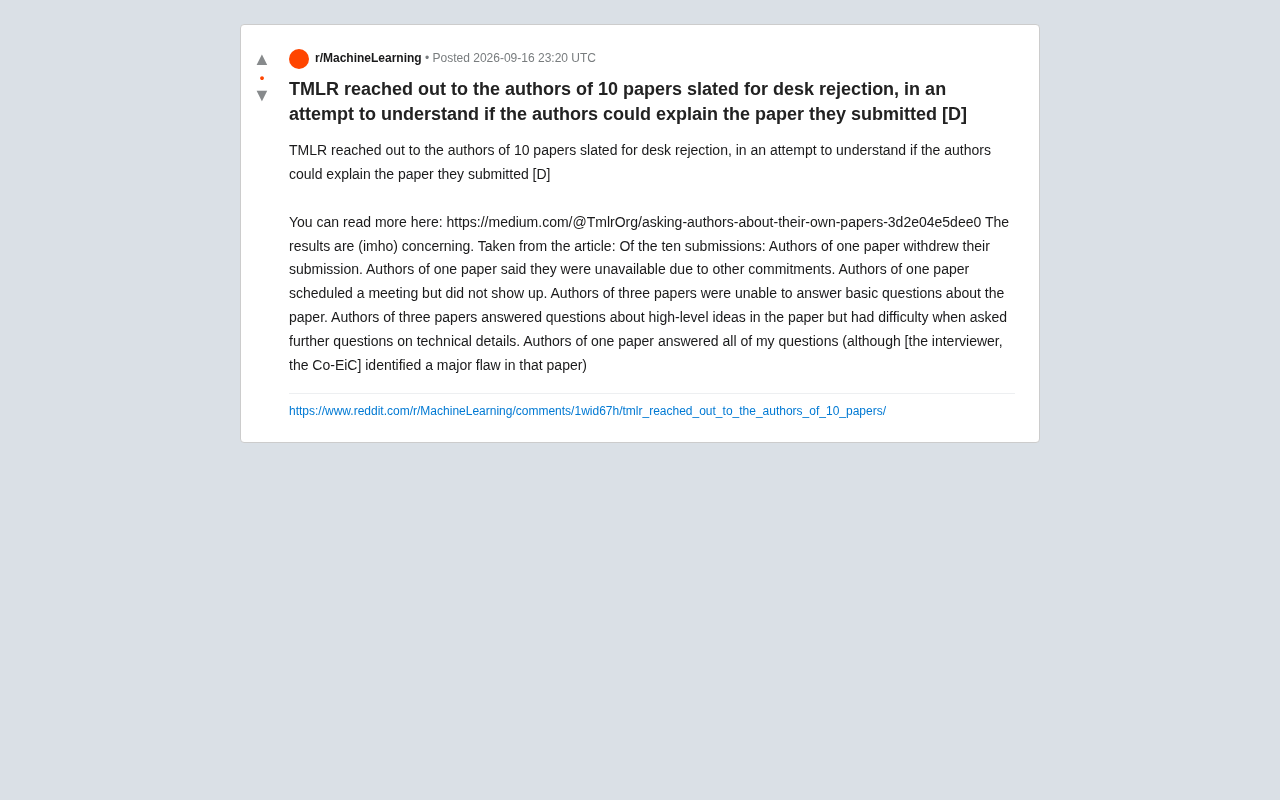
TMLR对10篇桌拒论文发起作者访谈,结果无一通过,揭示AI时代论文真实性危机。
机器学习顶级期刊TMLR对10篇被桌拒的投稿发起了一项特殊实验:联系作者,请其亲口解释自己的论文。结果令人忧虑:1篇直接撤稿,1篇推辞,1篇爽约,3篇作者答不出基础问题,3篇只能谈高层思路而回避技术细节,仅1篇作者全程作答——但编辑在交流中仍发现了重大缺陷。10篇论文无一经得起这道最朴素的检验。实验折射出大语言模型普及后"论文灌水"问题的严峻现实:生成式AI大幅降低了产出"形式完整"论文的门槛,却无法赋予署名者对研究的真正理解。TMLR此举实质上是在探索一种低成本的真实性验证机制,并向学术界传递明确信号:署名意味着责任。
机器学习顶级期刊 TMLR(Transactions on Machine Learning Research)做了一件颇具争议却又意味深长的实验:面对 10 篇被列入桌拒(desk rejection)名单的投稿,编辑部主动联系作者,请他们亲口解释自己提交的论文。这个看似简单的做法,却揭开了当下学术界一个愈发严峻的问题——论文的真正作者到底是谁?
据 TMLR 官方在 Medium 上发布的说明文章披露,实验结果令人深思。
十篇论文,十种回避
TMLR 联合主编(Co-EiC)亲自出面,向这 10 篇论文的作者逐一发出访谈邀请。最终的统计结果颇具戏剧性:
- 1 篇:作者直接撤回了投稿;
- 1 篇:作者以"另有安排、无法参与"为由推辞;
- 1 篇:作者约好了会议时间,却临场未现身;
- 3 篇:作者无法回答关于论文的基础问题;
- 3 篇:作者能谈论论文的高层次思路,但一旦被追问技术细节便难以招架;
- 1 篇:作者回答了全部问题,但访谈者(联合主编)却在过程中发现了该论文的一个重大缺陷。
换句话说,10 篇论文中没有一篇经得起"作者亲自答辩"这道最朴素的检验。要么作者主动逃避,要么无法解释自己署名的研究内容。这一结果被原帖作者形容为"concerning"(令人担忧),社区的普遍反应也大抵如此。
桌拒之外,问题指向何方
桌拒本身是编辑在正式送审之前,对明显不合格投稿的快速筛除。TMLR 之所以对这批论文额外发起访谈,并非要给它们翻案的机会,而是想验证一个日益普遍的疑虑:这些论文究竟是不是作者本人真正理解、真正参与撰写的成果。
从结果看,答案相当负面。当一位署名作者无法回答关于自己论文的基础问题,或者只能复述"高层次思路"却讲不清技术实现,这背后往往指向几种可能:论文由第三方代写、大量依赖生成式 AI 拼凑内容、或是挂名而未实质参与研究。无论哪一种,都触及了学术诚信的底线。
值得关注的是那篇"作者对答如流"的论文——即便作者能回答所有问题,编辑仍在交流中识别出一个重大技术缺陷。这提示我们,作者能解释论文只是及格线,论文本身的科学质量是另一道关卡。
学术署名规范(authorship norms)在国际学术界有明确的伦理准则,例如国际医学期刊编辑委员会(ICMJE)要求每位作者必须对研究的设计、数据采集或分析有实质贡献,并能对研究内容负责。"挂名作者"(honorary/guest authorship)和"幽灵作者"(ghost authorship)长期以来都被视为学术不端行为。生成式AI的普及将这一问题推向新的极端——当论文的实质内容由大模型生成,而署名者仅负责提交,传统署名伦理框架面临根本性挑战。目前多数顶级期刊要求作者声明AI工具的使用情况,但如何区分"辅助润色"与"实质代写",在实践中仍缺乏可操作的统一标准。
AI时代的论文洪流与同行评审困境
这一实验的时代背景不容忽视。随着大语言模型的普及,撰写一篇"看起来像模像样"的机器学习论文的门槛被大幅拉低。生成式工具可以在短时间内产出结构完整、术语准确、甚至配有公式和实验表格的文本,但这些内容未必对应真实的研究工作,作者本人也未必真正理解。
对于 TMLR 这类采用滚动投稿、强调严谨评审的期刊而言,投稿数量的激增与质量的稀释形成了尖锐矛盾。传统的同行评审依赖审稿人逐字审读,成本高、周期长,面对海量低质甚至"AI 灌水"投稿时容易不堪重负。TMLR 的这次尝试,实际上是在探索一种低成本的"真实性验证"手段——直接和作者对话,用最人性化的方式检验论文的真实归属。
TMLR(Transactions on Machine Learning Research)由机器学习基金会(MLF)主办,于2022年创刊,定位为全开放获取、持续滚动收稿的期刊,有别于传统一年数期的批量出版模式。其评审机制强调在固定时限内完成审稿,并鼓励作者与审稿人之间的透明互动。正因为采用滚动投稿制,TMLR没有截止日期带来的自然流量调节,理论上任何时间都可能面临投稿涌入的压力。这使得它在应对AI辅助写作浪潮时比传统会议(如NeurIPS、ICML)更缺乏缓冲空间,也让这次真实性验证实验的动机更加迫切。
这套方法能推广吗
"让作者解释自己的论文"听起来简单,但要成为常规评审流程仍面临不少挑战。
访谈需要编辑或审稿人投入大量时间,10 篇论文尚可逐一约谈,面对成千上万的投稿显然无法规模化。同时,口头答辩的公平性也需要考量——语言能力、临场表达、时区与身份差异都可能影响作者表现,这与论文的学术价值并不完全等同。此外,如何界定"回答不上来"的标准、是否给作者充分准备时间,也都需要制度化的规范。
不过,作为一种针对性的抽查或申诉机制,这种做法的价值是明确的。它向学术共同体传递了一个信号:署名意味着责任,作者应当能够对自己的研究负责并作出解释。在 AI 生成内容真假难辨的当下,这条最古老的检验原则反而显得格外珍贵。
给研究者的提醒
对于投身机器学习研究的个人和团队,TMLR 的这次实验是一记警钟。使用 AI 辅助写作、整理文献、润色语言本无可厚非,但如果论文的核心贡献、技术细节乃至实验结论都不是作者真正掌握的内容,那么再精美的排版也无法通过"作者答辩"这一关。
学术诚信从来不只是形式合规,而是研究者对自己工作的真正理解与担当。随着期刊和会议逐步引入更多真实性验证机制,那些依赖捷径产出的论文,未来将越来越难以蒙混过关。
相关推荐
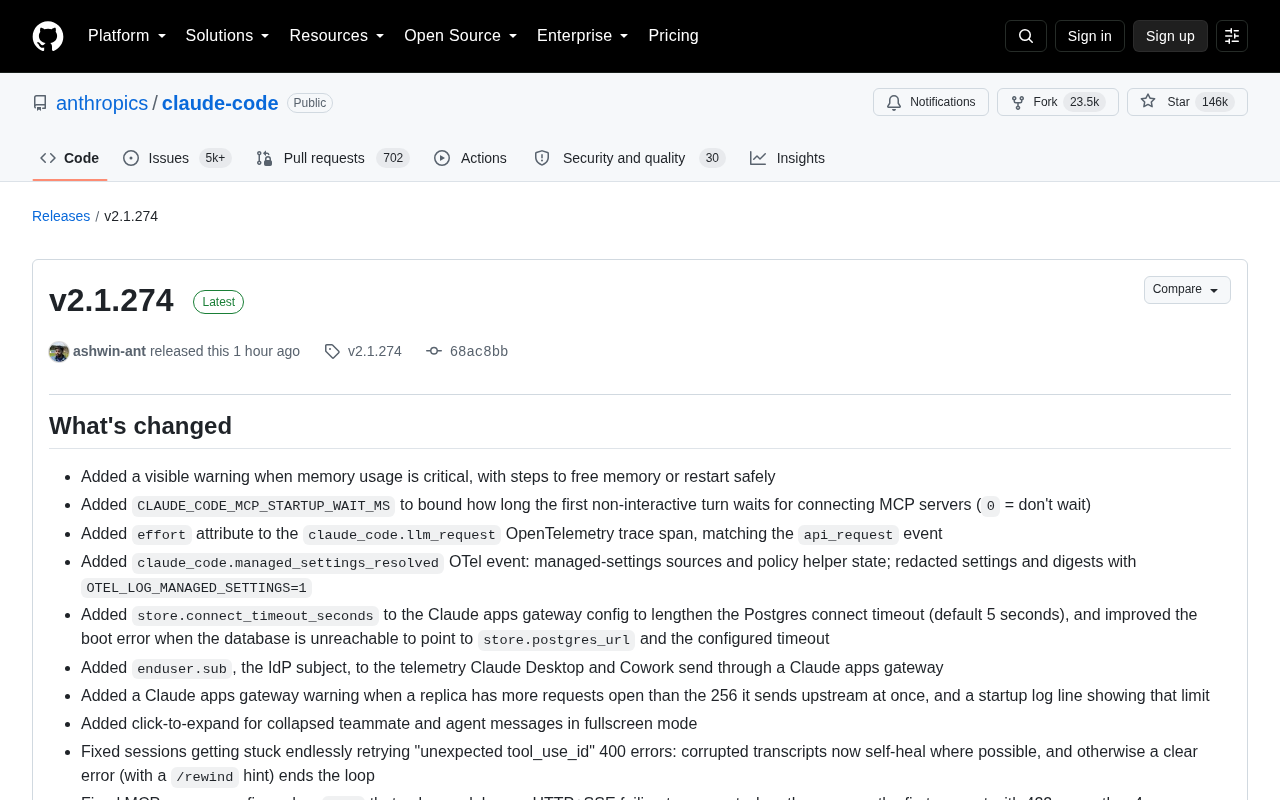
Claude Code v2.1.274 更新解析:MCP 稳定性、内存告警与 VSCode 体验全面升级
Claude Code v2.1.274 版本更新详解:新增内存临界告警、修复大量 MCP 连接与超时问题、优化会话恢复与 /goal 上下文管理,并大幅改进 VSCode 插件可访问性与云端会话体验。
AI助手横向对比:Grok、Claude与ChatGPT谁更胜一筹
Reddit社区发起AI助手横向对比,Grok Bot在与Claude、ChatGPT Work、Instinct和Muse的较量中胜出。本文解析这场AI助手较量背后的意义及选择AI工具的核心考量维度。
多智能体协作困境:单体正确为何酿成系统混乱
多智能体系统中,每个 AI 智能体单独决策都正确,组合起来却常导致系统混乱。本文剖析局部最优与全局最优的冲突根源,探讨编排层、状态同步与契约设计等稳健协作方案。