#LLM优化
共 4 篇相关文章
·4 分钟
稀疏注意力:长上下文LLM降本之道与遗漏之殇
稀疏注意力通过全到达、滑动窗口和学习型选择器降低长上下文LLM成本,但同一提示词在不同策略下形成不同证据集。本文分析三种方案的降本逻辑、跨段落推理遗漏风险及实践权衡建议。
阅读全文 →
·6 分钟
Agent 重试的真实成本:你付的是整段上下文,不是一次调用
AI Agent 的重试成本远超直觉:你付的不是一次失败调用,而是整段不断增长的对话上下文。本文解析为何三次重试可能花掉 7 倍成本,以及为什么应该用"每个正确答案的成本"替代成功率来衡量 Agent 开销。
阅读全文 →
·6 分钟
多项式逼近加速LLM超越函数:GB200上提速最高8%
arXiv新论文提出用短多项式程序替换LLM中的sigmoid、tanh、SiLU等超越函数,在NVIDIA GB200上实现最高8%的训练吞吐提升,隔离测试更达2.19倍加速,且精度损失可控。
阅读全文 →
 前沿研究
·6 分钟
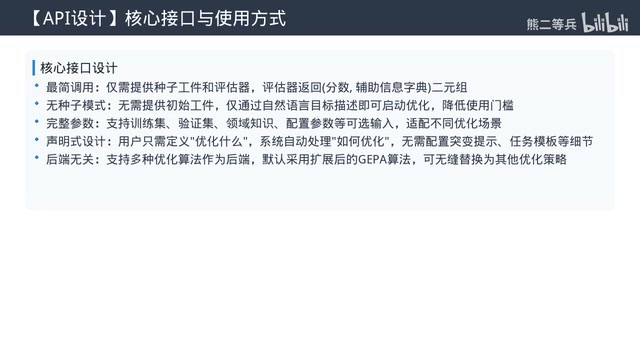
Optimize Anything:一个API统一优化代码、提示词和Agent架构
UC Berkeley与Stanford联合提出Optimize Anything通用文本优化框架,通过一个声明式API统一优化CUDA内核、智能体架构、系统提示词等六大领域,全面超越专用工具。深度解析其三种优化模式、辅助信息机制与Pareto搜索策略。
阅读全文 →