#MoE推理
共 5 篇相关文章

·6 分钟
GC-MoE:用CUDA Green Contexts解耦MoE通信与计算
GC-MoE是一个面向Hopper和Blackwell GPU的开源FP8/FP4 MoE推理算子,利用CUDA Green Contexts将设备划分为通信与计算两个独立分区,实现专家并行下token分发与分组GEMM的真正解耦。在H20与B300上对DeepSeek-V4.1-Flash、GLM-5.2等模型实现稳定加速,并在全部测量点击败Mega MoE。
阅读全文 →

·6 分钟
NVIDIA三层优化让DGX Spark上MoE推理提速42.5%
NVIDIA 在单台 DGX Spark 上通过三项叠加优化加速 MoE 推理,使 124B 模型 Ling-3.0-flash 在 GSM8K 解码吞吐提升 42.5% 且精度不变,本文解析其优化思路与本地部署意义。
阅读全文 →
·4 分钟
DGX Spark 上加速 MoE 推理的三种方法
NVIDIA 开发者博客分享在 DGX Spark 上提升 MoE 推理性能的三条路径:低精度量化、专家调度与缓存优化、推理框架与算子融合,并以 Ling-3.0-flash 的单批次评估说明先定位瓶颈再逐层优化的思路。
阅读全文 →
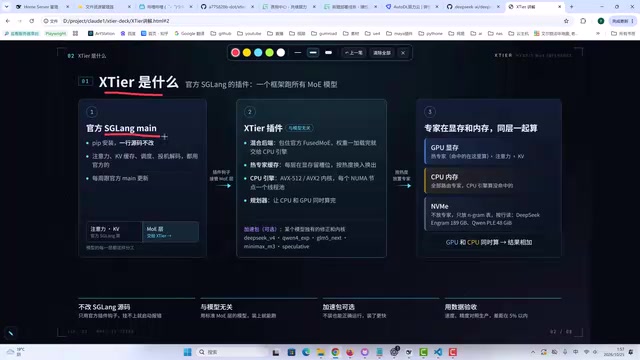
·6 分钟
Xtier插件+SGLang官方版:显存内存混合推理MoE模型实战
B站UP主羊仔开源Xtier插件,基于SGLang官方版实现MoE模型显存内存混合推理,支持加速包可选。本文梳理其设计思路、安装流程,并实测MiniMax M3.1 Flash的速度与前端能力表现。
阅读全文 →

·9 分钟
MoE模型VRAM规划:2026前沿大模型裸金属GPU部署算术
2026年前沿MoE模型私有部署的VRAM规划完整指南:三组件显存公式、DeepSeek-V4.1-Flash与Kimi K2.5等模型的显存参考表、裸金属GPU节点成本拆解与回购经济性分析。
阅读全文 →