Xtier插件+SGLang官方版:显存内存混合推理MoE模型实战
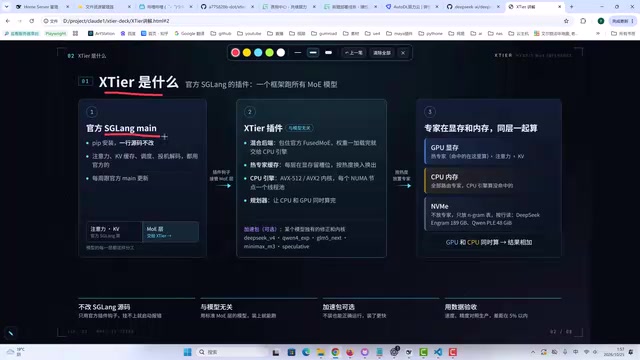
开源插件Xtier让MoE模型在消费级显卡上实现显存内存混合推理,实测MiniMax M3.1 Flash表现拉胯。
B站UP主“羊仔”发布开源插件Xtier,依附SGLang官方框架而不修改源码,为MoE模型增加CPU内存推理能力,让不活跃专家留在内存、活跃专家加载进显存,从而在消费级显卡上运行原本需要专业服务器的大模型。Xtier提供可选的加速包,DeepSeek加速包无损提速,部分模型以约0.3%精度换取速度提升,规划器功能尚在开发。实测中千问3.8最快,DeepSeek与GLM表现正常,而MiniMax M3.1 Flash因每token激活23.5B参数、激活专家达13.2GB,CPU与内存带宽跟不上GPU导致大量空等,速度仅51.6 token/s,前端生成能力也被评价为不如上一代千问3.6 27B。
B站UP主“羊仔”发布了一款名为Xtier的开源插件,它依附于SGLang官方框架,在不修改源码的前提下,为MoE模型提供了显存与内存混合推理的能力。配合官方SGLang和可选的加速包,用户可以在消费级显卡上运行原本需要专业服务器的大模型。本文基于该视频内容,梳理Xtier的设计思路、实测表现,并重点分析MiniMax M3.1 Flash为何“拉胯”。
Xtier是什么:给SGLang加一层“混合推理”外壳
据UP主介绍,Xtier是一个专门为SGLang开发的插件。SGLang官方团队主攻纯GPU推理,而Xtier在其基础上增加了CPU内存推理的支持,让MoE模型可以把不活跃的专家参数放在内存里,只把当前需要的专家加载到显存。
“我们在他基础,因为但他都是纯gpu推理,我们在他基础上呢做一个cpu就内存推理的一个这个插件,我们依附于sglog官方大树底下好乘凉。”
这种设计的关键在于“不改源码、与模型无关”:只要你是MoE模型,理论上都能跑。UP主提到,官方其实有KTransformers接口支持MoE,但效率太低、偏向研究用途,Xtier的目标是把这条路径的生产可用性提上来。
安装与启动流程
使用方式很简单:先安装官方SGLang,再安装Xtier插件。启动时插件会打印详细日志,依次完成启动、拷贝权重到显存/内存、加载专家等阶段。UP主表示,在他的设备上启动大约需要三分钟。
MoE(混合专家)模型是理解Xtier价值的前提。与传统稠密模型每次推理都激活全部参数不同,MoE模型由多个“专家”子网络加一个路由门控组成,每个token只激活其中少数专家。这意味着模型总参数量可能高达数百B,但单次激活的参数远小于总量。Xtier正是利用这一稀疏特性:把当前未被路由选中的专家参数留在CPU内存中,只把活跃专家搬进显存,从而让显存容量有限的消费级显卡也能承载超大模型。代价是专家切换需要经过PCIe总线搬运数据,当激活专家体积过大或内存带宽不足时,GPU会空等数据,形成推理瓶颈。
SGLang是目前主流的开源大模型推理框架之一,以RadixAttention前缀缓存和高吞吐调度著称,官方版本主要面向纯GPU部署。它提供了插件与后端扩展入口,Xtier正是挂载在这一入口上,因此无需fork或修改SGLang源码即可叠加CPU内存推理能力,并能随官方版本迭代持续兼容。这种“寄生式”开发的好处是维护成本低、通用优化对所有模型生效;局限则是受制于官方接口暴露的粒度,某些底层调度策略难以深度定制。
加速包机制:可选的速度与精度权衡
Xtier的另一个核心设计是“加速包”。官方SGLang加Xtier插件就能跑,但速度可能只有65 token/s;加上针对特定模型优化的加速包后,可以提升到137 token/s。
加速包是可选组件,UP主强调并非所有加速包都会损失精度。例如DeepSeek广告的加速包完全不损失精度;部分模型的加速包会有轻微损失,比如0.3%,但换来从76到90 token/s的提升。如果不选加速包,则是完全的全精度推理。
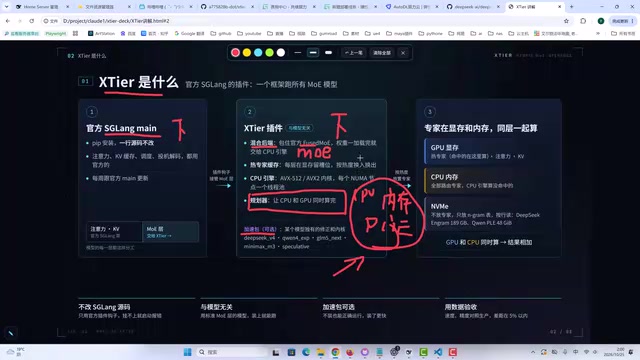
UP主还规划了一个“规划器”功能,目前尚未完成。规划器会根据用户的CPU算力、内存速度、显存算力、显存速度、PCIe交换速度等硬件参数,自动推荐合适的设置和加速包,降低新手的使用门槛。
开发历程:从学习LS济浪到重做引擎
UP主坦言,自己最初是学习B站UP主“爱跳绳的奶龙”开发的LS济浪和LKMo。LS济浪用于混合推理,UP主在其基础上做了一些修改和优化,并在RTX Pro 5000(50系显卡)上验证。
但继续优化遇到瓶颈:LKMo是闭源的,拿不到源码,只能“伪装成他的LKMo”来优化,且主要做的是CPU调度层面的工作。UP主认为,要发挥50系显卡的能力,必须动GPU部分,而闭源环境让这件事很费力。
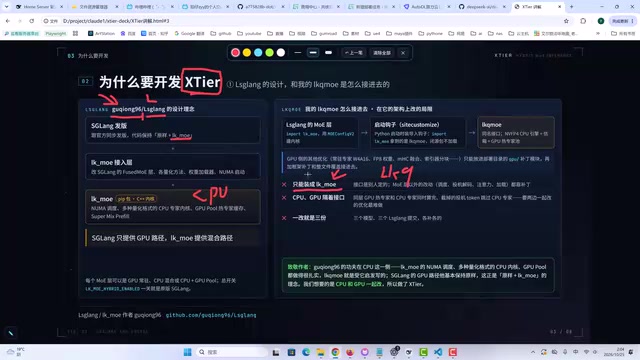
于是UP主选择“打散重做”,直接基于官方SGLang发行版开发Xtier,走官方插件入口,每周跟随官方更新。他明确表示并非破解龙哥的代码,只是参考思路做了针对GPU优化的东西。这种做法的好处是通用优化可以一次开发、所有模型受益,模型特定的优化则打包成加速包,维护成本大幅降低。
SM120是NVIDIA Blackwell架构消费级显卡(如RTX 50系列)的计算能力版本号,而数据中心专业卡对应SM100。不同SM版本在指令集、张量核心特性和显存类型上存在差异,推理框架的算子内核需要针对具体SM版本编译和调优,否则可能无法运行或性能大幅打折。MiniMax官方原先只适配SM100专业服务器,UP主为其补充SM120适配后,速度才从45 token/s提升到51.6 token/s。这也说明开源社区适配消费级显卡的工作,很大一部分是在做算子层面的SM版本兼容。
MiniMax M3.1 Flash实测:速度慢、前端“拉完了”
本期视频的重点是测试MiniMax M3.1 Flash。UP主对该模型的评价相当直接:“说实话他是拉完了,是真的垃圾。”
速度为什么慢
MiniMax M3.1 Flash原生426B参数,官方发布的是量化版本,模型文件仍有200多GB。更关键的是,它每个token需要激活23.5B参数,对应约13.2GB的激活专家数据。作为对比,GLM 5.3的激活专家只有8.8GB。
UP主在SM120设备上做了修复适配(官方原先只支持SM100专业服务器),把速度从45 token/s提升到51.6 token/s,但依然慢。原因在于CPU、内存速度跟不上GPU:GPU算完了在等CPU,时间大量浪费。视频中的黄色条展示了浪费的时间占比,MiniMax浪费了一大半,而千问3.8几乎不浪费。
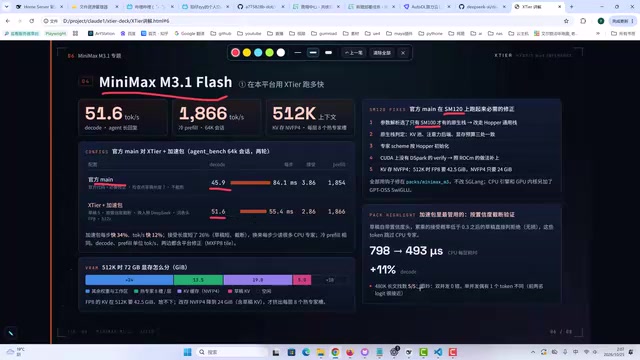
“cpu gpu太强了,cpu不够强,算力太弱了,就是内存速度太慢了,gpu算好了在等,等那个cpu算,所以他浪费时间了。”
激活参数量是衡量MoE推理开销的关键指标,比总参数量更能解释实际速度。MiniMax M3.1 Flash每个token激活约23.5B参数,对应13.2GB的激活专家数据,而GLM 5.3仅8.8GB。在混合推理架构下,这部分数据每生成一个token都要从内存经PCIe送入显存,数据量越大,搬运耗时越长。当GPU算力远强于CPU与内存带宽时,GPU完成计算后只能等待下一批专家数据到位,这段空转就是视频中黄色条所示的“浪费”。因此混合推理的瓶颈往往不在GPU,而在内存带宽与PCIe交换速度的匹配上。
任务实测:前端能力不如上一代
UP主给MiniMax布置了一个任务:从零开始写一个模型启动台,参考DeepSeek之前写的版本(被描述为“特别科幻、人性化”),但剔除了原启动台代码,要求独立完成。
结果MiniMax做出的界面虽然功能齐全——能选择千问、MiniMax、DeepSeek、GLM等模型,有模型路径输入框和运行按钮——但设计简陋,需要用户手动填写路径。UP主评价其前端水平“跟上一代千问3.6 27B差不多”,跳跃能力不行。
速度对比与现状
UP主在视频中给出了当前各模型在Xtier上的速度表现(基于其RTX Pro 5000平台):
- 千问3.8:最快,基本无浪费
- DeepSeek 5.3:与LS济浪改版速度持平,略慢2%,UP主仍在找原因
- GLM 5.3:比LS济浪快
- MiniMax M3.1 Flash:非常慢
UP主表示,MiniMax速度慢的深层原因会在下一期视频中讲解。Xtier项目完全开源,允许用户自行修改适配不同显卡(40系、30系等),也可以自己制作加速包。
对于想跑冷门MoE模型的用户,Xtier提供了一条低门槛路径:先跑起来,再通过社区或自制的加速包逐步优化速度。
相关推荐

64G内存笔记本跑大模型,实际可用仅46.7G
华硕ProArt创16实测:64G内存标称值下模型可用仅46.7G,128G版官方上限1200亿参数。本文拆解9000元内存差价、统一内存占用真相、续航表现,并给出三步自查方法,帮你判断本地跑大模型该买多大内存。
Ollama零基础教程:本地部署大模型入门指南
Ollama零基础入门教程:了解Ollama是什么、核心特点与本地部署大模型的价值。涵盖开源免费、跨平台、CPU/GPU调度、API集成等关键信息,助你快速上手本地大模型管理工具。

LangGraph 实战:开发者真实工作流与技术栈剖析
从 Reddit 开发者提问切入,剖析 LangGraph 在实际生产中的工作流设计、技术栈组合、图结构模式与调试痛点,总结从教程走向落地的关键实践与可观测性需求。