#PPO
共 3 篇相关文章
·7 分钟
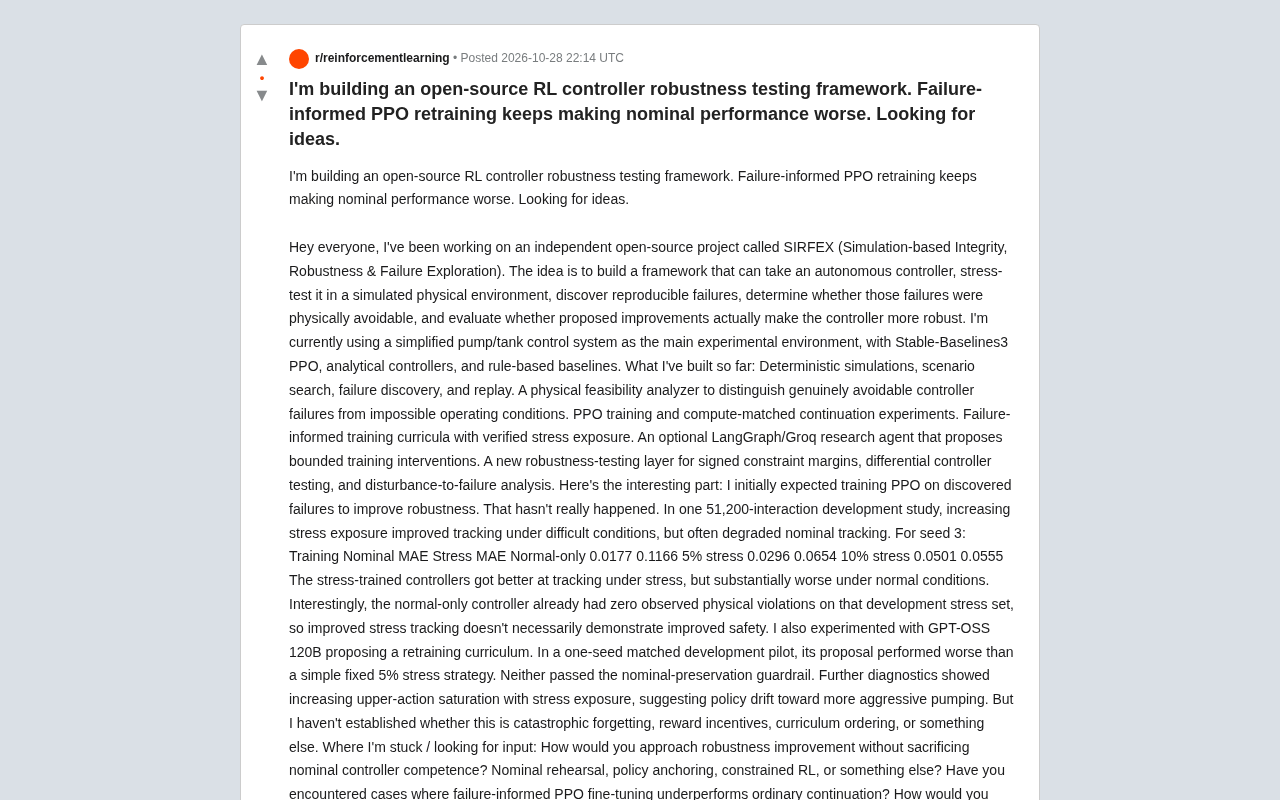
开源鲁棒性测试框架SIRFEX:失败驱动的PPO重训为何拖累正常性能?
开源框架SIRFEX用失败场景微调PPO,却导致标称性能下降。本文解析其实验数据、负结果原因,并探讨鲁棒性提升与标称性能保持的平衡之道。
阅读全文 →

·5 分钟
PPO算法破解移动沙发难题,重建Gerver最优解
开发者利用PPO强化学习算法成功重建移动沙发问题的Gerver最优解,展示了AI在几何优化难题中的潜力。文章详细介绍了问题背景、方法、结果及局限性。
阅读全文 →

·6 分钟
用PPO智能体让AI跑《神庙逃亡》:手机端实测最远16782米
开发者用PPO强化学习智能体玩《神庙逃亡》,通过Frida直接读取游戏内存并调用游戏方法操作,自建C++无头模拟器6分钟训练1000万步,真机14次实测中位数4736米、最远16782米,GitHub已开源。
阅读全文 →