用PPO智能体让AI跑《神庙逃亡》:手机端实测最远16782米

开发者用PPO+Frida白盒接口+校准模拟器,让AI在《神庙逃亡》中跑出最远16782米。
一位开发者开源了用强化学习通关《神庙逃亡》的完整项目。其核心特点是不使用像素输入和触控模拟,而是通过Frida动态插桩直接读取游戏内存状态、调用游戏原生方法执行动作,从而消除视觉噪声和输入延迟。作者用Claude辅助构建了基于游戏内部机制的无头模拟器,并用真机数据标定参数,C++版本约6分钟即可完成1000万步训练。算法采用标准PPO,没有算法创新,效果主要来自接口设计优化和Sim-to-Real对齐。真机14次测试中位数4736米,最远16782米,中位数与最好成绩的明显差距反映策略稳定性仍有波动。项目已在GitHub开源并公开挑战目标。
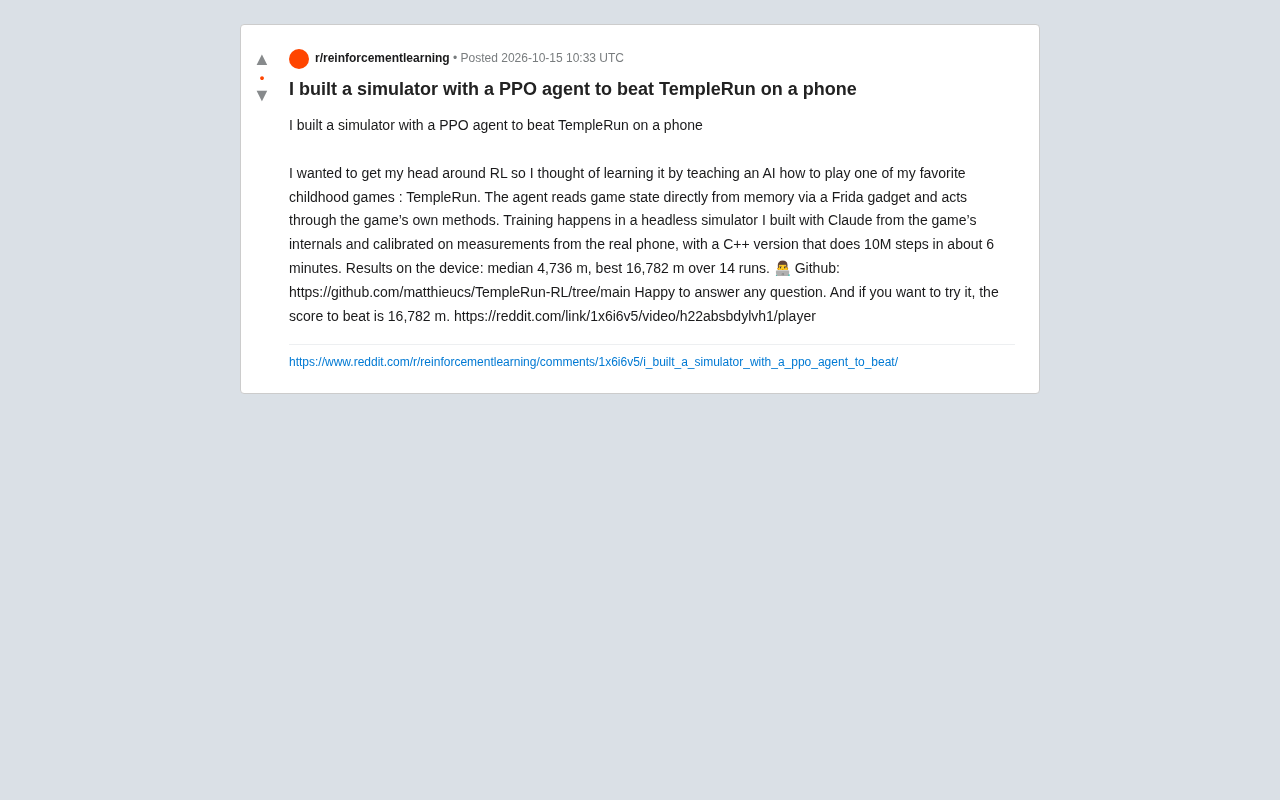
一位开发者在Reddit上分享了他用强化学习让AI通关《神庙逃亡》的完整项目。这个项目的特别之处在于:AI不是在游戏画面像素上做视觉学习,而是直接读取游戏内存状态、直接调用游戏自身方法操作角色。它背后是一个用C++实现、能在模拟器里以6分钟完成1000万步训练的高速环境。
为什么选《神庙逃亡》来做强化学习入门?
作者提到,他做这个项目是为了真正吃透强化学习(RL)。相比CartPole或者Atari这类被刷烂的基准环境,用自己童年玩过的游戏做练习对象,动力更足,也更容易坚持到跑通全流程。
更大的挑战在于平台差异。手机游戏的运行环境、输入方式和状态读取都比传统桌面RL环境复杂,这让整个项目从“跑通算法”变成了一次完整的系统集成练习:需要解决内存读取、动作注入、模拟器还原、真机标定等一系列工程问题。
作者选择PPO(Proximal Policy Optimization)作为训练算法。PPO是近年来强化学习中应用最广的策略梯度方法之一,以训练稳定、调参相对友好著称,适合这种需要从零搭建训练管线的项目。
PPO(Proximal Policy Optimization,近端策略优化)由OpenAI在2017年提出,属于Actor-Critic架构下的策略梯度方法。它的核心思想是在每次更新时限制新旧策略之间的差异,通过一个裁剪(clip)后的替代目标函数来避免策略更新幅度过大导致训练崩溃。相比TRPO,PPO实现更简单、计算开销更低;相比普通策略梯度,它样本复用率更高、训练更稳定。这些特性使PPO成为OpenAI Five、ChatGPT的RLHF阶段等大型项目中的默认选择,也是目前入门强化学习最常见的算法之一。理解PPO的裁剪机制和优势函数估计,是读懂这类项目训练管线的必要前提。
CartPole是OpenAI Gym中最经典的强化学习入门环境:一根倒立摆通过左右施力保持平衡,状态只有4维、动作只有2个,通常几百行代码、几十秒就能训练出稳定策略。Atari基准则包含几十款像素级游戏,状态是高维图像、需要卷积网络处理,是评估深度RL算法泛化能力的标准测试集。这两类环境之所以被大量使用,是因为它们接口统一、可重复性高、结果可比。而本项目的《神庙逃亡》既无标准接口,又涉及手机平台,属于典型的“非标环境”,工程难度远高于上述基准。
直接读内存、直接调方法:绕过像素的Agent设计
这个项目最值得关注的技术决策是Agent的接口设计。
状态输入不靠像素。 智能体通过Frida gadget直接从游戏内存里读取游戏状态。这意味着它拿到的是结构化的内部数据,而不是需要卷积网络去理解的原始画面。这种做法的好处是样本效率高、训练收敛快,缺点是Agent与这款游戏的具体内存布局强绑定。
动作输出不靠模拟触屏。 智能体通过游戏自身的方法来执行动作,而不是模拟屏幕点击或滑动手势。这消除了输入延迟和触控坐标误差带来的噪声,让训练信号更干净。
Frida在其中扮演关键角色。 Frida是一个动态插桩工具,常用于逆向和运行时分析。作者用它作为内存读取和动作注入的桥梁,等于把游戏变成了一个可以程序化查询和控制的“准API环境”。
这种“白盒”思路在游戏RL项目中并不罕见,但把它完整落地到手机端并且跑出成绩,工程量并不小。
Frida是一个开源的动态代码插桩(Dynamic Binary Instrumentation)框架,最初专为移动端逆向设计,支持Android、iOS、Windows、macOS等多个平台。它通过把一段JavaScript运行时注入到目标进程中,让开发者可以用JS脚本在运行时Hook任意函数、读写内存、调用对象方法,而无需重新编译或修改目标程序。在游戏逆向与辅助开发领域,Frida常被用来定位关键函数、导出内存结构、绕过反调试等。本项目中,作者正是利用Frida gadget(一个可被加载进目标进程的嵌入式库)作为桥梁,将游戏进程内部的状态与操作暴露成可编程接口,从而把一款普通手游转化为可供RL智能体直接交互的环境。
无头模拟器与C++加速:6分钟跑完1000万步
训练效率是这个项目的另一个亮点。
作者用Claude辅助,根据游戏内部机制构建了一个无头(headless)模拟器,并用真实手机上测得的参数对它进行标定。这一点很关键:如果模拟器和真机行为偏差太大,策略迁移到手机上就会失效。
模拟器配有C++版本,能在约6分钟内完成1000万步训练。这个吞吐量意味着可以快速迭代实验,而不用等待漫长的真机试错。对于个人开发者来说,能否快速做实验往往直接决定了项目能不能推进下去。
从工程角度看,这个项目的结构可以拆成四层:游戏内存接口层、标定过的模拟器、PPO训练管线、以及真机部署验证。每一层都有独立的失败模式,任何一层出问题都会让最终成绩归零。
“无头(headless)”指的是程序在没有图形界面的情况下运行,只保留核心逻辑计算,跳过所有渲染、音效、UI绘制等与决策无关的开销。对强化学习训练而言,图形渲染往往是最大的性能瓶颈之一——一帧画面渲染的耗时可能比物理模拟和状态更新高出几个数量级。无头模拟器把这些环节全部剥离,只保留游戏物理、生成、碰撞、得分等与策略学习相关的机制,从而把单步耗时压缩到微秒级。这也解释了为什么本项目能在6分钟内完成1000万步训练:折算下来约每秒2.8万步,这个吞吐量在带图形界面的真实游戏环境中几乎不可能达到。Sim-to-Real(仿真到现实迁移)领域普遍采用这种思路,先在无头环境中高速训练,再回到真实环境验证。
真机实测:中位数4736米,最远16782米
训练结果最终在真实手机上验证。作者给出了14次运行的数据:
- 中位数成绩:4,736米
- 最好成绩:16,782米
中位数和最远记录之间的差距相当明显,说明策略在不同对局中的表现波动较大。这在游戏RL中很常见——随机生成的地形、道具分布和速度提升曲线都会影响单局表现,而中位数比最好成绩更能反映策略的稳定性。
作者把16,782米作为公开的挑战目标,并开放了GitHub仓库(matthieucs/TempleRun-RL),欢迎其他人尝试打破这个成绩。
这个项目对做游戏AI的人有什么参考价值
第一,接口设计比算法选择更影响最终效果。这个项目用的是标准PPO,没有特别的算法创新,但通过内存读取和原生方法调用消除了大量环境噪声。对于资源有限的项目,优化接口往往比换算法回报更高。
第二,模拟器标定是Sim-to-Real的关键环节。作者明确提到模拟器是用真机测量数据校准的,这不是可省略的步骤。很多个人项目在模拟器里表现很好、上真机就崩,原因通常就在这里。
第三,高速模拟器让实验节奏变得可行。6分钟1000万步意味着一天内可以做几十轮实验,这种迭代速度是项目能调出好策略的前提。
第四,用“玩得下去的游戏”做学习项目是有效的自我驱动方式。这个项目从动机到落地都围绕作者本人的兴趣展开,最终产出了一个有明确量化结果、可被他人复现和挑战的作品。
如果你手头也有一个玩了很多年的手游,并且想找个具体目标来练强化学习,这个项目的思路提供了一个相当完整的参考模板:白盒接口 + 校准模拟器 + 快速训练 + 真机验证。
Sim-to-Real(仿真到现实迁移)是机器人学与游戏AI共同面临的核心难题:在模拟器中训练出的策略,迁移到真实环境后往往性能急剧下降,原因是模拟器无法完全复现真实世界的噪声、延迟、参数误差和动态变化。常见的缓解手段包括域随机化(Domain Randomization,在训练时随机变化模拟器参数以增强策略鲁棒性)和系统辨识(System Identification,用真实数据反向拟合模拟器参数)。本项目选择的是后者——作者明确用真机测量数据对模拟器进行标定,让模拟器的状态转移、速度曲线与真机尽量一致。虽然方法不算新颖,但对个人项目来说,这一步的严谨程度往往直接决定了策略能否真正“落地”。
相关推荐

WorkBuddy保姆级教程:半小时跑通自动化工作流
WorkBuddy 自动化工作流保姆级拆解:为什么大多数人只把它用成聊天软件,27 个支点课程与 12 个模板如何帮助新手半小时跑通落地实操,附使用边界提醒。

Codex云端模式详解:环境配置与适用场景
本文详细解析Codex云端模式的工作原理、环境配置步骤及适用场景,包括如何创建环境、连接GitHub仓库、设置定时任务,并对比云端与本地模式的差异,帮助开发者高效利用Codex。

Claude Code免费使用真相:三条路与一个骗局
Claude Code 免费使用是否可行?本文拆解 Pro、Max 的真实成本(含汇率与税费)、社区免费方案的技术原理与隐私代价,以及假安装包、钓鱼页面等安全陷阱,并给出访客通行证、开源贡献者计划和本地模型三条合法免费路径。