128G迷你主机跑大模型:贵的不一定快,先定模型再选机器

128G与64G迷你主机实测:贵机器并非全项通吃,优势绑定特定模型。
B站UP主AIPC郁森贵用两台迷你主机(128G与64G内存)做了一次严格控制变量的对比:同一批模型、同一脚本、九档材料长度(400字到20万字),只比首字延迟、读材料速度、每秒写字数和整段耗时四项。结果显示,在主力35B模型上贵机器每秒写字九档赢七档,多花的钱确实买到速度;但换到27B模型后快慢反转,首字延迟只赢一档输七档。MTP版本则换来开头快、出字慢。四个模型合看,贵机器没有一个模型全项通吃,便宜机器也没有一个全项输。文章据此提出选机三步法:先定常用模型,只看该模型对应指标,再算价差是否花在在意的那一项上。
迷你主机跑本地大模型,贵的机器不是全项通吃
B站UP主AIPC郁森贵做了一次不太一样的迷你主机对比:两台机器,一台内存128G,一台64G,条件卡得很死——同一批模型、同一批问题、同一个脚本、同一个顺序。材料长度做了九档,最短400字一条微博,最长20万字一本小说,每一档两台机器各跑一遍。比的只有四件事:第一个字要等多久、读完材料有多快、每秒能写几个字、整段答完要多久。同一段材料谁的数据好,这一档就归谁,九档里赢几档就是它这一项的成绩。
结论先摆出来:贵的那台不是每一项都赢。而且更关键的是,同一台机器换个模型,快慢就反过来。这意味着「哪台更强」这个问法本身就错了,该问的是「我这台机器跑我正在用的这个模型快不快」。
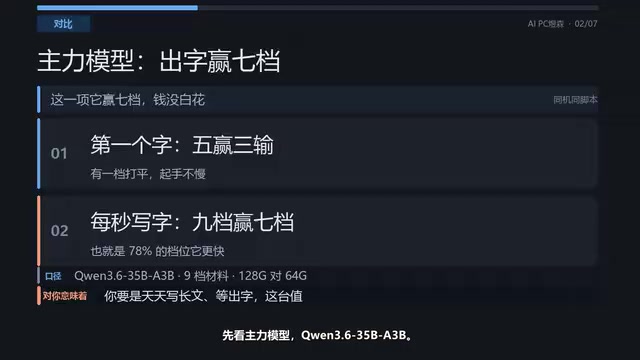
主力模型35B:多花的钱确实买到了速度
先看主力模型,签问3.6 35B A3B——35B就是350亿个参数,B是10亿参数的意思。参数相当于模型里调好的旋钮,越多越吃内存。同一个模型,两台机器各跑九档。
第一个字要等多久:五档赢、一档平、三档输,起手不算慢。读完材料有多快:六档赢、三档输。整段答完:五档赢、四档输。最狠的是每秒写几个字,九档里赢七档、平一档、只输一档,也就是78%的档位它更快。所以在这个主力模型上,多花的钱是买到东西了的。
这里的判断很直接:如果你天天跑主力模型,还在意它写得快,贵的那台值。
A3B 与 MoE 架构:文中的「35B A3B」是一种混合专家(MoE, Mixture of Experts)模型的命名方式。前半的 35B 指模型总参数量约 350 亿,后半的 A3B 通常表示每个 token 推理时只激活约 30 亿参数(Activated 3B)。MoE 把前馈层拆成多个「专家」,由门控网络按 token 动态选择少数专家参与计算。这样总参数撑大了模型容量,但单次前向的计算量远小于同等总参数量的稠密模型,因此显存占用高、算力开销却相对低。这正好解释了为什么两台机器内存差异(128G 与 64G)会成为关键变量:模型要完整装进显存/内存才能跑,装得下与否、以及剩余空间如何分配,会直接影响推理速度。
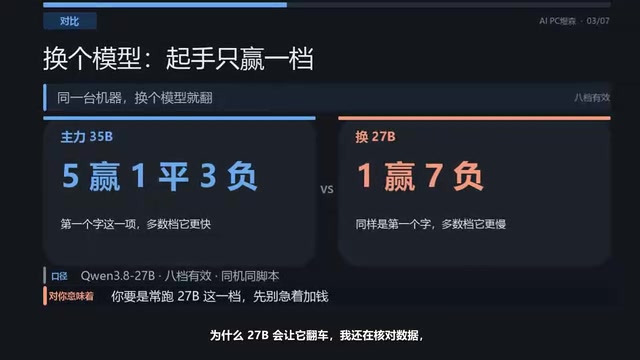
换到27B:同一台机器,快慢翻过来了
再看27B,271参数,比主力小一号。机器没换、脚本没换,结果却翻过来了。第一个字要等多久,只赢一档、输七档——刚才那个出字快的贵机器,换成27B起手就慢了。读完材料一样,赢一档、输七档。每秒写几个字,四赢四输,一半一半。整段答完,也是四赢四输。
为什么27B会让贵机器翻车?UP主在视频里说自己还在核对数据,准备单独出一期讲清楚。这一点很关键:具体原因尚未定论,但现象本身已经足够说明问题——机器的优势是绑定在特定模型上的,换一个模型,胜负关系就重排。
MTP版本:开头快,代价是写得慢
第三个测试更奇怪。把主力模型换成带MTP后缀的版本,MTP可以理解成模型自带一个「先猜后答」的小助手:先猜几个字,再一起核对。这一版第一个字要等多久,七档赢、两档输;读完材料七档赢、两档输,都很漂亮。但每秒写几个字,三档赢、六档输,也就是67%的档位反而更慢。整段答完六档赢、三档输。
所以MTP版本换来的是开头快,代价是出字慢。你是赶时间要第一句,还是要它一直写得快,答案不一样。另外视频里还提到,27B这一行里有8档的统计,有一档还在核对,先不放出来。
MTP(Multi-Token Prediction,多 token 预测):传统自回归模型每次只预测下一个 token,MTP 则让模型一次预测未来多个 token,再由后续步骤校验或接受。文中所说的「先猜后答的小助手」正是这种思路的通俗说法。它的收益集中在首字延迟和读材料阶段——因为可以并行地「预判」后续内容,起步更快;但一旦进入稳定生成,猜错要回退重算,有效吞吐反而可能下降。这与实测中「首字七档赢、每秒写字三赢六输」的现象吻合。注意 MTP 与「投机解码」(speculative decoding)常被混用,后者是用一个小的草稿模型来猜、大模型来验,而 MTP 是在同一模型内部加入多 token 预测头,二者机制不同但目标相似。
四模型合看:没有全项通吃,只有对某个模型强
四个模型放在一起看,有件事很清楚:贵的那台没有一个模型是全部指标都赢的,便宜的那台也没有一个模型是全部指标都输的。UP主一开始猜是显存分法不一样——显存就是内存里划给显卡的那一块——但这个还没测实,不敢当结论讲。能确定的是,机器没有全项通吃,只有对某个模型强。
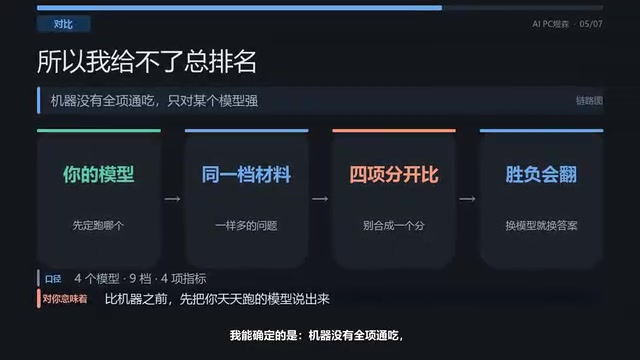
第四个JMA小模型只测了7档:开头三赢一平三负,写字六赢一输。四行合起来就是一句话——先定模型,再选机器。
显存分法与统一内存:迷你主机通常没有独立显卡,而是依靠集成 GPU 与 CPU 共享同一块物理内存(统一内存架构)。所谓「显存分法」,指 BIOS 或驱动把多少内存划给 GPU 作为显存使用,剩余部分留给系统。这个比例会显著影响大模型推理:划得太少,模型权重放不下或被迫分层加载,速度骤降;划得太多,系统内存紧张,也可能拖慢整体。不同模型对显存的需求曲线不同(参数量、量化精度、KV Cache 大小都不一样),因此同一套分法在 35B 上可能刚好,在 27B 上就未必最优——这正是「机器优势绑定特定模型」的一个可能解释,但原文也强调该猜测尚未测实。
怎么选:三步走,先定模型再看机器
UP主给了一个很实用的三步法。第一步,先定你天天跑哪个模型:是35B的主力模型,还是27B,还是更小的。第二步,只看你这个模型对应的那一项:写长文、要它一直写快,看每秒写几个字;聊天、等第一句,看第一个字等多久。第三步,再算两台机器的价差,看这笔钱花在你那一项上没有。
他的判断很直接:天天跑主力模型、还在意写得快,贵的那台值;天天跑27B这一档,多花的钱买不到快。这不是贵的好不好,是贵的那台配不配你这个模型。
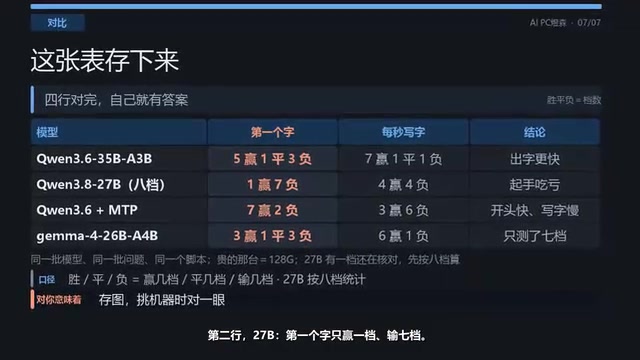
顺手把这张胜负表存下来,挑机器前照着对。最后提醒一句,以上数据是UP主在自己两台机器上跑出来的,属于单一来源的实测,样本是两台机器、四个模型、九档材料,结论值得参考,但不必当成放之四海皆准的定律。
相关推荐

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。

Qwen 3.8 27B 真能读懂神经网络权重?16GB 实测揭秘
MIT 研究声称大模型能直接读取神经网络权重并识别训练游戏。我们在 16GB 显卡上实测 Qwen 3.8 27B,发现信号真实存在,但“原生读取”说法不成立,25 行 Python 脚本即可秒级还原答案。