16GB显存是多数人的天花板:本地大模型的现实与未来
本地大模型的显存门槛被高端社区严重高估,16GB才是多数用户的现实上限,量化技术正在改变局面但架构瓶颈依然存在。
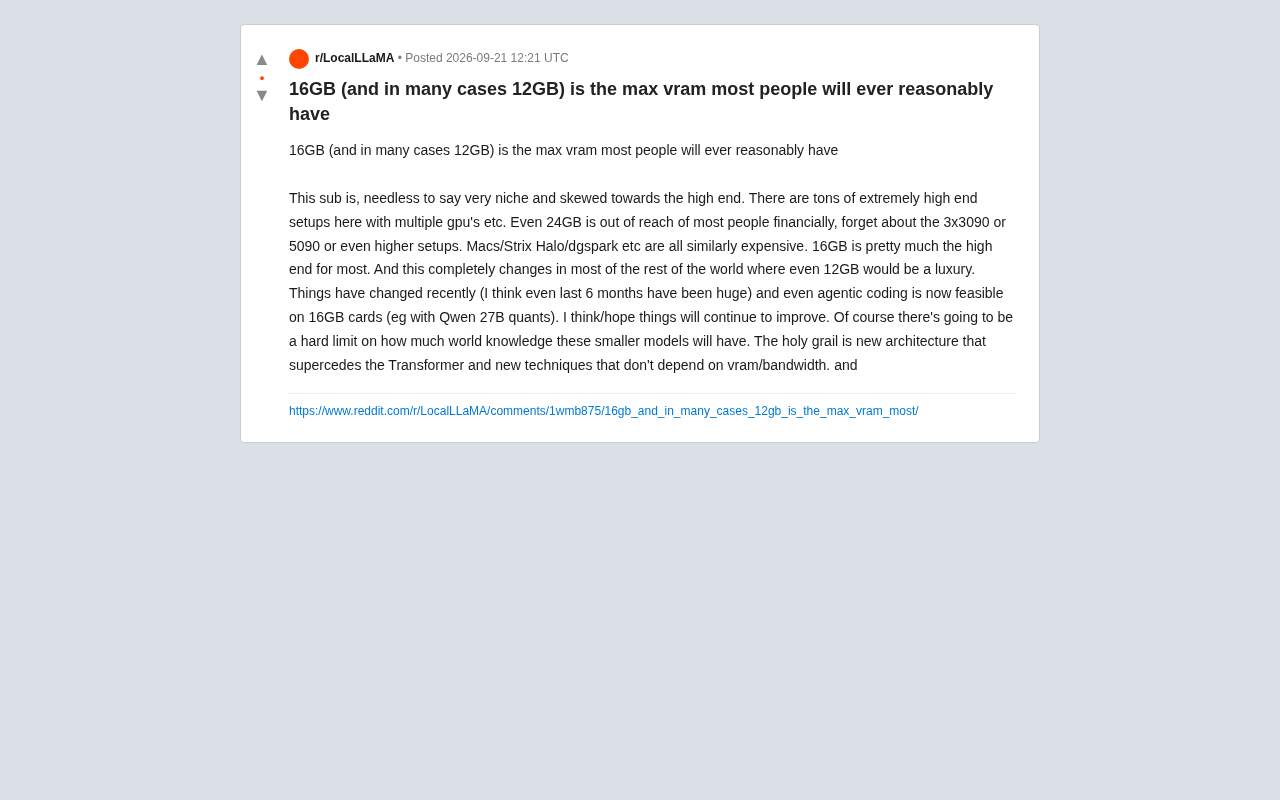
一位Reddit用户提出了一个被高端讨论社区长期忽视的现实:对绝大多数人而言,16GB乃至12GB才是本地运行大模型的显存实际上限,而非社区中常见的24GB起步认知。文章指出,这一偏差源于本地AI社区本身的高度小众性,且地域差异被普遍忽略——在世界大部分地区,12GB显存已是奢侈配置。好消息是,量化技术(如4-bit压缩)与中等规模模型的架构优化正在协力降低门槛:Qwen 27B的量化版本已能在16GB显卡上完成agentic编程任务,标志着实用性的实质性跃升。然而,小模型在"世界知识"容量上的硬性上限无法通过量化绕过,而Transformer架构对显存和带宽的根本性依赖,仍是普及本地AI的结构性障碍。真正的突破,可能需要等待超越Transformer的新架构范式。
被高端配置掩盖的真实用户画像
在本地大模型(LLM)的讨论社区里,多GPU堆叠、3x3090、5090乃至更高端配置的帖子层出不穷,很容易让人产生一种错觉:跑本地模型的门槛就该是24GB显存起步。但一位Reddit用户抛出了一个更接近现实的观点——对绝大多数人来说,16GB(很多情况下甚至是12GB)才是显存的实际上限。
这个判断值得认真对待。社区本身高度小众且严重偏向高端,聚集了大量愿意为硬件投入巨资的爱好者。可一旦把视野拉回到普通消费者,情况就完全不同了。24GB显卡对多数人而言在经济上就已经遥不可及,更别提多卡方案,或是Mac、Strix Halo、DGX Spark这类同样昂贵的替代平台。
12GB在世界大部分地区仍是奢侈品
原帖特别强调了一个常被忽视的维度:地域差异。在发达市场,16GB或许还算够得着的"高端",但在世界的其他大部分地区,连12GB显存都属于奢侈配置。
这提醒我们,围绕本地AI的技术讨论往往建立在一个隐性假设之上——用户拥有相对充裕的硬件预算。而真实的全球用户分布远比社区呈现的样子更下沉、更受限。任何希望本地大模型"普惠"的愿景,都必须正视这条被显存和价格划定的现实边界。
小显存的转机:Agentic编程已成为可能
好消息是,局面正在快速变化。原作者指出,仅最近半年就出现了巨大进展——即便是16GB显卡,现在也已经能够跑通agentic coding(智能体编程)任务,例如借助Qwen 27B的量化版本。
这是一个关键信号。过去人们普遍认为,复杂的代理式工作流需要庞大的模型和充裕的显存支撑,而量化技术与更高效的中等规模模型正在打破这一认知。当27B级别的模型经过量化后能塞进16GB显存,并胜任编码智能体的工作,意味着本地AI的实用门槛正在实质性下移。
量化与模型效率的双重推进
这一进展背后是两条技术路线的合力:一是模型量化(如4-bit、更激进的低比特方案)持续压缩显存占用而尽量保留能力;二是中等规模模型在训练数据和架构上的优化,使其在参数量不变的情况下表现更强。二者叠加,让"小卡跑大活"从空想逐渐变为日常。
Agentic coding(智能体编程)是指让大模型扮演"自主代理"角色,能够分解任务、调用工具(如代码执行器、文件系统、搜索接口)、根据中间结果迭代修正,最终完成多步骤的复杂编程目标。与单次问答式补全不同,agentic工作流要求模型维持较长的上下文、进行多轮推理并处理工具返回的结构化信息。这类任务对模型能力的要求远高于简单代码补全,因此过去被认为是大参数模型的专属领域。能够在16GB显存内完成此类任务,标志着量化后的中等规模模型在实用性上跨越了一个重要门槛。
模型量化是指将神经网络权重从训练时使用的高精度浮点数(通常为FP16或BF16,每个参数占2字节)压缩为更低比特的表示形式。常见的4-bit量化可将每个参数的存储压缩至约0.5字节,理论上让同等显存能装入约4倍参数量的模型。例如,一个27B参数模型在FP16下需要约54GB显存,经4-bit量化后约需14-16GB,恰好能在单张16GB显卡上运行。量化的代价是模型输出质量的轻微下降,但GGUF、GPTQ、AWQ等现代量化方案已将这一损耗控制在可接受范围,尤其对编码、推理等结构化任务影响较小。
无法回避的硬约束:世界知识的容量上限
乐观之余,原作者也保持了清醒。他明确指出,小模型在"世界知识"(world knowledge)的容纳量上必然存在硬性上限。参数规模决定了模型能记住多少事实性信息,这不是靠量化就能绕过的物理限制。
换句话说,量化和效率优化可以让小模型在推理、编码这类结构化任务上表现出色,但在需要广博知识储备的场景中,它们与大模型之间仍会存在难以填平的鸿沟。这也是为什么单纯依赖压缩现有架构,无法从根本上解决问题。
真正的圣杯:超越Transformer的新架构
原帖最后指向了一个更宏大的方向:真正的"圣杯"是能够超越Transformer的新架构,以及不再高度依赖显存与带宽的新技术。
这一观点触及了当前本地AI困境的核心。Transformer架构对显存和内存带宽的胃口,正是普通用户被硬件卡住脖子的根本原因。如果未来出现在计算与存储需求上更友好的新范式,那么"16GB天花板"的讨论本身或许就会失去意义——让高质量AI真正跑在普通人的设备上,靠的可能不是无止境地堆显存,而是架构层面的范式转移。
Transformer架构对硬件的高需求根源于其核心机制——自注意力(Self-Attention)的计算复杂度随序列长度平方增长,且推理时需要将全部权重和KV缓存常驻显存。这使得显存容量和内存带宽成为制约本地部署的双重瓶颈。目前已有若干替代架构尝试打破这一限制:Mamba等状态空间模型(SSM)以线性复杂度处理序列;RetNet、RWKV等将Transformer改造为循环形式以降低推理时的显存驻留需求。这些架构尚未在通用能力上全面超越Transformer,但其在边缘设备和低显存场景下的潜力,正是原帖所指"圣杯"的具体所指方向。
结语:把讨论拉回大多数人
这篇帖子的价值,不在于提供了多少新数据,而在于它校准了整个社区的视角。当高端玩家沉浸于多卡集群时,真正决定本地AI能否普及的,是那些手握16GB甚至12GB显卡的大多数用户。
量化技术让小显存设备迎来了实质性的能力跃升,agentic编程的可行性就是明证;但世界知识的容量瓶颈,以及对Transformer架构的路径依赖,仍是横亘在前的结构性难题。本地AI的未来,既取决于工程上的持续优化,也取决于是否能等来那场更底层的架构革命。
相关推荐
老式洗衣机变速箱维修:DIY修理经济学
一篇关于Whirlpool惠而浦洗衣机变速箱维修的技术记录在Hacker News被分享,本文探讨DIY家电维修的经济性、维修权文化及其在技术社区的意义。
VNCCS PoseStudio:Qwen Image 2.1 姿势控制LoRA发布
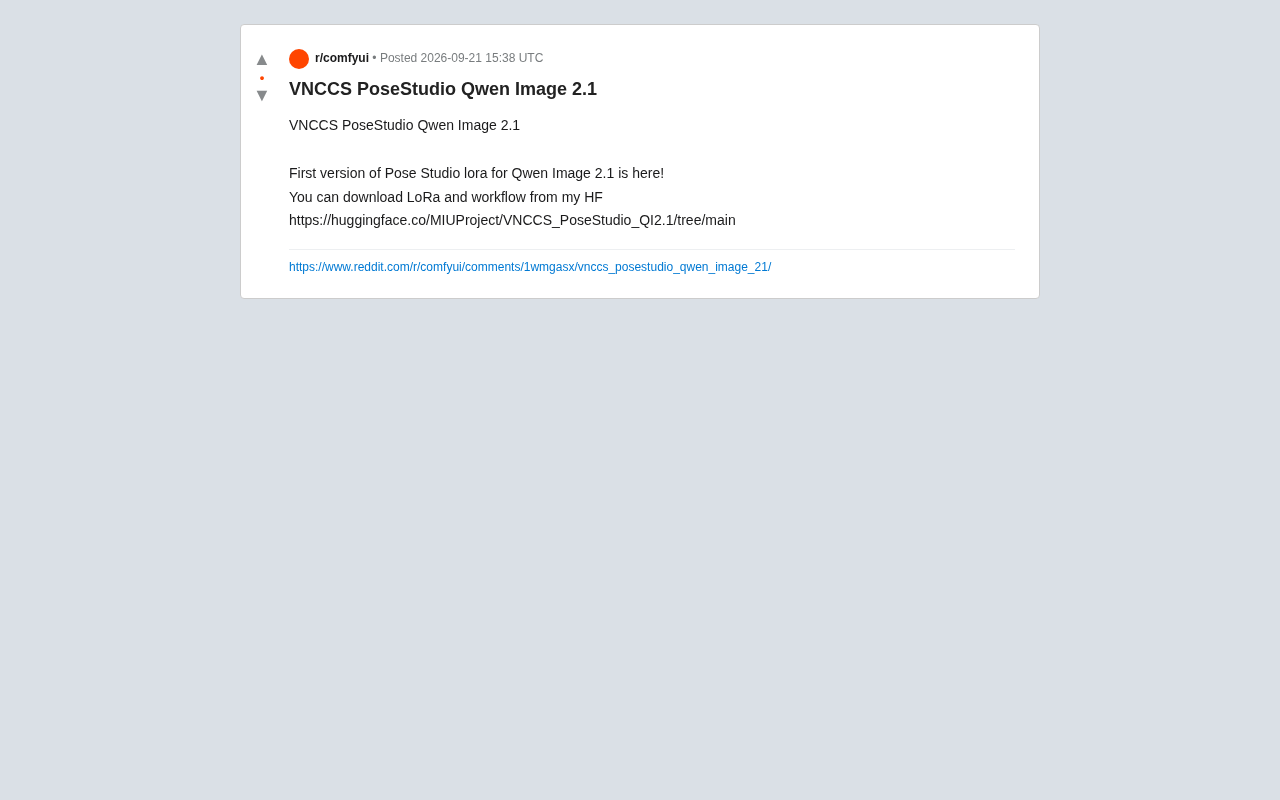
VNCCS PoseStudio 为 Qwen Image 2.1 推出首个姿势控制 LoRA,附带完整工作流,已在 Hugging Face 开源发布。本文解析其功能、获取方式与对AI图像创作的实际价值。
TechCrunch Disrupt 2026:Startup Battlefield 200的VC评委阵容前瞻
TechCrunch Disrupt 2026 的 Startup Battlefield 200 将迎来新一批VC评委。了解竞赛机制、早鸟报名优惠(9月25日截止,最高省200美元)及其对创业者的价值。