17万星Ponytail:让AI编程助手学会偷懒,代码减半

Ponytail用七级梯子让AI先问“能不能不写”,代码减半而测试覆盖反升。
Ponytail是一个在GitHub获超17.6万星的开源项目,旨在纠正AI编程助手“大包大揽”的倾向。它通过“七级梯子”决策流程,要求AI在写代码前逐级询问:功能是否需要存在、仓库有无现成实现、标准库或平台能力能否覆盖、现有依赖能否复用、一行代码能否搞定,只有全部不成立才编写最小可行代码。其“偷懒”仅针对方案选择,输入校验、错误处理、安全性和无障碍支持等质量要求不被砍掉。官方基准显示代码量减少53%、耗时减少41%、成本降低26%,高风险逻辑带测试比例从68%升至98%。项目还提供review和audit两个命令,在Claude Code中两条命令即可安装。
一个让AI少写代码的开源项目
AI编程助手往往倾向于“大包大揽”——你让它加个日期选择器,它可能直接装一个第三方库,或者手写一整个日历组件,代码量轻松突破几百行。B站上开箱的Ponytail项目,试图扭转这种倾向:它让AI像组里最会偷懒的资深开发者一样思考,追求用最少的代码解决问题。这个项目在GitHub上已经收获超过17.6万颗星,被17万人收藏,成为开发者社区里讨论度极高的“偷懒神器”。
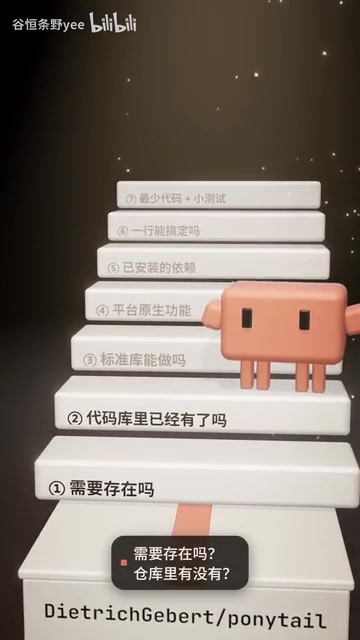
Ponytail的核心思路并不复杂:在写任何代码之前,先问几个问题,能少写就少写。它把这种“偷懒”变成了一套可执行的决策流程,而不是简单地让AI敷衍了事。
七级梯子:从“需要存在吗”到“最小可行代码”
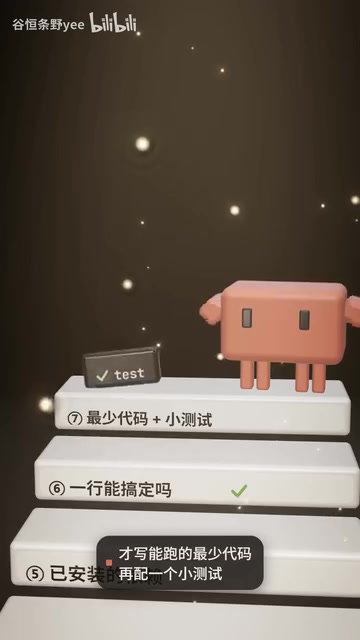
Ponytail的秘诀是一把“七级梯子”。在动手写代码之前,AI需要从第一级开始逐级往上问:这个功能需要存在吗?仓库里有没有现成的实现?标准库能不能做?平台自身的能力能不能覆盖?现有依赖能不能复用?一行代码能不能搞定?只有当所有更低层级的方案都不成立时,才走到最后一级——编写能跑的最小代码。
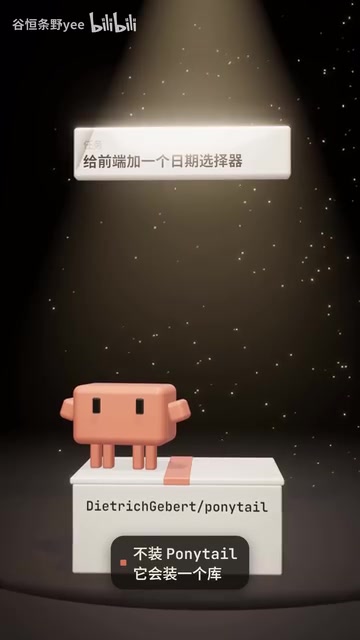
以添加日期选择器为例:不装Ponytail时,AI可能会安装一个库,或者干脆手写一整个日历,代码量达到335行。装上Ponytail之后,它会先检查仓库里有没有现成的输入框,然后直接利用浏览器自带的日期选择能力,几行代码就搞定了。这种“先找现成方案”的路径,避免了重复造轮子,也大幅压缩了代码体积。
浏览器原生日期选择能力指的是 <input type="date"> 这一 HTML 标准元素及其配套的 showPicker() 方法。现代浏览器(Chrome、Edge、Safari、Firefox)均内置了日期选择器 UI,用户点击输入框即可弹出月历浮层,无需引入任何 JavaScript 库或手写日历组件。该元素返回的值为 YYYY-MM-DD 格式字符串,可通过 min、max、step 属性约束可选范围,并原生支持键盘操作与无障碍语义。Ponytail 正是利用这一平台能力,将原本需要数百行代码的日历组件压缩为几行声明式 HTML,同时自动获得跨浏览器兼容性和可访问性保障。
**“最小可行代码”**借鉴了“最小可行产品”(MVP)的思想:在满足功能需求的前提下,只编写绝对必要的代码,避免任何推测性的抽象、配置项或扩展点。它要求开发者(或 AI)先交付一个能运行、能验证假设的最小实现,再根据真实反馈决定是否扩展。Ponytail 的七级梯子将这一原则工程化:每一级都尝试用更少的代码满足需求,只有当前一级确实无法覆盖时,才允许进入下一级。这有效抑制了 AI 常见的“过度工程”倾向,例如为单一场景提前设计插件架构或通用配置系统。
偷懒有边界:安全、错误处理一样不砍
值得强调的是,Ponytail的“偷懒”只针对方案选择,而不是降低代码质量。它明确要求:输入校验、错误处理、安全性和无障碍支持一样都不能砍掉。换句话说,它砍掉的是冗余的实现方式,而不是必要的健壮性保障。
这种设计哲学解决了一个常见痛点:AI生成的代码往往为了“看起来完整”而堆砌大量不必要的逻辑,反而增加了维护成本和出错概率。Ponytail通过约束AI的决策路径,让输出更接近资深开发者的习惯——用最简单的方式满足需求,同时守住质量底线。
实测数据:代码小一半,测试覆盖反而更高
Ponytail官方基准测试给出了直观的对比:代码量减少了53%,耗时减少了41%,成本降低了26%。更反直觉的是,高风险逻辑带测试的比例从68%上升到了98%。
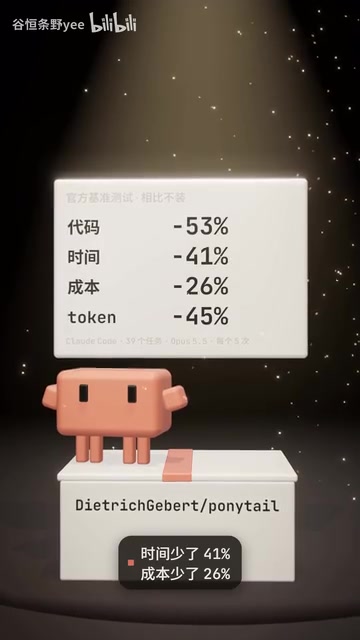
这个结果说明,“偷懒”并没有牺牲可靠性。代码量减少意味着需要测试的逻辑更集中,AI反而更容易为关键路径补充测试。对于团队协作来说,更小的代码 diff 也意味着更低的审查负担和更高的合并效率。
高风险逻辑通常指涉及资金交易、权限校验、数据持久化、外部输入处理或安全边界的关键代码路径。这类逻辑一旦出错,后果严重且难以通过人工审查完全排除,因此业界普遍要求其具备较高的测试覆盖率。Ponytail 基准测试中该比例从 68% 升至 98%,说明代码量缩减后,AI 的注意力更集中,反而更愿意为关键分支补充测试用例。这也从侧面印证了一个工程经验:代码越少、职责越单一,测试越容易做到充分覆盖。
两个命令:review 与 audit
除了生成代码时的梯子策略,Ponytail还提供两个实用命令:review 用于审查本次改动,audit 用于扫描整个仓库并排出优先修复顺序。在 Claude Code 环境中,两条命令即可完成安装。这种轻量集成方式降低了上手门槛,也让Ponytail能够融入现有的AI编程工作流,而不是要求开发者切换工具链。
从更宏观的视角看,Ponytail代表了一种对AI编程助手的新期待:不是生成更多代码,而是生成更少但更准确的代码。当AI能够像资深开发者一样判断“什么不该写”,代码质量和开发效率才能真正同时提升。
Claude Code 是 Anthropic 推出的命令行 AI 编程工具,允许开发者在终端内直接与 Claude 模型交互,执行代码生成、文件编辑、命令运行等任务,并支持通过自定义命令扩展其能力。Ponytail 以“两条命令即可安装”的方式集成,意味着它并未要求开发者更换 IDE 或工作流,而是作为 Claude Code 的技能包或命令扩展存在,降低了采纳成本。这种轻量集成模式也反映了 AI 编程工具生态的一种趋势:能力以可组合的插件形式嵌入现有工作流,而非另起炉灶。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。