20分钟基于vLLM本地部署DeepSeek-R1实战教程

在Ubuntu云服务器上从零部署DeepSeek-R1蒸馏版的完整vLLM流程与版本对齐要点。
文章基于B站UP主Mike的实践,梳理了在企业级场景下用vLLM替代Ollama部署DeepSeek-R1蒸馏模型的完整链路。首先对比二者差异,指出vLLM在KV缓存管理、吞吐量、HuggingFace生态衔接和多GPU分布式推理上的优势。随后给出经过验证的环境组合:Ubuntu 24、A10显卡、Python 3.10、CUDA 12.4、vLLM 0.7.x。流程依次覆盖Miniconda安装与清华镜像配置、禁用Nouveau并安装NVIDIA驱动、CUDA Toolkit安装、PyTorch与vLLM安装验证,最后通过hf-mirror下载1.5B蒸馏模型并用Python脚本完成推理测试。文章反复强调版本精确对齐与环境激活状态检查是避免踩坑的关键。
企业级大模型部署和本地跑个Demo完全是两回事。Ollama 适合个人快速体验,但一旦要在生产环境里支撑并发请求、做多卡并行,vLLM 几乎是绕不开的选项。B站UP主Mike分享了一套从零开始、在Ubuntu云服务器上部署 DeepSeek-R1 蒸馏版的完整流程,涵盖 Miniconda 环境搭建、NVIDIA 驱动安装、CUDA 工具包配置到 vLLM 推理验证的全链路。这套流程的价值在于:每一步都有明确的版本对应关系,照着走不容易踩坑。
为什么选 vLLM 而不是 Ollama
据B站UP主Mike的分析,vLLM 的核心优势体现在几个方面。其一是 KV 缓存的高效管理,能显著减少显存浪费,这对显存预算紧张的场景很关键。其二是吞吐量,通过批处理和连续批处理请求,推理速度和并发能力都有明显提升。其三是与 HuggingFace 生态的无缝衔接,模型加载不需要额外适配。其四,vLLM 支持多 GPU 分布式推理,通过模型并行策略提升大模型处理能力。最后,作为开源组件,vLLM 拥有活跃的社区和生态支持,遇到问题更容易找到解决方案。
对中小团队来说,这些特性意味着可以用更低的硬件成本承载更多请求,而不是堆显卡。
KV 缓存(Key-Value Cache) 是大模型自回归推理中的核心机制。生成每个 token 时,模型需要基于此前所有 token 的注意力计算结果,若每次重新计算将带来巨大的重复开销。KV 缓存把历史 token 的 Key 和 Value 张量保存在显存中,使解码阶段只需计算新 token 的注意力,从而大幅降低计算量。但缓存本身会占用大量显存,且传统实现因内存碎片化导致利用率低下。vLLM 提出的 PagedAttention 借鉴操作系统虚拟内存分页思想,将 KV 缓存划分为固定大小的块并按需分配,显著减少显存浪费,这正是其在显存紧张场景下的关键优势。
连续批处理(Continuous Batching) 是 vLLM 高吞吐的另一支柱。传统批处理需等整批请求全部完成后才能处理下一批,短请求会被长请求拖累。连续批处理在每次迭代时动态调度:已完成的序列立即移出批次,新到达的请求随即填入空位,使 GPU 始终处于高利用率状态。配合 PagedAttention,vLLM 能在相同硬件上承载数倍于朴素实现的并发请求,这也是中小团队用较低成本获得生产级吞吐的原因。
环境配置:版本对齐是第一道坎
UP主使用的测试环境如下:Ubuntu 24 版本操作系统、A10 显卡(16 核 CPU)、vLLM 0.7 版本、Python 3.10、NVIDIA 驱动 12.4、CUDA 12.4。这套配置的特点是“够用就好”——A10 不算高端卡,但跑 1.5B 参数规模的蒸馏模型绰绰有余。
有一点需要特别注意:vLLM 只支持 Linux 环境,且必须具备 GPU 资源。如果只有 CPU,则需要 CPU 支持特定指令集,否则无法运行。UP主建议希望本地部署的读者直接参考这套环境配置,避免因版本不一致导致的兼容性问题。
Miniconda 安装与镜像源配置
第一步是安装 Miniconda 来管理虚拟环境。UP主创建目录后,通过官方脚本下载安装包,执行安装后将安装文件删除。随后初始化 Bash 和 ZSH 配置文件,并用 source 命令让配置生效。
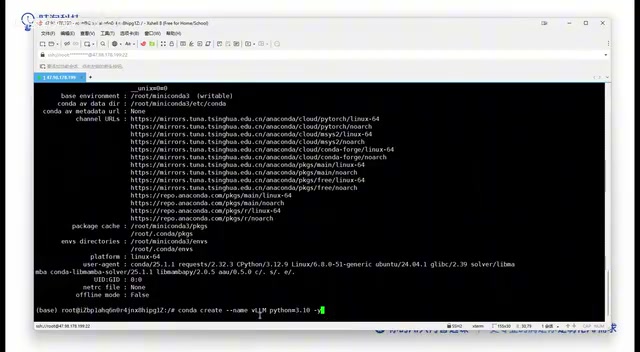
安装完成后需要修改镜像源。默认的国外源下载速度慢,UP主在 .condarc 文件中配置了清华源地址,然后用 conda info 确认镜像地址已变更。之后通过 conda create -n vllm python=3.10 创建独立环境,再用 conda activate vllm 激活。虚拟环境的意义在于隔离不同项目的 Python 版本和依赖,这对后续安装 CUDA 和 PyTorch 至关重要。
GPU 驱动与 CUDA 工具包安装
云服务器默认不预装 NVIDIA 驱动,这是很多新手容易忽略的一步。UP主先执行 apt update 和 apt upgrade 更新软件包仓库,再安装 build 等必要依赖项。为了避免与开源 Nouveau 驱动冲突,需要在系统配置中禁用 Nouveau 驱动(添加 blacklist 和 option 配置)。
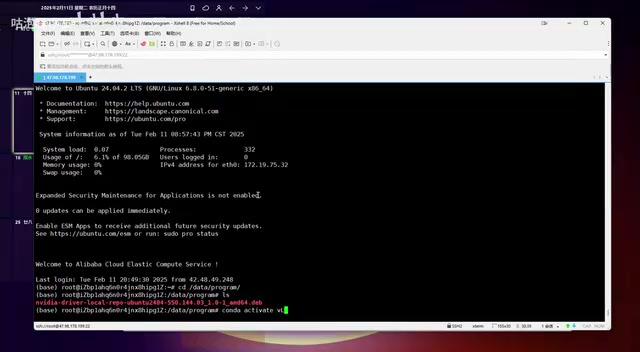
驱动下载要在 NVIDIA 官网按操作系统、显卡型号(Data Center Tesla / A10)、CUDA 版本(12.4)精确匹配。UP主建议用外部下载工具下载 DEB 文件后再上传到服务器,比直接在服务器上下载快得多。安装过程如果提示缺少 GPG Key,按提示复制执行对应命令再重试即可。安装完成后重启服务器,执行 nvidia-smi 能看到 GPU 状态信息就说明驱动就位。
CUDA Toolkit 的安装同理。UP主选择 CUDA 12.4.0 版本,在官网选 Linux + x86 + Ubuntu(没有 24 版本时选最高版本即可),下载 runfile 文件。这个文件约 4.14GB,建议用迅雷等工具下载后上传。执行时注意:驱动包已经装过了,安装过程中选择不重复安装驱动,只装 CUDA Toolkit 和文档即可。装完后在 .bashrc 中配置环境变量,执行 nvcc --version 确认版本。
Nouveau 是 Linux 内核自带的开源 NVIDIA 显卡驱动,虽能让系统识别显卡并输出基础画面,但不支持 CUDA 计算,且会占用 GPU 设备节点。安装官方闭源驱动前必须禁用 Nouveau,否则两者冲突可能导致驱动安装失败或系统无法进入图形界面。禁用方式通常是在 /etc/modprobe.d/ 下新建配置文件,写入 blacklist nouveau 与 options nouveau modeset=0,再执行 update-initramfs -u 更新内核镜像并重启。云服务器通常无图形界面需求,禁用后不影响日常使用。
CUDA Toolkit 与 NVIDIA 驱动 是两个不同层次的组件:驱动负责操作系统与 GPU 硬件的通信,CUDA Toolkit 则提供编译和运行 GPU 程序的工具链(如 nvcc 编译器、CUDA 运行时库)。二者存在版本兼容关系——驱动版本需不低于 Toolkit 所要求的最低版本。安装 runfile 时若已单独装好驱动,应取消勾选驱动安装项,避免重复安装覆盖现有驱动。安装后需在 .bashrc 中设置 PATH 与 LD_LIBRARY_PATH,否则 nvcc 与相关动态库无法被找到。
PyTorch 与 vLLM 安装
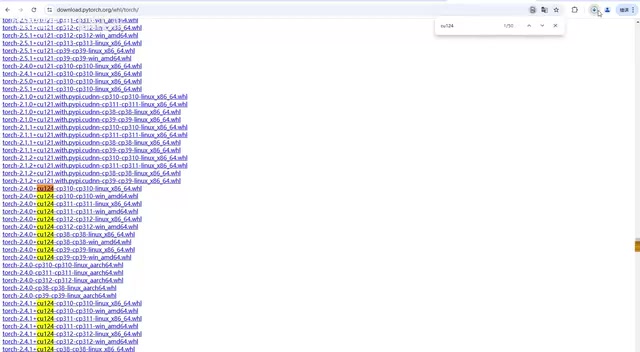
PyTorch 的版本必须和 CUDA 12.4、Python 3.10 对应,在 PyTorch 官网按 CU124 和 CP310 筛选,选择 Linux 版本下载。文件约 760MB,同样建议外部下载后上传。安装前记得先 conda activate vllm,因为 pip 安装依赖的包需要在正确的 Python 环境下运行。
最后执行 pip install vllm,UP主安装的是 0.7.2 版本。安装完成后用 vllm --version 验证——如果输出正常,说明平台识别成功;如果报错提示 “vllm is running on unspecified platform”,说明环境有问题,后续步骤必然失败,需要回头检查前面的安装。
DeepSeek-R1 模型下载与推理测试
DeepSeek广告-R1 完整版参数规模约 670 亿,文件多达十几个、每个 4-5GB,个人电脑基本无法部署。UP主建议使用蒸馏模型(DeepSeek-R1-Distill),通过更小的参数量保留大模型的推理能力,对本地资源有限的场景更实用。
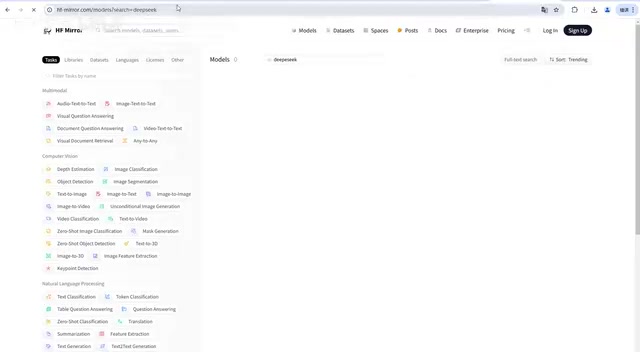
HuggingFace 需要代理访问,UP主使用 hf-mirror 镜像站搜索模型。最终选择的是 DeepSeek-R1-Distill 千问 1.5B 版本,文件仅 4GB 左右,部署压力小。下载后在服务器上创建 data/modelscope 目录存放模型文件。
推理测试用一个简短的 Python 脚本完成:指定本地模型路径、初始化 tokenizer、设置提示词(如“天空为什么是蓝色的”),加载模型后输出结果。执行脚本后,模型能正常返回 DeepSeek 风格的回复,说明部署链路全部打通。UP主也提供了完整的手册,涵盖千问模型、DeepSeek 以及基于 LangChain 的集成案例,可在评论区领取。
模型蒸馏(Knowledge Distillation) 是指用大模型(教师模型)的输出指导小模型(学生模型)训练,使学生模型在参数量大幅缩减的情况下逼近教师的推理表现。DeepSeek-R1 原始版本参数规模达 670 亿,对显存和算力要求极高;蒸馏版则以较小的基座模型(如千问 1.5B)为载体,利用 R1 生成的推理数据进行微调,保留链式思考与推理能力。参数量从 670 亿降至 1.5B,模型文件从数十 GB 压缩到约 4GB,使单张消费级或入门级数据中心卡即可部署,代价是复杂推理任务上的上限有所降低。选择蒸馏版是在成本与能力之间做权衡的常见做法。
HuggingFace 是全球最大的开源模型托管平台,国内直接访问常受网络限制。hf-mirror 是其镜像站点,提供相同的模型仓库结构与下载接口,可显著提升下载速度。使用镜像时可通过设置环境变量 HF_ENDPOINT=https://hf-mirror.com 让 huggingface-cli 或 transformers 自动走镜像,也可直接在网页端搜索并手动下载模型文件。下载后需保持模型目录结构完整(含配置文件、tokenizer 文件与权重文件),推理脚本才能正确加载。
关键提醒
这套流程的每一步都依赖版本精确对齐。Python 3.10、CUDA 12.4、PyTorch 对应版本、vLLM 0.7.x,任何一环版本错位都可能引发连锁问题。另外,-n 参数创建的 vllm 环境在重启或切换后容易回到 base 环境,操作前务必确认当前环境状态。对想要规模化应用大模型的企业来说,vLLM 的吞吐和并行能力是值得投入时间搭建的。
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。