3B模型读取日本发票,校验让准确率飙至86.8%
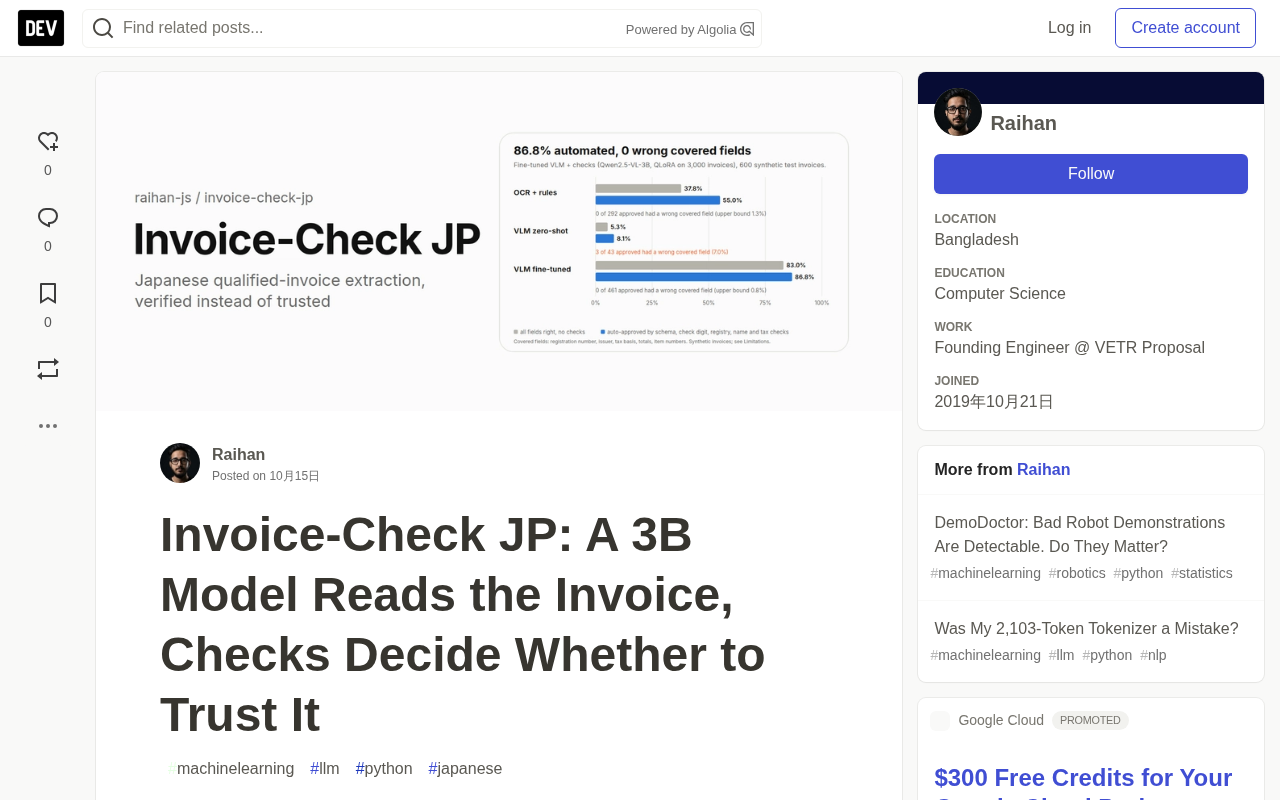
QLoRA 微调 Qwen2.5-VL-3B 提取日本合格发票,加五项校验后整票精确率 83%、自动批准率 86.8%。
本文评测了三种日本合格发票信息提取器(OCR+规则、零样本 VLM、QLoRA 微调 VLM),核心思路是用发票自带的符号化真值(注册号校验位、企业登记库、税额算术)对提取结果做五项累计校验,将"模型多准"转化为"错误漏了多少"。在 3000 张合成发票上微调的 30 亿参数模型,测试集整票精确率 83.0%、自动批准率 86.8%,已批准发票中可校验字段错误为零;而未加校验时该模型有 12.8% 的发票存在字段错误。局限在于校验无法覆盖发票号、日期和明细描述,已批准发票仍含 4.6% 未校验错误;纵书版式表现明显偏低(40.0%);合成注册库低估了"破坏一位数字命中另一家真实公司"的风险(真实库中 0.29%)。
日本合格发票(適格請求書)必须标注注册号、各税率金额与税额。这些字段自带"符号化真值"——注册号有校验位、企业编号可查公开数据库、税额是算术结果——让提取结果可以被自动验证。
开发者 raihan-js 用 Qwen2.5-VL-3B-Instruct 搭配 QLoRA 适配器,在 3000 张合成发票上微调,再用五项累计校验决定是否自动通过。在合成测试集上,整张发票完全正确的比例为 83.0%,86.8% 被自动批准,且已批准发票中没有出现校验能捕获的字段错误。
问题:与其问"模型多准",不如问"错误漏了多少"
传统 OCR 或 VLM 提取评测只看字段准确率,但发票场景真正关心的是:错误有多少被拦截,多少溜进下游流程。
日本合格发票制度恰好提供了自检条件:注册号格式固定(T 加 13 位数字),企业编号含校验位,税额按 10%/8% 税率纯算术可得。这意味着一个提取器可以对照符号化真值自我验证,而非仅靠概率置信度。
作者的关注点因此转向:校验能捕获多少错误提取,又有多少错误能绕过校验?
符号化真值(symbolic ground truth)指不依赖人工重新标注、可通过规则或数据库机械推出的"客观答案"。在本文场景中,日本合格发票的注册号(T + 13 位数字)带有校验位,企业编号可在官方登记库中查得,税额由税基乘以 10% 或 8% 得到——这些都不是主观判断,而是可被程序独立重算的结果。传统 OCR/VLM 评测往往把模型输出与人工标注比对,标注本身可能出错且成本高昂;引入符号化真值后,提取结果可以与规则和数据库交叉检验,实现自动化的"自我打分",也让"错误是否被拦截"这一真正影响下游的问题变得可量化。
方案:三个提取器 + 五项累计校验
三种提取器输出同一套 JSON 结构:
- OCR + 规则:PaddleOCR 文本框上手工编写的规则
- 零样本:Qwen2.5-VL-3B-Instruct 直接推理
- QLoRA 微调:同一模型加适配器,3000 张合成发票训练 1 轮,RTX 3060 耗时 4 小时 57 分
五项累计校验依次为:schema 结构、校验位、注册数据库查询(需在发票日期当天有效)、发行人名称与注册库比对、三种舍入约定(切り捨て/四捨五入/切り上げ)下的税额算术。全部通过即自动批准,任一失败则转人工并附带失败原因。
QLoRA(Quantized Low-Rank Adaptation)是 2023 年提出的一种参数高效微调方法,它在 4-bit 量化的基座模型上冻结全部原始权重,只在注意力层等位置注入少量可训练的低秩矩阵(LoRA 适配器)。相比全参数微调,可训练参数通常只占原模型的千分之几,显存需求大幅下降,单张消费级显卡即可完成训练。本文中 30 亿参数的 Qwen2.5-VL 在 RTX 3060(12GB 显存)上仅用约 5 小时、3000 张样本训练 1 轮,正是 QLoRA 带来的可行性;同时由于基座权重未被改写,适配器体积只有几十 MB,便于单独发布和复用。代价是量化会带来轻微精度损失,且下游任务表现高度依赖基座模型本身的能力边界。
数据与三个测试挖出的坑
数据集刻意不掺入真实企业:所有发行人虚构,名称由部件组合,注册号用真实校验位规则生成,并剔除官方登记库快照中已存在的号码。校验所用注册库也是合成数据,随数据集一起发布。共 4100 张发票,覆盖 6 种版式(含纵书 縦書き)、印章(角印)、令和与西历日期、全角数字、扫描噪声。每一页渲染结果都与金标签核对,且不同数据划分间发行人不重叠。
作者表示测试"赚回了成本",发现三个问题:
- 约五分之一的"干净"发票日期早于发行人注册日,验证器正确判定无效
- 人为注入的 1 日元税额误差可能与不同舍入约定难以区分,本质上不可检测,必须从"注入错误"集合中排除
- "破坏一位数字"生成器有时把 0 和 9 互换,而校验位看不见这种错误——因为其加权和取模 9
校验位(check digit)是编码末尾用于检测输入错误的冗余数字,通过对前面各位加权求和后取模得到。日本法人编号(国税庁注册番号)采用 13 位数字,最后一位由前 12 位按固定权重计算得出。它的特点是:单个数字被误写、相邻两位被交换时,绝大多数情况下校验位会不匹配从而被识别;但存在设计上的盲区——例如本文提到的加权和取模 9,使得 0 与 9 互换后校验和不变,这类错误无法被校验位本身捕获。理解校验位的覆盖范围与盲区,是评估"自动批准"是否可靠的先决条件。
结果:微调后自动批准率达 86.8%
| 测试集 (600) | 整票精确 | 自动批准 | 已批准中错误覆盖字段 |
|---|---|---|---|
| OCR + 规则 | 37.8% | 55.0% | 292 中 0 个(上界 1.3%) |
| 零样本 | 5.3% | 8.1% | 43 中 3 个(7.0%) |
| QLoRA | 83.0% | 86.8% | 461 中 0 个(上界 0.8%) |
"覆盖字段"指校验能捕获错误的字段:注册号、发行人名称、税基、合计及明细数字。该定义在微调模型评分前就已固定。不加校验时,微调模型有 12.8% 的发票存在覆盖字段错误。人为注入的文档问题(错误校验位、未注册号码、已注销发行人、他人号码、税额错误)69 次中 69 次被转人工,95.7% 被对应校验捕获。
校验看不见的地方
微调模型已批准的发票中,4.6% 仍含错误,全部落在无人验证的字段:10 个错误发票号、10 个错误日期、1 个明细项。原因很直接——注册库知道发行人是谁,不知道客户是谁;发行人在有效窗口内的日期即使错误也能通过。
OCR 基线更糟:32% 的已批准发票明细描述有错别字(如「費」读成「费」),任何算术都无法发现。校验让覆盖字段可安全自动化,其余字段需要另设管控。
版式薄弱点:纵书
横排版式表现优异:测试集 97.3% 精确,未见过的横排版式上 99.0%。纵书是弱项:测试集 40.0%,主因是拉丁文本侧向印刷(注册号 62.7%,日期 82.7%),表格部分反而正常;未见过的全纵书版式中表格旋转,只有 4%。
学习曲线显示加数据解决不了这个问题:零训练样本 8.7%,800 张 84.7%,2400 张与 3000 张均为 89.3%。
纵书(縦書き) 是日语中传统的自上而下、由右向左排版的书写方式,广泛用于公文、票据和正式文书。对视觉语言模型而言,纵书的难点在于:模型多在横排语料上预训练,阅读顺序、文本框的宽高比以及拉丁字符(如注册号中的"T"、阿拉伯数字)在纵书中的侧向旋转,都与训练分布不一致。这解释了本文中纵书版式高达 60% 的失败率集中在注册号和日期字段,而表格内容因结构规整反而正常;也提示仅靠增加同类纵书训练样本难以突破,需要引入多样化的纵书排版结构或专门的预处理。
合成注册库掩盖的隐患
在真实注册库(258 万家企业,全部通过校验位)上,作者对 30 万个已注册号码各破坏一位数字:校验位捕获 95.6%,查询捕获 4.1%,0.29% 会落到另一家真实公司——因为已注册号码存在聚集。只有比对发行人名称才能抓住这些。合成注册库不具备聚集特征,因此低估了这一风险,名称校验才是兜底。
局限与后续
- 合成发票比真实发票更干净规整:6 种版式、18 种商品、两种税率、仅限法人。不对真实发票做任何承诺。
- 未覆盖个体户:无公开校验位规则,个人注册数据属个人信息,未加载。
- 单一模型、单次运行、单一随机种子。
- 基座模型 Qwen2.5-VL-3B-Instruct 采用 Qwen Research License,因此适配器仅限非商业研究用途。
代码、69 项测试、数据集生成器与全部结果文件均在仓库;数据集与适配器已发布在 Hugging Face。bash scripts/gpu_chain.sh 可重跑零样本、训练与微调评测,崩溃后断点续跑。
作者计划的下一步包括:在有权使用的真实发票上测试;从客户主数据增加收件人校验;采用许可证更宽松的更大基座模型;让纵书版式拥有多于一种训练结构。
相关推荐

OpenAI与Shield合作:Astra智能体如何革新IT故障修复
OpenAI与Shield合作推出Astra智能体,可自动登录电脑和遗留系统,实时修复IT故障,比传统模型快35%到40%,仅在需要人类判断时引入人工。

iPhone Duo续航实测:一天一充跑不掉,大屏是耗电元凶
iPhone Duo续航实测:重度使用一天需至少充电一次,6.5小时亮屏约剩30%电量。大屏展开频率是耗电关键,MagSafe电池背夹可救场,长期衰减同样值得关注。

Kimi K3.1 Pro开源发布:2.8万亿参数逼近Opus
Moonshot发布开源MoE模型Kimi K3.1 Pro,2.8万亿总参数、1040亿激活参数,Terminal Bench 4.0仅落后Opus 5.5不到1分,单任务成本约三分之一,API价格减半,开源权重11月4日开放。