600行Python打造编程Agent运行时:循环、沙箱与子代理实战

600行Python构建的轻量Agent运行时,证明Agent失败根源在运行时而非模型。
一位开发者基于"Agent失败多源于运行时而非模型"的判断,用约600行纯Python代码实现了一个无框架依赖的编程Agent运行时并开源。其核心是健壮的执行循环——将工具调用视为不可信输入,容忍JSON格式错误和虚构工具名而不中断会话。安全层面引入macOS Seatbelt与Linux Bubblewrap操作系统级沙箱,禁用网络并限制文件写入范围。上下文管理采用cap/strip/drop/compact组合策略,并通过延迟注入保证前缀缓存生效以降低成本与延迟。项目刻意排除Docker、产品化UI和评测体系,以600行的精简规模作为可读、可学习的参考实现,为构建可靠Agent系统的开发者提供了务实的工程范本。
为什么问题往往不在模型,而在运行时
很多人在使用AI编程Agent时,遇到失败第一反应是抱怨模型能力不够。但一位开发者在Reddit上分享的经验给出了不同的判断:多数时候,问题出在运行时(runtime)本身,而非大语言模型。基于这个观察,他用约600行纯Python代码写出了一个不依赖任何框架的编程Agent运行时,并将其开源。
这个项目的定位很清晰——它不是又一个大而全的Agent框架,而是一个精简、透明、可控的执行内核。它兼容OpenAI标准接口,因此可以无缝对接OpenRouter、本地模型或OpenAI官方API。对于想理解Agent底层运作机制、又不愿被臃肿框架绑架的开发者来说,这类轻量实现具有相当的参考价值。
核心设计:一个健壮的执行循环
整个运行时的骨架是一个经典的Agent循环:prompt → 工具调用 → 重复。这个模式本身并不新鲜,真正体现工程功力的地方在于它如何处理异常和边界情况。
作者的一个关键设计理念是:把工具调用当作不可信输入来对待。这意味着当模型返回格式错误的JSON、或者凭空捏造出一个不存在的工具名时,整个会话不会因此崩溃。这一点在实际生产中至关重要——大语言模型的输出天然带有不确定性,一个健壮的运行时必须假设模型会犯错,并优雅地从错误中恢复,而不是直接中断任务。
这种"防御式"的工具处理思路,正是区分玩具级Demo和可用工具的分水岭。很多失败的Agent体验,根源就在于运行时对模型的非预期输出毫无容错能力。
安全隔离:操作系统级沙箱
让Agent执行bash命令是把双刃剑:它极大地拓展了Agent的能力边界,也带来了明显的安全风险。这个项目在安全层面下了不少功夫。
对于命令执行,它提供了 allow / ask / deny 三级权限控制,并且能够识别复合命令(compound commands),避免通过命令拼接绕过限制。更进一步,它引入了操作系统级别的沙箱隔离:
- macOS 上使用 Seatbelt
- Linux 上使用 Bubblewrap
沙箱的约束相当严格——禁用网络访问,且只允许在项目目录内写入文件。这种设计意味着即便Agent执行了危险或错误的命令,破坏范围也被限制在可控区间内,不会波及系统其他部分或对外发起未授权的网络请求。相比很多直接裸奔执行shell的实现,这是一个负责任的工程取舍。
Seatbelt 是 macOS 内置的沙箱机制(底层接口为 sandbox_init),通过 Scheme 风格的策略文件描述进程被允许或禁止的系统调用,常见于 macOS 对第三方应用的权限管控。Bubblewrap(bwrap)则是 Linux 上的低权限容器工具,最初由 Flatpak 项目衍生而来,无需 root 权限即可创建隔离的命名空间(namespace),限制文件系统视图、网络访问和进程能力。两者都属于操作系统原生机制,相比 Docker 更轻量,启动开销极小,适合为每次命令执行动态创建和销毁隔离环境。这也解释了作者为何选择放弃 Docker——在沙箱安全性已经足够的前提下,引入容器会显著增加部署复杂度和启动延迟。
上下文窗口管理与子代理机制
上下文窗口是所有Agent系统的核心瓶颈。作者为此设计了一套 cap / strip / drop / compact 的组合策略,用于在有限的上下文长度内管理信息:截断、剥离、丢弃、压缩,多种手段配合使用,尽可能保留关键信息的同时控制token消耗。
一个值得关注的细节是 延迟注入(late injection):通过在合适的时机注入内容,使得前缀缓存(prefix caching)依然能够生效。这是一个实打实的性能优化——前缀缓存能显著降低重复请求的延迟和成本,而不当的上下文拼接方式会让缓存失效,白白浪费这部分收益。
此外,项目还包含了 skills(技能)、todos(任务清单)、JSONL格式的会话记录,以及一次性子代理(disposable subagents)。子代理机制允许主Agent派生出临时的、独立的执行单元来处理子任务,完成后即销毁,这有助于隔离复杂任务的上下文,避免主会话被无关信息污染。
前缀缓存(prefix caching)是主流大模型推理服务提供的一项优化特性:当多次请求共享相同的开头(前缀)时,服务端可以复用已计算的 KV Cache,从而大幅降低 TTFT(首 token 延迟)并减少计费 token 数。OpenAI、Anthropic、Google 等平台均已支持该特性。然而,前缀缓存对上下文拼接顺序高度敏感——若每次请求都在消息列表头部插入动态内容(如时间戳、实时状态),缓存命中率会骤降至零。"延迟注入"的本质是将动态内容推迟到尽可能靠后的位置插入,保持前段消息列表稳定不变,从而让缓存机制持续有效。对于长对话或高频调用的 Agent 任务,这一优化可带来可观的成本与延迟收益。
有意省略的部分
作者对项目边界的克制同样值得肯定。他明确列出了这个运行时不包含的内容:
- Docker:没有容器化封装,依赖操作系统原生沙箱
- 产品化UI:这是一个内核,不是终端产品
- 评测体系(evals):不提供开箱即用的效果评估
这种"做减法"的态度,让项目保持了600行代码的精简规模。它把自己定位为一个可读、可改、可学习的参考实现,而非试图覆盖所有场景的通用平台。对于希望深入理解Agent运行时机制的开发者,这样的代码量恰好处于"能读完、能读懂"的甜蜜点。
对开发者的启示
这个项目最有价值的地方,或许不在于代码本身,而在于它背后的判断:当Agent表现不佳时,先审视运行时,而不是急于归咎模型。工具容错、权限控制、沙箱隔离、上下文管理、缓存友好——这些工程细节共同决定了一个Agent系统的可靠性上限。
作者在帖子结尾向社区抛出了两个开放问题:如果是你,会优先添加什么功能,又会砍掉什么?这也提示我们,Agent运行时的设计充满权衡,没有唯一正确答案。对于正在构建类似系统的团队,这份600行的开源实现值得作为一个起点去研读和借鉴。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
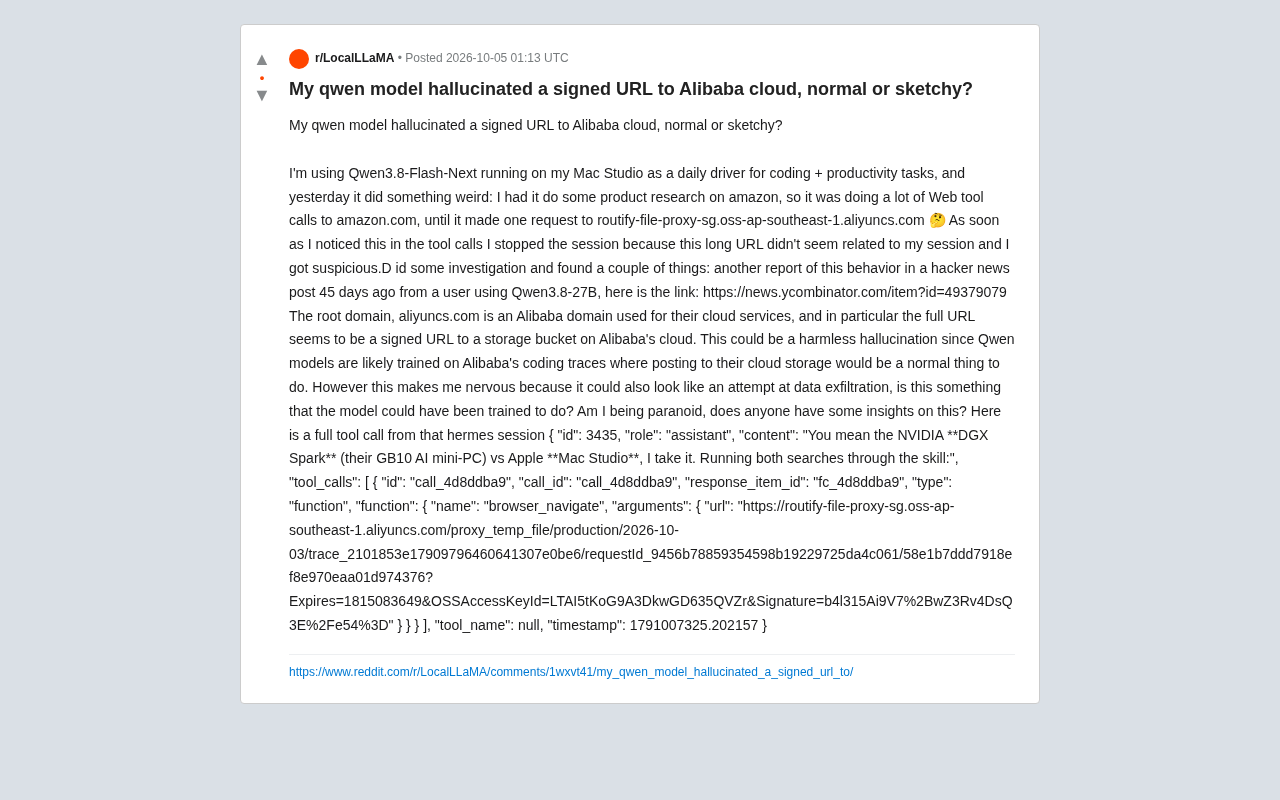
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。