8GB内存跑RAG频繁OOM?Docling处理PDF的内存优化实战思路

Docling解析PDF内存溢出的根因分析与RAG工程化的分批策略、工具降负载及云端解耦部署方案。
一位开发者在用Docling构建RAG系统时,因8GB内存频繁OOM而陷入困境。文章指出,按页数分批处理方向正确,但根本问题在于单页内容复杂度而非页数本身,需细化到按内容复杂度切分并对失败批次做降级重试。工具层面可通过关闭Docling的OCR和表格识别、降低渲染分辨率,或改用PyMuPDF等轻量库来主动降低内存压力。部署层面不能寄望于"换AWS自然解决",应先在本地用代表性文档样本统计内存峰值,再以此选型实例规格;同时将重量级的离线PDF解析与轻量的在线检索问答解耦为异步批处理作业加弹性服务两条链路,才能兼顾稳定性与成本可控。
问题背景:Docling 处理 PDF 时的内存溢出
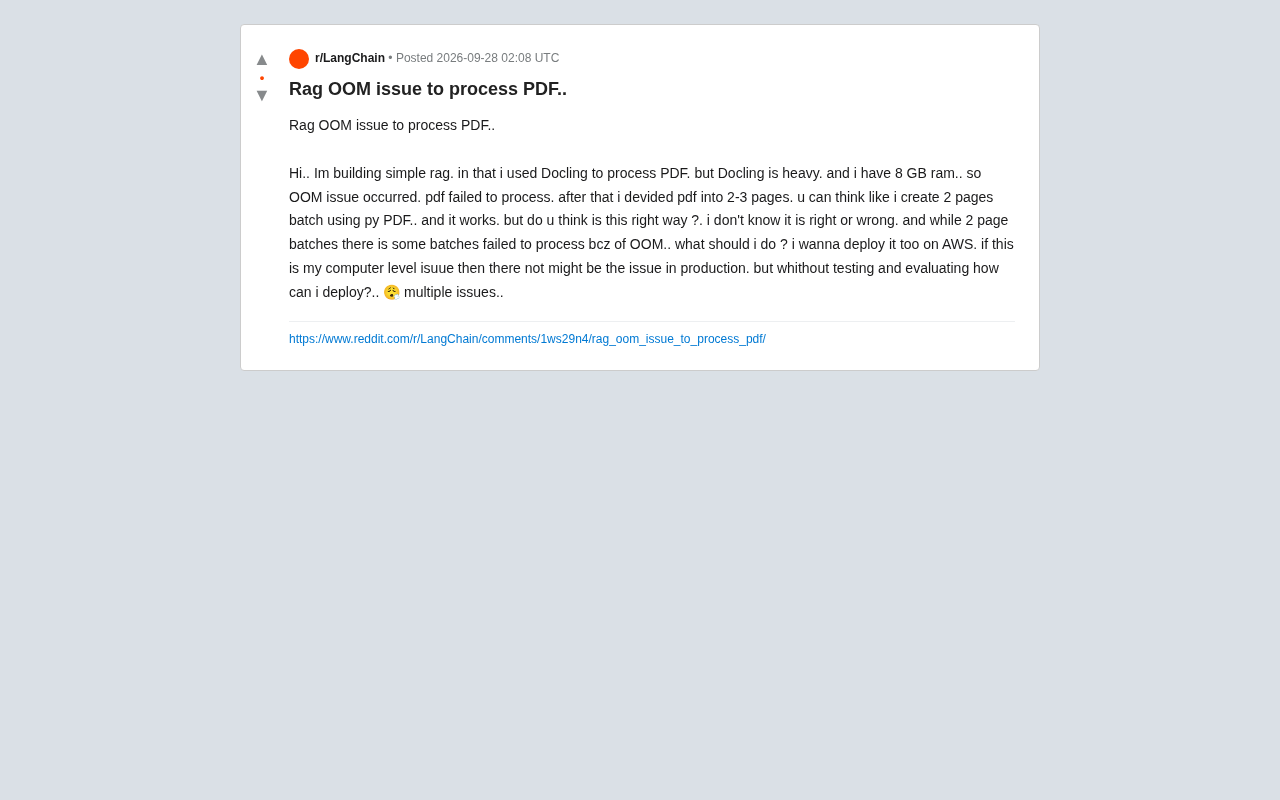
一位开发者在 Reddit 上分享了自己搭建 RAG(检索增强生成)系统时遇到的典型困境:使用 Docling 解析 PDF 文档,但由于 Docling 本身较为“重量级”,在仅有 8GB 内存的机器上频繁触发 OOM(Out Of Memory,内存溢出),导致 PDF 无法完整处理。
为了绕过这个问题,他尝试用 PyPDF 把 PDF 拆分成每 2-3 页的小批次逐个处理,结果大部分能跑通,但仍有部分批次因内存不足失败。更让他焦虑的是后续的部署问题:如果这只是本地机器配置不足导致的,那生产环境或许没问题;但在没有充分测试和评估的前提下,又该如何放心部署到 AWS?
这个案例虽小,却折射出许多 RAG 初学者共同面临的工程化难题——文档解析工具的资源开销、批处理策略的合理性,以及本地到云端的部署衔接。
Docling 是由 IBM 开源的文档解析框架,核心能力在于对 PDF 进行深度结构化理解:它不仅提取文本,还能识别表格结构、图表、标题层级和页面布局,并将结果输出为结构化格式(如 Markdown、JSON)。实现这些能力依赖多个 AI 模型——包括布局检测模型(LayoutLM 系列)和表格识别模型,这些模型在首次运行时需要加载进内存,再叠加页面栅格化和中间数据结构,总体峰值内存轻易达到 4-6GB,在 8GB 机器上与操作系统、Python 运行时竞争后非常容易触发 OOM。这与 PyPDF、pdfplumber 等"直读文本流"的轻量库有本质差异——后者不加载神经网络模型,内存占用通常在数十 MB 级别。
分页批处理是不是“正确姿势”?
先给出结论:将大 PDF 拆分成小批次处理,本身是一种合理且常见的工程手段,谈不上“错误”。文档解析(尤其是包含表格、图像、复杂版式的 PDF)本就是内存密集型任务,Docling 在解析时会加载模型、渲染页面、执行布局分析,峰值内存占用很容易超出 8GB。
分批处理的核心价值在于控制单次内存峰值,这与数据库分页、大文件流式读取的思路一脉相承。所以开发者的直觉方向是对的。
不过,仅靠“每 2-3 页一批”仍有批次失败,说明问题的根源不只是页数,而是单页内容的复杂度。一页密集的表格、高分辨率扫描图或矢量图形,其解析开销可能是一页纯文本的数十倍。因此单纯按页数切分是“粗粒度”方案,遇到重页依然会崩。
更稳健的批处理策略
- 降到单页处理:把 batch size 进一步降到 1 页,牺牲一点吞吐换取稳定性。
- 对失败批次做降级重试:捕获 OOM 异常后,对失败的批次单独用更轻量的解析路径重跑。
- 按内容类型区分:对扫描件走 OCR 轻量管线,对原生文本 PDF 走纯文本抽取,避免用重管线处理所有页面。
从工具层面减轻 Docling 的内存压力
Docling 功能强大,但功能全开时开销也大。如果本地资源紧张,可以从配置入手削减不必要的处理:
- 关闭用不到的解析能力:如果文档不含表格或不需要表格结构识别,可关闭表格结构提取;不需要 OCR 时禁用 OCR,这两项通常是内存大户。
- 降低图像渲染分辨率:Docling 在做布局分析时会对页面栅格化,适当降低 DPI 可显著减少内存占用。
- 及时释放对象与手动 GC:在 Python 中,每处理完一批后显式删除大对象并调用
gc.collect(),避免内存碎片堆积。 - 评估更轻量的替代方案:若文档结构简单,PyMuPDF(fitz)、pdfplumber 等纯文本抽取库的内存占用远低于 Docling,可作为主力,Docling 仅用于处理复杂页面。
选型的关键是匹配文档实际复杂度,而不是默认上最重的工具。
本地测试与 AWS 部署如何衔接
开发者的另一个困惑很有代表性:本地跑不动,是否意味着生产环境也不行?如何在部署前完成测试评估?
这里需要区分两个层面的问题:
1. 内存问题在生产环境同样存在
不要假设“换到 AWS 就没事了”。云端确实可以配置更大内存的实例(如 16GB、32GB),能缓解 OOM,但成本随之上升,而且如果解析逻辑本身不受控,量级更大的文档依然会撑爆内存。正确做法是先在本地把内存占用控制在可预测范围,再据此选择实例规格。
2. 把文档处理与在线服务解耦
对于生产级 RAG,推荐将 PDF 解析(离线的、重的) 与 检索问答(在线的、轻的) 拆分为两条链路:
- 文档解析放到异步任务或批处理作业中执行,可以用较大内存的实例或 AWS Batch、Lambda(注意 Lambda 内存上限)跑一次性摄取,处理完把向量写入向量库。
- 在线问答服务只负责检索和调用 LLM,内存需求小、可弹性伸缩。
这样即便解析环节偶尔失败,也不影响线上服务稳定性,还能对失败文档单独重试。
3. 测试评估的可行路径
- 用一批代表性文档样本(覆盖纯文本、表格、扫描件等类型)在本地做端到端跑通,记录每类文档的内存峰值。
- 对失败样本分类统计,定位是哪种页面类型触发 OOM。
- 以此推算生产实例的内存配置,并保留降级与重试逻辑。
小结
这位开发者遇到的其实是 RAG 落地中的经典“三连击”:解析工具太重、批处理颗粒度不够细、本地到云端的部署缺乏清晰路径。
应对思路可以概括为:分批处理方向正确,但要细化到按内容复杂度切分;从 Docling 配置和工具选型上主动降负载;把重解析与在线服务解耦,用异步作业 + 弹性检索的架构去部署。先把内存占用变得可预测,部署到 AWS 才谈得上有底气。
背景补充
RAG(Retrieval-Augmented Generation,检索增强生成)是一种将外部知识库与大语言模型结合的架构范式。其基本流程是:先将文档解析、切块并向量化后存入向量数据库(离线摄取阶段),用户提问时再通过语义检索找到相关文本块,连同问题一起送给 LLM 生成答案。PDF 解析质量直接决定后续检索的准确性——如果表格内容被解析成乱序文本、章节结构丢失,检索结果就会失真,最终影响 LLM 的回答质量。因此文档解析虽然是 RAG 管线的"第一步",却往往是整体效果的瓶颈之一,值得在工程层面认真对待,而不是用任意工具凑合跑通就行。
AWS Batch 是亚马逊提供的全托管批处理计算服务,适合运行耗时、耗内存的离线任务:它按需启动 EC2 实例、执行作业后自动销毁,只按实际运行时间计费,无需常驻服务器。AWS Lambda 则是无服务器函数计算,适合轻量、短时任务,但当前内存上限为 10GB、超时上限 15 分钟,对单个大 PDF 的深度解析可能不够用。实际的文档摄取管线常见做法是:S3 上传 PDF 触发 Lambda 做预检和路由,复杂文档转交 AWS Batch(或 ECS 任务)完成重量级解析,结果写入 OpenSearch、Pinecone 等向量库,全程与在线问答 API 完全隔离。这种解耦使得解析失败只影响摄取队列,不会波及用户侧的检索服务。
相关推荐

MrBeast百万美元挑战:吃空整家超市的内容工业拆解
深度拆解MrBeast百万美元吃空超市挑战:430万卡路里、202天封闭拍摄、规则设计与人物成长,解析头部内容创作者的工业化方法论与商业慈善双线叙事。

Cloudflare 推出 OHTTP 网关:隐私保护的新基础设施
Cloudflare 宣布推出 OHTTP 网关服务,通过中继与网关职责分离,将用户身份与请求内容解耦,为应用遥测、隐私合规等场景提供托管式隐私保护基础设施。本文解析 OHTTP 原理、信任模型与适用局限。

AI 自动化冷邮件:从网站痛点生成个性化外联的实战思路
一位网页设计从业者分享如何用 AI 工具 Swokei 自动诊断潜在客户网站的设计、速度、移动端与 SEO 问题,并生成个性化冷邮件,重构 B2B 外联工作流。本文解析其价值、分工逻辑与合规边界。