AdaMem:让RAG按相关性智能分配记忆token的软压缩新方法

AdaMem按段落相关性动态分配记忆token预算,让RAG软压缩在激进压缩比下仍保持高质量
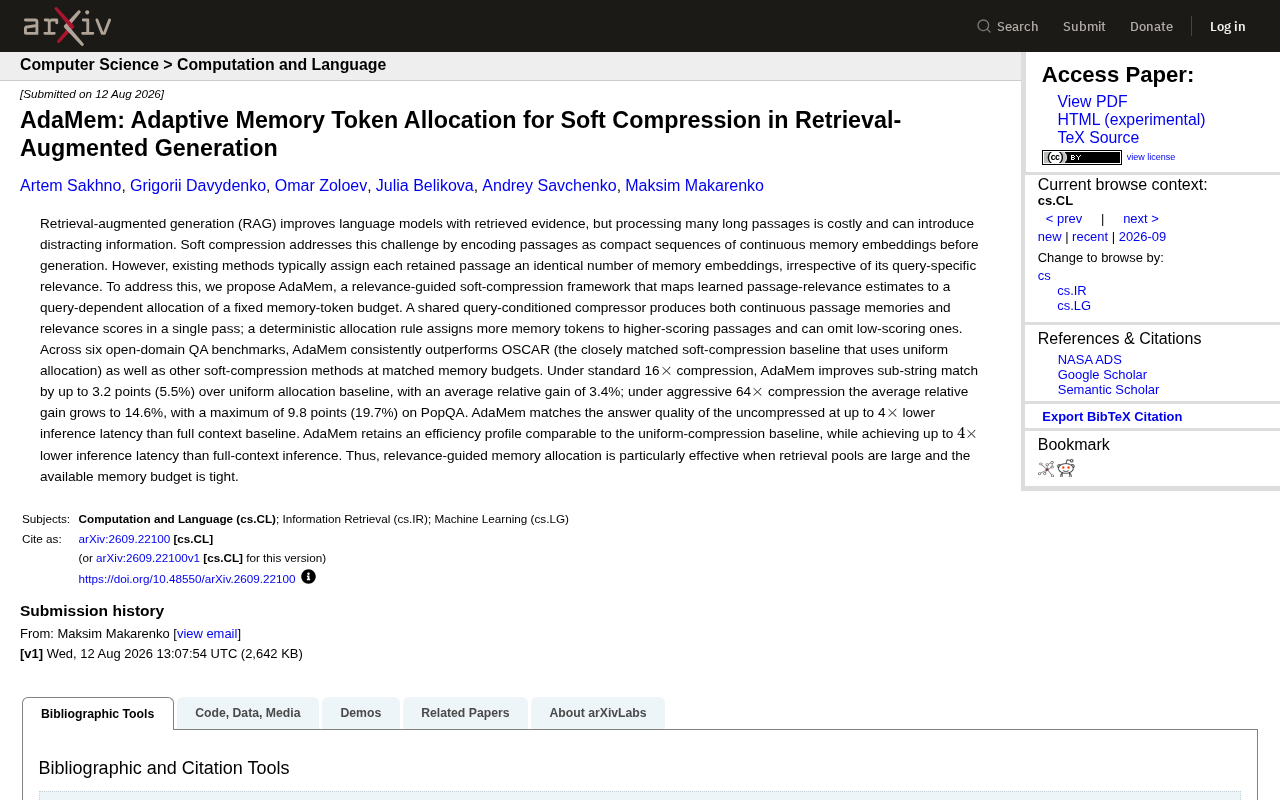
AdaMem 针对现有RAG软压缩方法「均匀分配记忆token」的核心缺陷,提出相关性引导的动态分配框架。其共享的查询条件压缩器在单次前向传播中同时产出段落记忆嵌入和相关性分数,再由确定性规则将有限预算集中分配给高相关段落、直接省略低分段落。在六个开放域问答基准上,AdaMem在16倍压缩下平均相对增益3.4%,64倍激进压缩下增益扩大至14.6%,PopQA最高提升19.7%,且推理延迟相比全上下文推理最高降低4倍。压缩比越高、预算越稀缺,智能分配的优势越明显,为构建大规模、低延迟RAG系统提供了实用的「按需分配记忆」方案。
RAG的效率困境:长文本压缩的代价
检索增强生成(RAG)通过引入外部检索证据来增强语言模型的表现,已经成为构建知识密集型应用的主流范式。但这套机制有个绕不开的问题:当模型需要处理大量长篇章时,计算成本会急剧上升,而且冗余、无关的信息还可能干扰生成质量,让答案偏离要点。
为了缓解这一压力,研究界提出了「软压缩」(soft compression)方案——在生成之前,把检索到的段落编码成一组紧凑的连续记忆嵌入(memory embeddings),用少量的向量替代冗长的文本。这种做法能显著降低推理开销,但现有方法普遍存在一个明显的设计缺陷。
「软压缩」与「硬压缩」是两种截然不同的上下文压缩路径。硬压缩(hard compression)在token空间中操作,通过抽取、删减或摘要等方式缩短文本,结果仍是可读的自然语言;软压缩则在向量空间中操作,将整段文本编码为数个稠密的连续嵌入向量,这些向量无法被人直接阅读,但可以作为「软提示」(soft prompt)传入语言模型的注意力层,让模型直接在向量表示上进行推理。软压缩的优势在于信息密度极高——理论上几个向量就能捕获数百token的语义——但代价是对压缩器和生成器之间的对齐训练要求较高,且压缩后的表示无法跨模型通用。OSCAR 是该领域的代表性先驱工作,它验证了用固定数量的记忆嵌入替代检索段落的可行性,也正因其「均匀分配」的默认设计,成为 AdaMem 最直接的对照基线。
均匀分配的浪费:现有软压缩的短板
问题的核心在于分配策略。现有的软压缩方法(如 OSCAR)通常给每个保留下来的段落分配相同数量的记忆嵌入,完全不考虑该段落对当前查询的相关程度。
这显然是一种浪费。在真实的检索场景中,检索池里的段落质量参差不齐——有的段落高度契合问题、包含关键答案,有的则只是勉强沾边甚至完全无关。给这两类段落分配同样多的「记忆预算」,既让重要信息无法充分表达,又让无关内容白白占用宝贵的token额度。当检索池很大、可用记忆预算又很紧张时,这种均匀分配的低效尤为突出。
AdaMem的核心思路:相关性引导的动态分配
针对这一痛点,研究者提出了 AdaMem——一个由相关性引导的软压缩框架。它的核心创新在于:把学习到的段落相关性估计,映射为对固定记忆token预算的查询相关动态分配。
具体机制上,AdaMem 有几个值得关注的设计:
单次前向完成压缩与打分
AdaMem 使用一个共享的、以查询为条件的压缩器(query-conditioned compressor),在一次前向传播中同时产出两样东西:连续的段落记忆表示,以及每个段落的相关性分数。这意味着相关性评估几乎不增加额外开销,避免了「先打分再压缩」的两阶段成本。
确定性的预算分配规则
拿到相关性分数后,AdaMem 通过一个确定性的分配规则来划分记忆token:给得分更高的段落分配更多的记忆token,同时可以直接省略那些得分过低的段落。这样一来,有限的记忆预算被集中投放到真正有价值的证据上,实现了「好钢用在刀刃上」的效果。
「查询条件压缩器」(query-conditioned compressor)的设计背后有一个重要动机:传统的压缩器通常以段落本身为唯一输入,生成与查询无关的通用摘要表示。但在 RAG 场景中,同一段落对不同问题的信息价值差异极大——关于某城市气候的段落,在回答「该城市冬季降雪量」时极为关键,在回答「该城市经济 GDP」时则几乎无用。将查询信号注入压缩过程,使压缩器能够「知道自己在为谁服务」,从而在有限的记忆向量中优先保留与当前问题最相关的语义细节。这一思路与信息检索中的「查询感知摘要」(query-aware summarization)一脉相承,核心理念是:压缩不应追求通用保真,而应针对具体查询最大化信息利用率。
实验结果:压缩越激进,优势越明显
研究团队在六个开放域问答基准上进行了评测,AdaMem 在相同记忆预算下持续优于 OSCAR(采用均匀分配的紧密对照基线)以及其他软压缩方法。
几个关键数据尤其能说明问题:
- 在标准的 16 倍压缩下,AdaMem 的子串匹配(sub-string match)相比均匀分配基线最高提升 3.2 个百分点(5.5%),平均相对增益为 3.4%。
- 在更激进的 64 倍压缩下,平均相对增益扩大到 14.6%,在 PopQA 数据集上最高提升达到 9.8 个百分点(19.7%)。
这个趋势很有启发性:压缩比越高、预算越紧张,智能分配相比均匀分配的优势就越大。原因不难理解——当每个token都变得极为稀缺时,「把资源分给谁」的决策价值就被成倍放大了。
子串匹配(sub-string match)是开放域问答评测中广泛采用的自动化指标,其判断逻辑为:若模型生成的答案文本中包含标准答案字符串作为子串,则视为答对。相比精确匹配(exact match),该指标对答案的表述形式更为宽容,能够容纳轻微的措辞差异;相比基于语义相似度的评估方法,它又足够简洁、可复现。PopQA 是一个基于维基百科长尾实体构建的问答数据集,其特点是大量问题涉及冷门知识,语言模型通过参数记忆直接答对的概率较低,因此对检索质量的依赖程度更高——这也解释了为什么 AdaMem 在 PopQA 上的提升幅度(19.7%)远超平均水平:当模型本身「不知道答案」时,检索信息是否被充分保留,对最终结果的影响会被成倍放大。
效率表现:不牺牲速度的质量提升
性能提升如果以牺牲效率为代价,实用价值就会大打折扣。AdaMem 在这方面交出了不错的答卷:它保持了与均匀压缩基线相当的效率曲线,同时相比全上下文(full-context)推理,推理延迟最高可降低 4 倍。
更关键的是,AdaMem 能够在延迟低至全上下文基线 1/4 的情况下,匹配未压缩方案的答案质量。也就是说,它在几乎不损失答案准确度的前提下,把推理速度提上去了——这正是软压缩技术追求的理想状态。
结语:稀缺预算下的智能取舍
AdaMem 的价值主张可以概括为一句话:当检索池很大、记忆预算很紧时,相关性引导的记忆分配格外有效。 它没有引入复杂的额外模块,而是通过「共享压缩器一次出结果 + 确定性分配」的简洁设计,把资源分配这件事做得更聪明。
对于正在构建大规模 RAG 系统、又对推理成本和延迟敏感的团队来说,AdaMem 提供的这套「按需分配记忆」的思路,值得在实际管线中关注和借鉴。随着 RAG 应用规模的持续扩大,如何在有限预算下最大化检索证据的信息密度,将会是一个越来越核心的工程与研究议题。
相关推荐
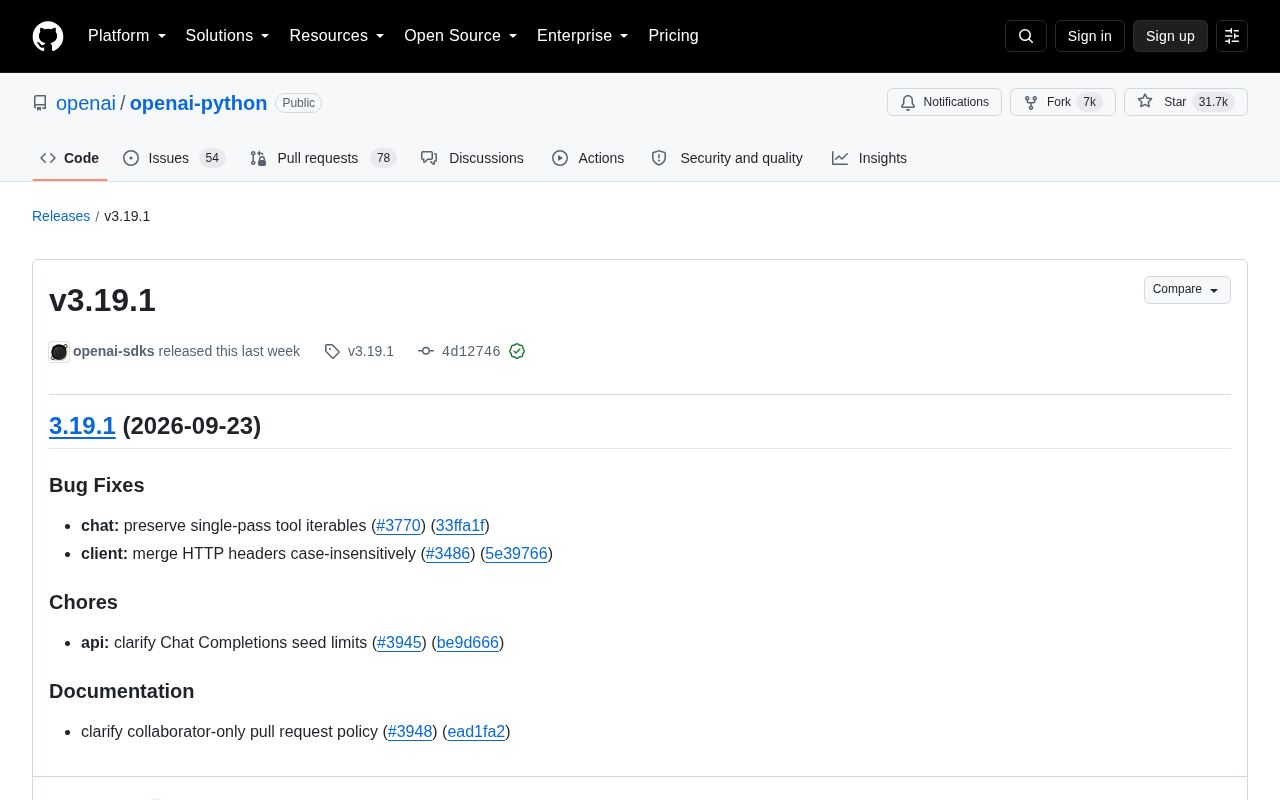
OpenAI Python SDK v3.19.1 发布:修复工具迭代与请求头问题
OpenAI Python SDK v3.19.1 发布,修复了单次调用工具迭代对象丢失、HTTP 请求头大小写合并等问题,并澄清了 Chat Completions 的 seed 参数限制。面向开发者的低风险维护性升级指南。
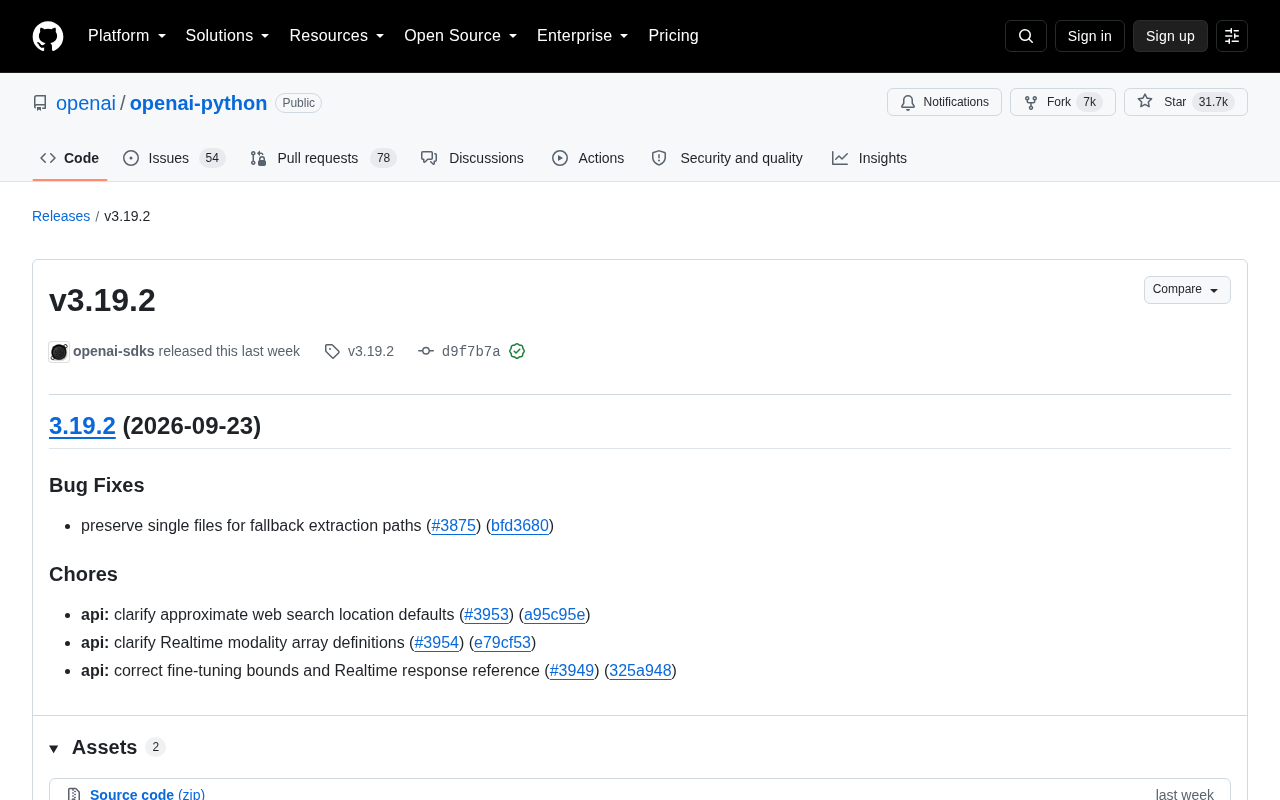
OpenAI Python SDK v3.19.2 发布:修复文件回退与API文档澄清
OpenAI 官方 Python SDK 发布 v3.19.2 版本,修复文件回退提取路径问题,并澄清 web search 位置默认值、Realtime 模态定义及 Fine-tuning 边界等多项 API 文档。本文解析更新要点与升级建议。
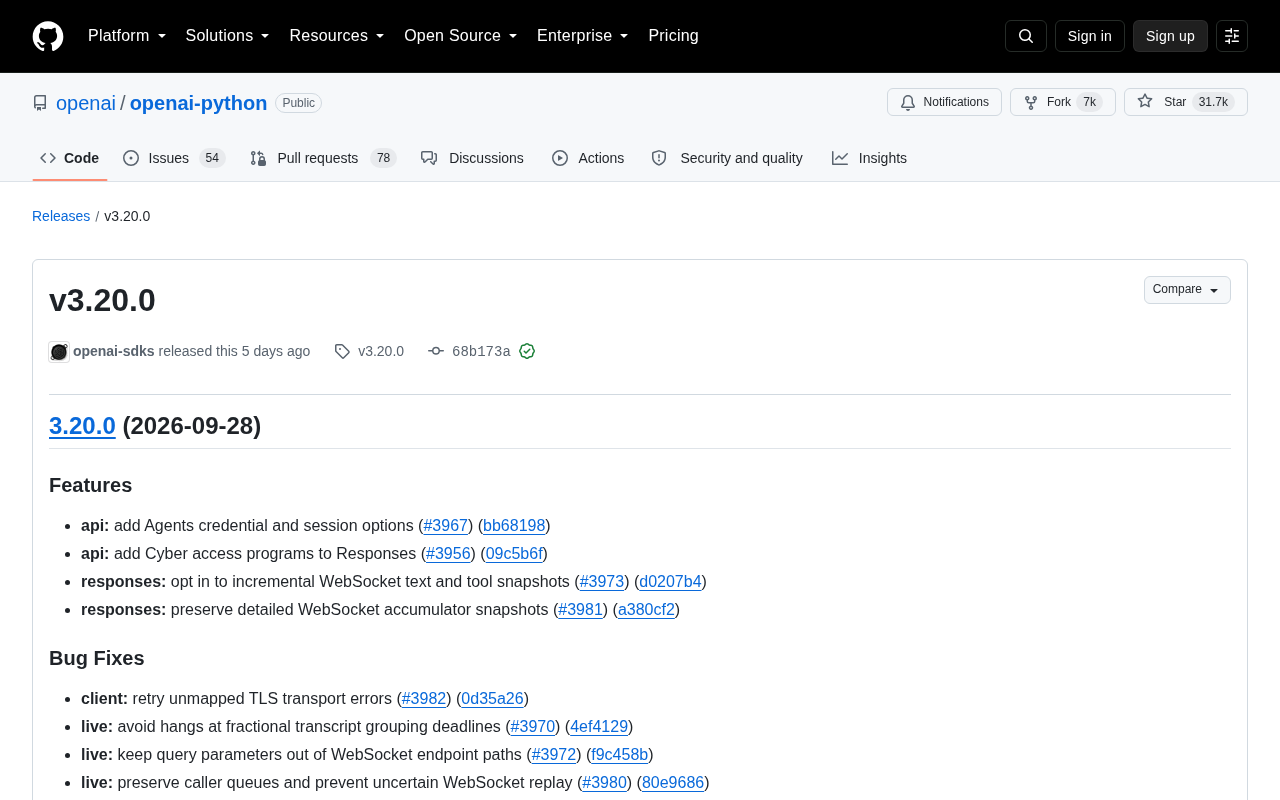
OpenAI Python SDK v3.20.0发布:Agents凭证与WebSocket增强
OpenAI 官方 Python SDK v3.20.0 正式发布,新增 Agents 凭证与会话选项、Responses WebSocket 增量快照,并集中修复实时连接稳定性问题,同时完善 API 错误响应文档。