ADE Index:收录975款智能体编程工具的可溯源排名索引

ADE Index 收录 975 款智能体编程工具并提供可溯源排名,试图破解 AI 编程工具选型难题。
文章介绍了在 Hacker News Show HN 板块发布的 ADE Index 项目,它收录了 975 款智能体编程工具,并以「可溯源」和「排名」作为两大核心设计。文章指出,智能体编程工具数量激增且同质化严重,开发者真正的痛点是无法判断哪个工具值得投入时间,而带排名的索引可以充当初筛器,把候选集从近百个压缩到个位数。同时文章保持审慎:该项目在 Hacker News 上仅获 3 个点数和 1 条评论,排名方法论尚未经过大规模用户检验,建议开发者将其作为探索起点而非决策终点,结合文档、提交记录与社区口碑做二次验证。
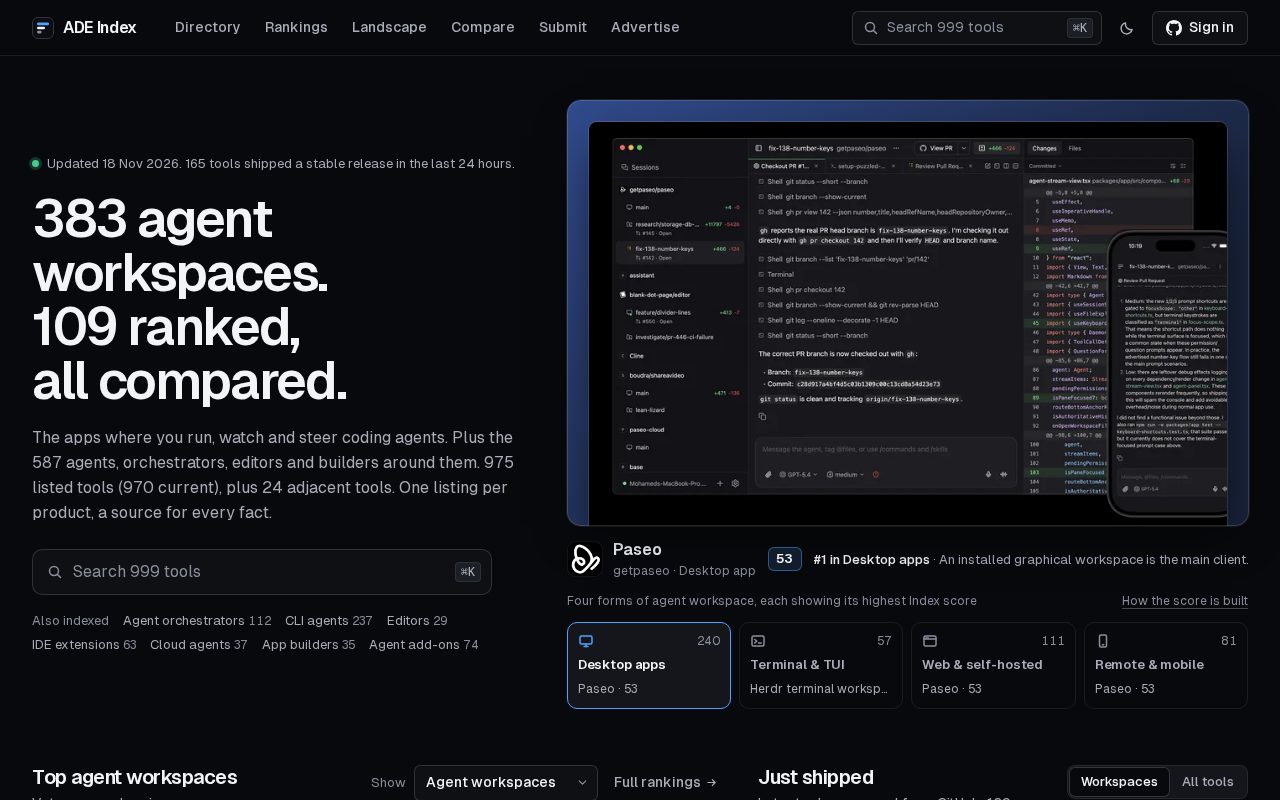
AI 编程工具正以惊人的速度涌现,开发者面对琳琅满目的选择时,往往难以判断哪些项目真正活跃、哪些只是昙花一现。在 Hacker News 的 Show HN 板块,一个名为 ADE Index 的项目试图解决这一信息过载问题——它建立了一个收录 975 款智能体编程工具(agentic coding tools) 的索引,并声称每一项都有来源标注与排名。
为什么需要一个智能体编程工具索引
「智能体编程」(agentic coding)指让 AI 不只是补全代码,而是能自主规划任务、调用工具、迭代修改甚至提交 PR 的工作方式。这一类工具在过去一段时间里数量激增:从 IDE 插件、命令行代理,到独立的编码助手与自动化流水线,形态各异,命名与能力边界也高度重叠。
对开发者而言,真正的痛点不是"找不到工具",而是"无法判断哪个值得投入时间"。一个工具可能有漂亮的官网,却已数月没有提交;也可能默默无闻,但社区讨论热度很高。ADE Index 的价值主张,正是把"可溯源"(sourced)与"排名"(ranked)放在最前面——不只是罗列链接,而是为每个条目提供信息来源,并给出可比较的位次。
Agentic coding 与传统的 AI 代码补全有本质区别。以 GitHub Copilot 为代表的补全工具,工作模式是「人在编辑器中输入,模型给出续写建议」,控制权始终在开发者手中。而 agentic coding 工具通常具备任务规划(将一句自然语言需求拆解为多步)、工具调用(读写文件、执行命令、运行测试、访问网络)和自我迭代(根据错误反馈修改方案)三个特征,最典型的形态是能端到端完成一个 issue 并提交 PR 的编码代理。这一范式转变意味着工具的评估维度从「补全准确率」扩展到任务完成率、执行成本、失败恢复能力等更复杂的指标,也正因为如此,简单的功能罗列已不足以支撑选型。
ADE Index 的两个核心设计
可溯源的收录方式
索引类产品的通病是数据来路不明:条目怎么来的、信息多久更新一次、是否包含付费推广,用户无从得知。ADE Index 强调每个工具都有来源,这意味着排名背后有可查证的依据,而非编辑拍脑袋的排序。对开发者来说,这直接决定了索引的可信度——当你依据它选型时,至少知道结论是从哪里推导出来的。
在工具索引领域,「来源可溯」(sourced)通常意味着每个条目关联着可查证的信息出处,例如官方仓库地址、文档页面、发布时间、Star 数与最近提交时间等公开元数据,而非仅由编辑手工撰写描述。与之相对的常见做法是纯人工策展,条目来源不透明,难以判断是否夹杂赞助或推广。可溯源设计的实际价值在于:当某个排名受到质疑时,用户可以回溯到原始数据自行判断;也便于后续通过脚本定期抓取来更新条目,降低索引随时间失真的风险。不过需要注意,来源本身的质量参差不齐,若来源仅是官网宣传文案,其可信度仍有限。
规模与排名的结合
975 款是一个相当可观的覆盖量。仅凭数量并不构成壁垒,但数量加上排名就形成了筛选漏斗:开发者可以先看头部工具的排序,再按需下探到细分领域。这种"广度收录 + 分层排序"的结构,比单纯的工具导航站更接近真实的选型决策流程。
这类索引对开发者意味着什么
智能体编程赛道的一个显著特征是同质化严重。大量工具在功能描述上高度相似,真正的差异体现在工程成熟度、社区活跃度和实际任务完成率上。人工逐个试用既不现实,成本也高。一个带排名的索引可以在早期阶段充当"初筛器",把候选集从近百个压缩到个位数。
另一个值得关注的点是时效性。AI 编程工具的生命周期普遍偏短,一个索引如果不能持续更新,很快就会失真。ADE Index 把"来源"作为核心卖点,某种程度上也是在为后续的持续维护预留了可验证的路径。
同质化在 AI 编程工具赛道尤为突出,一个重要原因是底层模型能力趋同:大量工具实际上是在相同的闭源或开源大模型 API 之上封装不同的交互层与工程流程。这导致功能列表看起来高度相似,真正的差异往往藏在提示词工程、上下文管理策略、沙箱执行环境、错误重试机制等不易从官网看出的细节里。因此,衡量这类工具的常用客观信号包括仓库提交频率、issue 响应速度、基准测试成绩(如 SWE-bench 等真实 GitHub issue 修复评测)以及社区讨论密度。人工试用的问题在于成本高且样本单一——一位开发者的几个日常任务很难覆盖工具的能力边界,这正是聚合型索引试图用规模和排名来弥补的地方。
需要保持的审慎
目前该项目在 Hacker News 上的讨论热度还不高,帖子仅获得 3 个点数、1 条评论,社区反馈样本极少。这意味着排名方法论是否经得起推敲、数据更新频率如何、是否存在收录偏差,都还没有经过大规模用户的检验。
对于打算使用这类索引的开发者,合理的做法是把它当作探索的起点而非决策的终点:用排名缩小范围,再结合工具的实际文档、提交记录与社区口碑做二次验证。索引解决的是"知道有哪些",而不是"确认哪个最好"。
小结
智能体编程工具的数量膨胀,正在催生一批"元工具"——不直接写代码,而是帮助开发者管理选择。ADE Index 以 975 款工具的收录量和可溯源排名切入这一需求,思路清晰。它能否成为该领域可信赖的参考坐标,取决于后续的数据维护力度与排名透明度,而这恰恰是索引类产品最难坚持的部分。
相关推荐

Gemini 4 Hydrogen 对比测试:仅耗1%周配额,表现不输Sonnet
实测Gemini 4 Hydrogen与Sonnet完成同一CRUD任务:Hydrogen仅耗1%周配额,表现相当且UI细节更优,而Anthropic模型耗7%。开发者建议日常任务不必迷信高价模型。

Gemini 4 Neon发布:多项基准超越Opus 5.5,谷歌重回第一梯队
谷歌DeepMind发布Gemini 4 Neon,Artificial Analysis智能指数61分排名第三,编程指数登顶第一,多项基准超越Opus 5.5,定价每百万token输入3美元输出15美元,已在Gemini API和AI Studio开放。

Gemini 4 Neon评测:跑分直逼Carbon,API性价比解析
Google Gemini 4 Neon 全面评测:跑分直逼 Carbon,API 定价为 Hydrogen 两倍,Antigravity 额度消耗仅一倍而 Carbon 为三倍,实测可替代 90% Carbon 场景。附渠道限制、封号风险与组合策略分析。