Agaemon:AI智能体与执行之间的治理层解析
Agaemon是一个介于AI智能体与实际执行之间的授权治理层,专为金融和区块链高风险场景提供可解释的操作审批与拦截机制。
随着AI智能体开始承担链上交易、资金管理等真实高风险操作,「谁来授权每一步动作」成为关键问题。Agaemon是一个定位于AI智能体与执行动作之间的治理与决策层,其工作流程为:智能体提出动作→Agaemon对照预设策略边界评估授权→放行或拦截→生成含解释性证据的决策记录。与「用一个AI监视另一个AI」的方案不同,它采用确定性策略规则替代概率性模型判断,从根本上规避了递归监督的困境。项目主要面向金融、DeFi和区块链开发者,利用这些场景动作不可逆、价值直接、合规要求严苛的特点切入,目前已完成自身集成并招募外部开发者进行沙盒测试,寻求批判性反馈以验证方案的实际有效性。
当AI智能体开始动真格:谁来把关它的每一步操作
随着AI智能体从聊天问答走向真实世界的操作——下单交易、管理资金、执行链上合约——一个核心问题浮出水面:当一个自主智能体决定要花掉一笔钱或触发一笔转账时,究竟谁来判断这个动作是否被授权?
近期一个名为 Agaemon 的项目在 Reddit 上发起招募,希望寻找在金融、区块链领域构建AI智能体的开发者共同测试。它的定位很明确:不是又一个监视智能体的智能体,而是一个位于智能体与执行动作之间的治理与决策层(governance layer)。这个思路在当前AI Agent安全讨论中颇具代表性,值得拆解一番。
Agaemon 到底做什么
根据项目方的描述,Agaemon 的工作流程可以概括为一条清晰的链路:
- AI 智能体提出一个动作(proposes an action)
- Agaemon 评估该动作是否被授权(evaluates whether that action is authorized)
- 被授权的执行路径继续进行(authorized execution path proceeds)
- 结果被验证并生成证据(result is verified and evidence is produced)
换句话说,Agaemon 扮演的是一个「关卡」的角色。它会拿智能体提出的提案,去比对预先定义好的授权边界(Authorization/Policy boundary),然后输出一个决策,并附带一份解释——说明为什么这个动作被允许或被拒绝。
这个「决策 + 证据(decision + evidence)」的组合是关键。它不只是简单地放行或拦截,而是让每一次判断都留下可追溯、可解释的记录。对于需要审计和合规的金融、DeFi 场景来说,这种可解释性的价值很明显。
「决策 + 证据」的输出模式在技术实现上接近**可解释AI(Explainable AI,XAI)与审计日志(audit log)**的结合。可解释性意味着系统不仅输出结论(允许/拒绝),还同时输出推理路径——哪条策略规则被触发、触发时的参数值是什么。这对金融合规场景至关重要:监管机构在事后审查时不只需要知道「这笔交易被拦截了」,还需要知道「依据哪条规定、在什么条件下被拦截的」,这直接关系到机构是否满足KYC/AML(了解你的客户/反洗钱)等合规要求。与传统黑盒式风控系统相比,可追溯的决策记录也大幅降低了争议处理的成本——当智能体的操作结果出现问题时,完整的决策链路可以精确还原责任归属。
为什么强调「不是又一个监视智能体」
项目方在描述中特意划清了界限:Agaemon 的目标不是做成另一个盯着智能体、事后质疑其决策的智能体(not another agent that watches or second guesses an agent)。
这个区分很有意思。业界目前有不少「多智能体互相监督」的方案——用一个模型去审查另一个模型的输出。但这类方案往往面临成本高、延迟大、以及「谁来监督监督者」的递归难题。
Agaemon 选择的路径不同:它把自己定位为一个可移植的授权与决策层(portable authorization and decision layer),工作在智能体与执行之间的边界上。它不参与智能体的推理过程,也不去猜测智能体的意图,只在动作即将落地的那一刻,用明确的策略规则来判断这个动作是否越界。
这种设计理念的核心命题是:能否在不剥夺自主系统运行能力的前提下,让它变得更安全? 边界层的思路避免了对智能体内部逻辑的侵入,也让治理规则可以独立于具体的智能体实现而复用。
「谁来监督监督者」的递归难题在AI安全领域有一个专有名词:监督崩溃(supervisor collapse)。当你用模型A来审查模型B时,模型A本身同样可能产生幻觉、被绕过或做出错误判断,于是你需要模型C来监督A——这条链条理论上可以无限延伸。边界层(boundary layer)方案的根本突破在于:它把「判断」这件事从概率性的模型推理,替换为确定性的策略规则(policy rules)。策略规则不是另一个会犯错的模型,而是类似防火墙规则或访问控制列表(ACL)的显式逻辑——「地址X不得转账超过Y金额」这类规则要么满足、要么不满足,没有灰度地带。这就从根本上切断了递归监督的无限循环:你需要做的只是把策略规则本身定义和审计清楚,而不是再叠加一层AI。
面向金融与区块链场景的现实考量
项目方明确点名了几类目标用户:在金融、交易、资金管理(treasury)、DeFi 或区块链领域构建智能体的开发者和团队。
这个选择并非偶然。这些场景有几个共同特征:
- 动作不可逆:一笔链上交易一旦执行就难以撤回,出错的代价极高;
- 价值直接:智能体操作的对象是真金白银,安全边界的重要性被放大;
- 合规压力:金融领域天然需要审计、留痕和责任界定。
在这些场景下,「让智能体自主运行」与「确保每一步都在授权范围内」之间的张力尤为突出。Agaemon 试图用一个独立的授权层来化解这种张力——智能体可以自由决策和提案,但真正触碰执行的那一步必须先过策略这一关。
链上交易的「不可逆性」在技术上源于区块链的共识机制设计——一旦交易被打包进区块并经过足够多的确认,就不存在原生的撤销操作。这与传统金融存在本质差异:银行转账可以通过人工干预冻结或退款,但区块链上没有中央机构可以发起这一操作(除非合约本身预置了暂停或回滚逻辑)。DeFi协议中的历史教训屡次证明这一点:2016年The DAO事件中约6000万美元以太币被盗,最终只能通过争议极大的硬分叉(hard fork)来「补救」,且代价是分裂了整个社区。正是这种不可逆性,使得「执行前拦截」远比「执行后补救」更具现实意义——Agaemon所代表的授权前置模式,在区块链场景下几乎是唯一可行的安全策略方向。
招募测试:一次开放的验证
目前 Agaemon 已经完成了与自身智能体/运行时流程的集成,正处于寻求外部验证的阶段。项目方提出的合作方式相当务实:
- 一起做一个小规模的测试/沙盒集成(small test/sandbox integration)
- 定义若干个「被允许」和「被拒绝」的动作
- 观察最终产出的「决策 + 证据」是否真的有用
值得关注的是,项目方特别强调希望获得批判性反馈(critical feedback)。这种态度对于一个早期基础设施项目来说是健康的信号——真正的安全层需要经受住对抗性场景和边缘案例的考验,而不是只在理想路径上跑通。
一点观察
Agaemon 折射出 AI Agent 领域一个正在成型的趋势:随着智能体开始承担高风险的真实操作,「治理层」正在成为一个独立的基础设施品类。类似的思路也出现在权限管理、动作沙盒、工具调用审批等方向上。
不过,这个招募帖本身信息量有限,目前更多停留在概念和工作流层面。诸如策略规则如何定义、决策延迟、与主流智能体框架的兼容性、以及在真实对抗环境下的鲁棒性等关键问题,都还有待实际测试来回答。对于关注 AI Agent 安全的开发者而言,这类边界治理方案是否能真正落地,仍需保持理性观望。
相关推荐
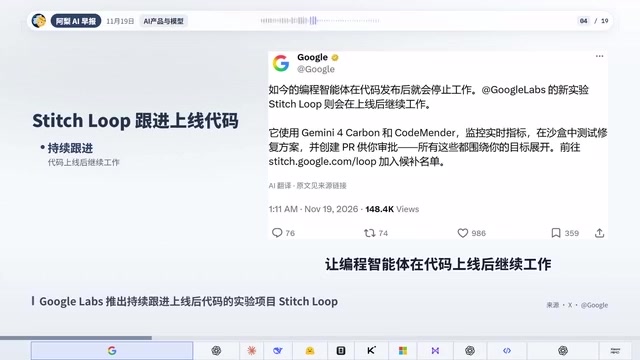
Gemini 4 Neon发布:编程登顶,Gemini 4世界模型开放
谷歌发布Gemini 4 Neon,编程代理指数登顶、支持百万Token上下文;Gemini 4世界模型开放Project Genie;DeepSeek联网搜索免费;微软公开Windows端侧小模型;白宫讨论要求美企披露是否使用中国开源模型。
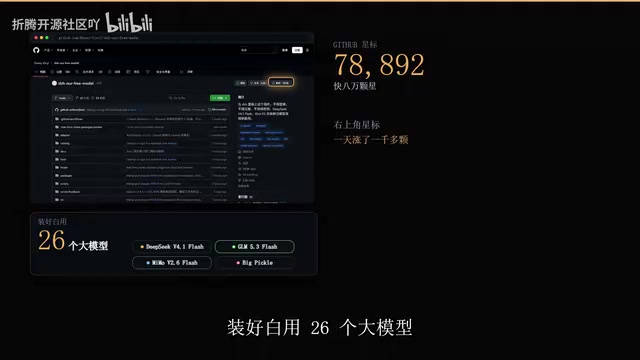
近8万星开源项目:本地白用26个大模型,DeepSeek、GLM全有
B站视频介绍一个近8万星开源项目,装好后本地白用26个大模型,DeepSeek、GLM全在里面,不用注册、不用填密钥,还能开本地地址供其他软件接入,适合不想充AI会员的轻量用户。
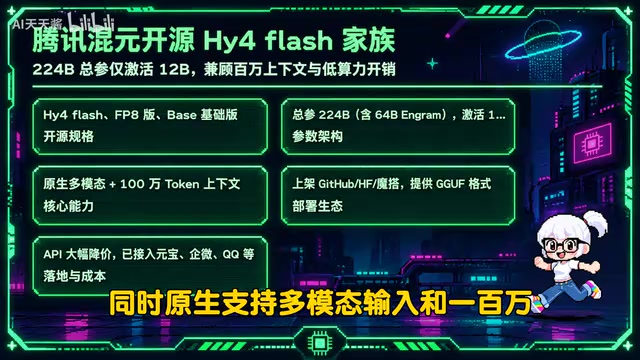
谷歌Gemini 4 Neon发布:百万元Token仅3美元,AI价格战再升级
谷歌发布Gemini 4 Neon,输入仅3美元/百万Token;腾讯混元开源Hy4 Flash;DeepSeek取消搜索抓取接口费;微软推出图像与语音新模型;英伟达停止向中国发运H200;花旗银行明确AI理财盗刷不兜底。一文速览当日AI硬核动态。