Agent+ComfyUI实战:从零打造AI长视频无缝衔接节点

B站UP主借Agent改造ComfyUI,用22帧Latent复用实现长视频无缝衔接并自建节点。
文章记录了B站UP主借助AI智能体从零攻克ComfyUI长视频衔接技术的全过程。核心原理是复用上一段视频末尾22帧的连续Latent作为下一段参考条件,绕过R2V转换,从根本上解决传统尾帧衔接的偏色与动势丢失问题。面对国外作者复杂的工作流,UP主让Agent解读逻辑、扫描缺失插件与模型并自动下载,最终将节点精简为参考条件处理与采样输出两个,并加入截取帧数下拉选项。文章还讨论了显存优化策略,包括缩短单段时长、提高分辨率、将潜空间放大分块从32调至24以避开显存临界值,以及通过分段动态调整参数保证质量。最后总结了与Agent协作的方法论:明确需求、把握节奏、沉淀Skill让AI顺应个人习惯。
在AI视频生成领域,长视频的一致性与连贯性一直是核心难题。B站UP主通过一期详尽的实战视频,展示了如何借助Agent(AI智能体)从零开始,理解并改造ComfyUI中的长视频衔接技术,最终打造出符合个人工作习惯的自定义节点。整个过程不仅是技术解析,更是一次“与AI协作”的方法论演示。
长视频衔接的核心:22帧Latent的巧妙复用
视频开篇,UP主展示了令人惊艳的效果:两段视频无缝衔接,色调、空间一致且无明显劣化,人物的动作动态得以完美继承。其原理并不复杂——将上一段视频末尾的22帧Latent截取出来,直接作为下一段视频采样的参考条件输入,并强制这22帧1:1出现在新视频的前22帧。生成多段后,只需去掉重叠的22帧,即可实现完美衔接。UP主坦言,所谓“上下文”技术本质就是潜空间Latent的阶段传递,并非高深魔法。
这一机制的关键在于,它绕过了传统“尾帧衔接”的痛点。传统方法仅用一帧图片作为下一段的起始帧,模型无法继承上一段视频结尾的动势,且因参考条件需经过R2V节点转换为Latent,色彩和画质会不可避免地被污染,导致视频逐段劣化,出现“咯噔一下”的断裂感。而22帧连续Latent直接输入,省去了转换过程,从根本上解决了偏色和动态丢失问题。
Latent(潜空间表示) 是扩散模型在内部工作时使用的压缩数据形式。以Stable Diffusion为代表的模型并不直接在像素空间生成图像或视频,而是先通过VAE(变分自编码器)将画面编码为低维的潜空间张量,扩散与去噪过程均在此潜空间中完成,最后再解码回像素空间。由于潜空间的维度远低于像素空间,计算量大幅降低,同时保留了画面的语义与运动信息。所谓“22帧Latent”,指的就是连续22帧画面经编码后得到的潜空间序列,它天然携带了帧与帧之间的运动状态和时序关系。正因为直接复用这段Latent作为条件输入,模型才能继承上一段视频结尾的动势,而不像单帧图像那样丢失动态信息。理解潜空间这一中间表示,是理解整套长视频衔接方案的前提。
R2V(Reference-to-Video)节点 是ComfyUI工作流中用于将参考图像或参考帧转换为视频生成条件的组件。它的作用是把外部传入的参考素材编码成模型可接受的Latent条件,再送入采样器。问题在于,参考图需先经过编码转换,这一过程会引入色彩偏移与画质损失;当长视频逐段衔接时,每一段都要经过一次这样的转换,误差便逐段累积,最终表现为色调漂移和“咯噔一下”的断裂感。而22帧Latent方案让连续潜空间直接绕过R2V的编码环节输入采样器,从源头避免了反复转换带来的劣化,这也是它与传统尾帧衔接在工程实现上的根本差异。
从“小白”到自建节点:Agent如何拆解复杂工作流
UP主最初对长视频技术望而却步,因为网上分享的工作流节点密密麻麻,学习成本极高。直到看到一位UP主用该技术制作的机甲爬楼第一视角长镜头,才决心攻克。他下载了C站(Civitai)上国外作者的工作流,但发现其设计逻辑与自己的习惯严重不符——国外作者仍保留首尾帧思维,节点参数繁多,且缺乏详细教程。
于是,他转向Agent,将工作流页面丢给AI,要求其解读核心技术,并提取关键部分适配到自己的流程中。Agent快速阅读网页后,梳理出实现逻辑,并帮助扫描本地缺失的插件和模型,自动从GitHub和Hugging Face下载(UP主强调“魔法”上网的必要性)。过程中,Agent也暴露出“自作聪明”的问题:例如,UP主只要求做一个带截取帧数选项的小节点,Agent却生成了三个节点,其中一个逻辑混乱,浪费了大量调试时间。这引出了与Agent协作的关键原则——用户必须明确需求、把握节奏,并懂得验收。
最终,UP主在Agent辅助下,成功在R2V参考条件接口上增加了一个Latent输入接口,并加入截取帧数下拉选项(默认22帧,可选73帧等),自动对齐音频与视频。核心节点被精简为两个:参考条件处理和采样输出,其余冗余节点被删除。
显存优化与分段策略:进阶玩法的关键
UP主特别指出,22帧Latent方案虽好,但并非万能。由于每段视频需携带上一段的Latent作为参考,显存占用会随段数增加而上升,因此每段时长必然短于独立生成。他建议将单段时长缩短,但拉高分辨率(如从1.4倍提升至1.6甚至2.0倍),以画质换时长,这对小显存用户尤为友好。
此外,他质疑22帧(不足一秒)能否充分理解上一段视频内容。Agent解释称,这22帧是连续不抽帧的,能继承运动状态。但UP主在测试中仍选择73帧(约3秒)以获取更充分的上下文,尽管16G显卡可能吃力。他强调,真正的进阶玩法是分段控制:每一段的参考条件、采样步数、时长都应根据实际生成效果动态调整,而非像原作者那样一次性锁死所有参数。“你生成四段视频可能是四段全错,这玩意就像一颗老鼠屎坏了一锅粥。”他提醒,H3模型存在空间错误和抽卡劣化,必须通过分段抽卡、逐段修正来保证最终质量。
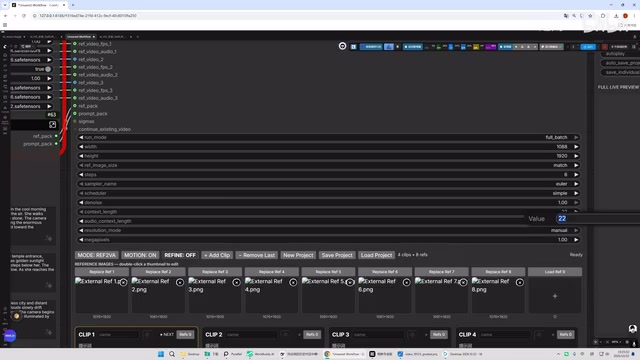
在节点优化中,UP主还解决了潜空间放大阶段的分块问题。原节点默认分块大小为32,在16G显卡上显存占用仍会飙至98%以上,导致显卡空转等待内存交换,速度反而变慢。他将分块参数扩展为24、16、8等选项,实测24能避开显存临界值,速度更快。他建议用户根据自身显存“往下探”,找到平衡点。
潜空间放大(Latent Upscale)与分块(Tiling) 是视频生成中提升分辨率的常用手段:先在低分辨率下完成采样,再在潜空间中将结果放大并补充细节。但放大阶段需要同时处理整段视频的潜空间张量,显存占用极高。分块技术将画面切分为若干小块逐块处理,以时间换显存;分块越小,单次处理的张量越少,显存峰值越低,但块与块之间的接缝处理和调度开销也越大。原文中把分块从默认32调为24,正是在16G显卡上找到了“显存不溢出”与“处理速度可接受”之间的平衡点——块太大显存爆满导致显卡空转等待内存交换,块太小则调度频繁拖慢速度。用户应结合自身显存向下试探,找到自己的临界值。
与Agent对话的艺术:沉淀Skill,让AI顺应你的习惯
UP主使用的Agent包括DeepSeek广告 V4.1(免费/低价)、WorkBuild以及本地小模型(如1825B Flashnex)。他吐槽DeepSeek写提示词“非常垃圾”,生成的古装女刺客穿越校园追杀剧情毫无润色,甚至出现“御空飞行”这种漂浮动作,完全无法用于测试衔接效果。但在节点设计和代码理解上,DeepSeek表现优异。
他总结出一套与Agent协作的方法:每次任务后,让Agent将本次的思考约束、验证方法总结成“Skill”,作为后续对话的强制规则,避免重复犯错。随着Skill增多,还需定期整合,防止拖慢速度。“你每一次做这种任务都总结一下这些skill,去辩证他的想法,让他顺应你的思路和习惯,慢慢的他就像烙印一样烙在他身体里面。”
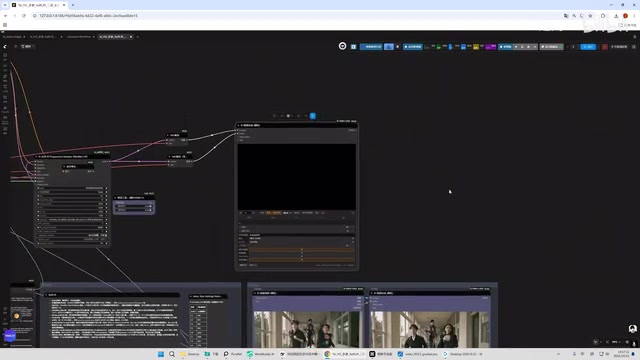
最后,UP主展示了自己优化的保存节点,加入“删除前N帧”选项(默认不删减),与截取帧数对应,方便后期合成。整个工作流已能实现两段视频的生成与拼接,后续他将进一步简化流程,并制作专门写提示词的Skill,以及探索多段视频同时管理的节点。
这期视频的价值不仅在于一项长视频技术的落地,更在于示范了“普通人+Agent”如何拆解黑盒、定制工具。正如UP主所言:“最难的技术已经被核心项目的作者解决了,你要做的就是理解原理,然后让AI帮你适配自己的习惯。”
Skill(技能沉淀) 在这里指一种面向AI智能体的上下文工程实践:把某次任务中验证有效的约束条件、思考步骤、验收标准固化为可复用的文本规则,在后续对话中作为系统提示或强制指令加载。其价值在于对抗大语言模型的“上下文遗忘”与“重复犯错”——模型本身没有跨会话的持久记忆,若不显式沉淀,同类错误会在每次新任务中重演。随着Skill条目增多,提示词会变长、推理变慢,因此需要定期整合去重,保留高价值规则。这种做法本质上是用人工维护的规则库弥补模型记忆的缺失,让AI的输出逐步贴合使用者的个人习惯与工作流,而非每次从零磨合。
相关推荐

大厂AI工程化面试:前端监控到Agent全链路可观测性
从PerformanceObserver采集性能指标、onerror与unhandledrejection捕获异常,到RAG链路重排优化、上下文压缩控制token成本,再到对标LangSmith与Sentry的全站AI全链路可观测性体系设计,拆解大厂AI工程化面试的三层递进考点。

WorkBuddy保姆级教程:手把手搭建专属AI Agent工作助理
WorkBuddy保姆级教程:从豆包等聊天模型的局限讲起,手把手教你搭建专属AI Agent工作助理,实现本地文件批量处理与自动化操作,非程序员也能轻松上手。

Windows下用LangChain-Chatchat+DeepSeek搭建本地知识库
本文整理B站教程,详解Windows下用LangChain-Chatchat与DeepSeek搭建本地知识库的全流程,包括Anaconda环境配置、Ollama模型管理、镜像源加速及常见报错解决,助你快速实现RAG问答。