Agentic AI的双手:函数调用与工具契约详解
工具是Agent的手,清晰的工具契约决定它能否准确行动。
文章指出,Agentic AI 的核心分水岭是工具使用能力:模型本身不执行工具,而是返回结构化的工具名与参数,由代码执行后回传观察结果形成闭环。工具契约包含名称、描述、输入、输出和失败模式五部分,其中描述比代码更影响模型选择工具。调用必须遵循 schema,将模糊猜测转化为可靠行动。文章还澄清了函数调用与代码执行的区别:前者请求单一答案,后者真正运行动态代码。最后以“查日历却搜邮件”的案例说明,Agent 选错工具的根本原因通常是工具描述不清晰,修复应从契约入手。
从聊天到行动:工具是Agent的手
一个只会说话的Agent,不过是有自信的聊天机器人。给它工具,它才能真正行动。这句来自AvaSkill Academy课程的精辟比喻,点出了Agentic AI的核心分水岭——工具使用能力。
Function calling(函数调用)正是模型请求使用工具的机制。关键在于,模型并不会亲自执行工具,而是返回一个结构化调用:工具名称加上所需参数。你的代码负责运行工具,再把结果作为观察(observation)传回模型,形成闭环。这个循环在课程第一课中已经建立,如今只是赋予了它"双手"。
Function calling(函数调用) 是当前主流大语言模型(如 OpenAI 的 GPT-4、Anthropic 的 Claude、Google 的 Gemini)提供的一种结构化输出能力。模型在生成回复时,可以选择不直接输出自然语言,而是输出一段符合特定 schema 的 JSON,声明它想调用哪个函数、传入什么参数。平台或开发者负责解析这段 JSON 并实际执行函数,再将结果以特定角色(如 tool/function 角色)送回模型上下文。它的核心价值在于把模型的“意图”与“执行”解耦:模型负责理解和决策,代码负责安全、可控地执行。这也使得多轮工具调用、并行调用、错误重试等工程模式成为可能,是构建 Agent 的基础设施。
契约先行:每个工具都需要一份合同
课程反复强调一个核心原则:工具描述比代码本身更重要。模型选择工具时,读的是描述而非内部实现。描述模糊,就会选错工具——这解释了为什么你让它查日历,它却去搜了邮件。
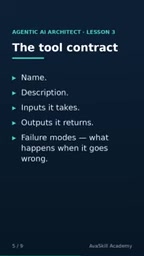
一个完整的工具契约包含五个部分:名称、描述、输入参数、输出结果、以及失败模式(出错时会发生什么)。这五要素构成了工具与模型之间的信任基础。
调用还必须遵循schema——一个固定形状,声明哪些参数存在、每个参数是什么类型、哪些是必填项。清晰的schema把猜测变成可靠行动。模型同样可以返回结构化输出,让你的代码能够信任并使用固定形状的结果。
Schema 在此语境下通常指 JSON Schema,一种用于描述和校验 JSON 数据结构的标准。在工具调用中,schema 声明了参数名称、类型(string、number、boolean、array、object 等)、是否必填、枚举取值范围、默认值以及嵌套结构。模型会依据 schema 生成合规的调用参数,平台也可在运行时校验参数合法性,提前拦截格式错误。清晰的 schema 不仅降低模型“猜”的成本,还能让错误信息更精准地反馈给模型进行自我修正。对于复杂工具,建议使用嵌套 object 和 description 字段进一步约束语义,避免模型产生歧义。
函数调用 vs 代码执行:同手不同握法
课程特别澄清了一个常见混淆:tool use不等于code execution。
函数调用请求的是单一答案,工具本质上是无名的、带结构化参数的接口;而代码执行则真正运行代码——例如通过API进行计算、抓取或修改操作。原文用的比喻很形象:同样是手,握法不同。
理解这一区别,才能在设计Agent时选对架构。需要确定性答案时用函数调用,需要动态计算或复杂操作时用代码执行。
Code execution(代码执行) 在 Agent 场景中通常指模型生成一段可执行代码(如 Python、JavaScript),由沙箱环境实际运行并返回输出。与函数调用相比,代码执行赋予模型更强的表达力和灵活性:模型可以编写循环、条件判断、调用第三方库、处理文件或发起网络请求。但代价是安全风险显著上升,因此需要隔离沙箱、资源限制和权限控制。函数调用更适合边界清晰、参数固定的原子操作;代码执行适合需要动态逻辑、复杂计算或批量处理的场景。二者可以组合使用,例如用函数调用触发一个代码执行工具,再由模型根据返回结果决定下一步。
一个案例:为什么Agent选错了工具
课程给出的测验场景极具代表性:你让Agent查日历,它却搜索了邮件。选项中的正确答案是——工具描述不够清晰。
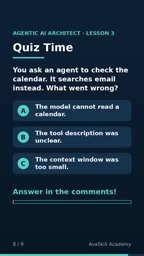
日历工具一直都在,问题出在契约。修复方法很直接:给工具一个清晰的名字、明确说明它做什么的描述、列出输入输出、以及定义失败模式。
这也印证了课程的核心论断:工具是手,契约是握法。写契约在先,Agent才能选得更准。如果你的Agent总是"拿错工具",先检查描述,而不是怀疑模型能力。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。