Agent技能路由怎么选?检索、大模型与两段式架构对比
Agent技能路由的核心是按规模权衡:小规模直接用模型,大规模用检索粗筛加模型精选的两段式架构。
本文拆解了Agent技能路由的工程选型逻辑。将所有技能描述直接塞给大模型虽然准确,但在技能规模扩大后会导致token成本爆炸和延迟飙升;纯向量检索虽然快且便宜,却缺乏推理能力,难以处理语义跳转类意图。工业界的主流方案是两段式路由:先用向量检索做低成本粗筛,快速圈出Top-K候选技能保证召回率;再将候选集送入大模型做精选,用推理能力弥补检索的语义鸿沟。落地时需重点关注四个细节:召回余量要留足、技能描述质量是根本、线上监控需能区分漏召与误判、小规模场景无需引入两段式过度设计。
搭建 Agent 时,一个绕不开的工程决策是:当技能数量越来越多,用户请求进来后到底该让大模型自己挑选合适的技能,还是先用检索做匹配?这个问题看似简单,实则是准确率、延迟与成本三者之间的权衡博弈。本文基于 B 站 UP 主的一次面试题拆解,梳理清楚三种路由策略的差异及工业界的主流做法。
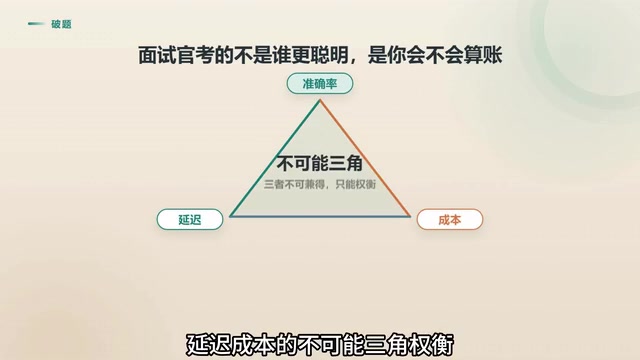
路由选型的本质:一个不可能三角
面试中被问到「技能多了该用检索还是让模型选」,很多人会脱口而出「当然让模型选,它智商最高」。但这个答案经不起追问——如果有几百个技能,把所有描述都塞进 prompt,token 成本和响应延迟怎么扛?
这道题考的不是谁更聪明,而是你会不会算账。技能路由本质上是准确率、延迟、成本的不可能三角。一个合格的回答,必须体现出你能根据技能规模的大小,动态选择最合适的路由架构,而不是抱着某一种方案走到黑。
两个极端方案为什么都行不通
无脑信任大模型
第一种做法是把所有候选技能的描述一股脑扔进上下文,靠 LLM 的推理能力去挑。好处很明显:准。大模型能理解复杂意图,处理模糊需求。
但坏处是致命的。Agent 的设计原则叫「渐进式披露」(progressive disclosure),核心目的就是省 token。一旦技能上百,光描述就能吃掉几万 token。每次请求都带着这么一大坨信息过一遍大模型推理,不仅贵,延迟更是从百毫秒级飙到秒级。这不是模型笨不笨的问题,而是工程上根本算不过来这笔账。
「渐进式披露」(Progressive Disclosure)原本是 UX 设计领域的概念,指界面只在必要时才向用户展示更多信息,以降低认知负担。在 Agent 工程中,这一思想被借鉴为:不在初始 prompt 中一次性注入所有可用技能的完整描述,而是按需、按阶段地引入相关上下文。其核心驱动力是 LLM 的计费单位——token。以 GPT-4o 为例,输入 token 的成本约为每百万 token 若干美元,一个技能描述平均 100 token,500 个技能就需要 50,000 token,仅这一项每次调用的成本就可能超过实际推理本身。更棘手的是,主流模型存在「迷失在中间」(Lost in the Middle)现象:当上下文过长时,模型对处于中间位置的信息关注度显著下降,导致即便技能描述都在 prompt 里,命中率也未必线性增长。
完全依赖检索
第二种做法是把技能描述向量化,用户请求进来先做相似度匹配。好处是极快极便宜,纯数学计算,毫秒级响应。
但它的上限也很明显:只看字面语义像不像。如果用户换了个说法,或者需求需要逻辑推理才能关联到某个技能,向量检索大概率会漏掉或选错。用视频里的比喻——它没有脑子,只有记忆。
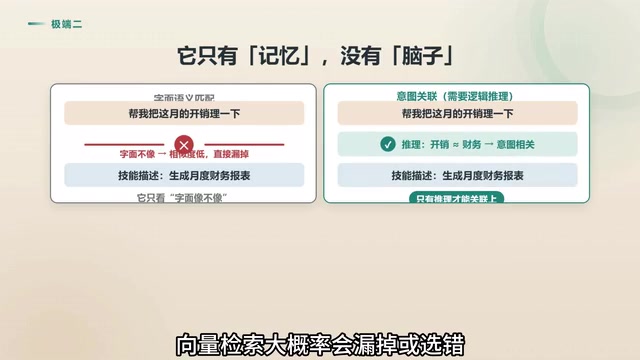
向量检索的工作原理是将文本通过 Embedding 模型映射为高维向量,再用余弦相似度或点积等距离度量找出最近邻。这一过程对「字面语义相近」的匹配效果极佳,但对需要逻辑跳转的意图识别则力不从心。例如用户说「我的订单还没到」,向量层可能把它匹配到「物流查询」技能;但若用户说「东西寄丢了我要退款」,背后涉及物流异常判责与退款流程两个技能的联动,单纯的语义距离很难将其精准定向到「理赔申请」技能。此外,Embedding 模型本身存在领域偏差——通用模型对业务黑话、缩写词的表征质量参差不齐,在垂直行业场景下往往需要领域微调或混合稀疏检索(如 BM25 + Dense Retrieval 的 Hybrid Search)来弥补语义盲区。
主流答案:粗筛加精选的两段式路由
工业界处理大规模 Agent 技能的主流范式,可以浓缩成六个字:粗筛加精选。
第一段:检索做粗筛
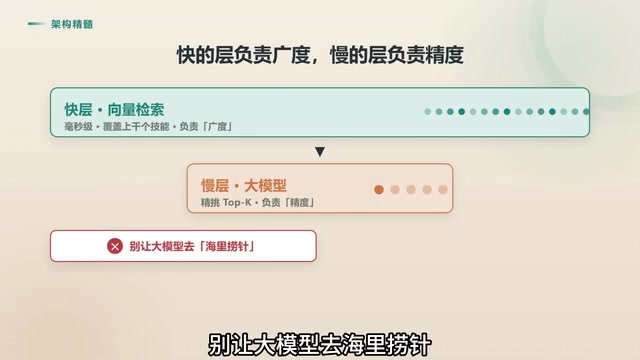
面对几百上千个技能,先用低成本的向量检索快速圈出 Top-K 最相关的候选集。这一步不负责「选对」,只负责「别漏」,保证正确答案落在这个小池子里。它的核心价值是用极低的成本,把搜索空间从海量压缩到个位数。
Top-K 的 K 值选取是粗筛阶段最关键的超参数之一。K 太小会导致正确技能被截断在候选集之外,后续模型层无从挽救;K 太大则把更多无关技能送入精选层,增加 token 开销和误选概率。工业实践中通常通过离线评估来确定合理区间:在标注好「正确技能」的测试集上,统计不同 K 值下的召回率(Recall@K),找到召回率曲线趋于平缓的拐点作为候选值。除了固定 K,也有动态阈值方案——设定相似度分数下限,只保留得分超过阈值的结果,在技能语义高度相似的场景下能有效过滤噪声。此外,若业务存在明确的技能分类体系(如「支付类」「物流类」「售后类」),可在检索前先做一次轻量级意图分类,将搜索空间从全量技能缩小到某一类别,再执行向量检索,进一步提升粗筛的信噪比。
第二段:大模型做精选
把这几个候选技能的完整描述喂给大模型,让它结合上下文做最终决策。因为候选只剩几个,token 消耗可控,延迟也在可接受范围内。更重要的是,模型能用推理能力弥补检索的语义鸿沟,处理那些「字面不像但意图相关」的边缘 case。
一句话概括:快的层负责广度,慢的层负责精度。别让大模型去海里捞针,也别让检索去做阅读理解,让每一层都干它最擅长的事。
落地时必须提前踩的四个坑
原理讲清楚了,面试官(以及真实工程场景)一定会追问落地细节。以下四点是绕不开的:
召回余量要留足。 粗筛阶段宁可多召回几个让模型去淘汰,也绝不能为了省 token 把正确选项漏在外面。检索层一旦漏了,后面模型再审也救不回来。这个 K 值怎么定,要靠离线评估数据说话,不能拍脑袋。
技能描述质量是根子。 向量检索的效果,根子上取决于每个技能的 description 写得是否清晰、区分度是否够高。描述含糊不清,向量空间里就会挤在一起,神仙难救。所以优化路由的第一步,往往是回去重写技能描述。
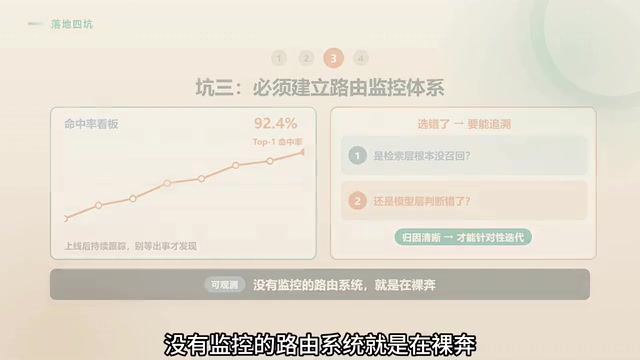
建立路由监控体系。 上线后要有命中率看板,选错了要能追溯到底是检索层没召回,还是模型层判错了。只有归因清晰,才能针对性迭代。没有监控的路由系统,就是在裸奔。
拒绝过度设计。 如果你的 Agent 总共就十几个技能,别搞什么两段式,直接让模型判断反而最简单最准。两段式是给大规模场景准备的重武器,选架构不看规模,就是耍流氓。
可直接复用的回答框架
把上面的思路整理成一段完整表述:
技能路由不是二选一,而是基于规模的权衡。小规模直接用模型判断,兼顾准确与简洁;大规模则采用两段式架构,检索做低成本粗筛保证召回,模型做高精度精选保证准确。同时我会重点关注描述质量、召回余量和线上监控,确保路由系统的可观测和可迭代。
这样回答,既有理论高度,又有工程细节,还体现了务实的态度。
结语
大模型相关的技术选型,难点从来不是知识点本身,而是能不能把知识转化成解决问题的思维。Agent 路由如此,RAG 优化、MCP 协议、多智能体协作这些场景背后,也都是类似的工程权衡逻辑——先算账,再选型,用规模决定架构复杂度。
背景补充
路由监控在架构上通常分为两层埋点:检索层记录每次请求的 Top-K 命中列表及相似度分数,精选层记录模型最终选择的技能 ID 与置信度。将两层日志关联后,可以区分出三类失败模式:①检索漏召(正确技能未进入 Top-K)、②模型误判(正确技能在候选集内但被排除)、③技能本身缺失(需求无对应技能)。三类原因的修复路径完全不同——漏召对应调整 K 值或优化 Embedding;误判对应改写 prompt 或补充 few-shot 示例;技能缺失则要反馈给产品侧补充能力。在可观测性工具选型上,LangSmith、Phoenix(Arize)等 LLM 专用可观测平台已原生支持链路追踪,能将检索与生成两个阶段的 span 自动关联,降低手动埋点的工作量。
相关推荐
月费20美元vs年费百万:Cursor与Blitzy的本质差异
Cursor月费20美元,Blitzy年费高达500万美元,两款AI编程工具的本质差异在哪?通过三百万行代码的Grafana实测,揭示小型编程智能体与企业级智能体在上下文处理、工作单元和交付完成度上的根本区别。
Factoriax:GPU并行化的工厂类强化学习研究环境
Factoriax 是一个受《异星工厂》启发、GPU 并行化的强化学习研究环境,专注于长程规划与高吞吐样本采集,为 RL 算法提供复杂的工厂建造仿真测试床。
Claude推出Docs与Slides,正面挑战谷歌Gemini
Anthropic为Claude推出Docs与Slides两款新工具,支持在对话中生成、导出并共享文档和演示文稿,同时将聊天与Cowork合并为「一个Claude」,正面对标谷歌Gemini的办公生产力生态。