AgentScope 2.0框架深度解析:多智能体开发核心能力全拆解
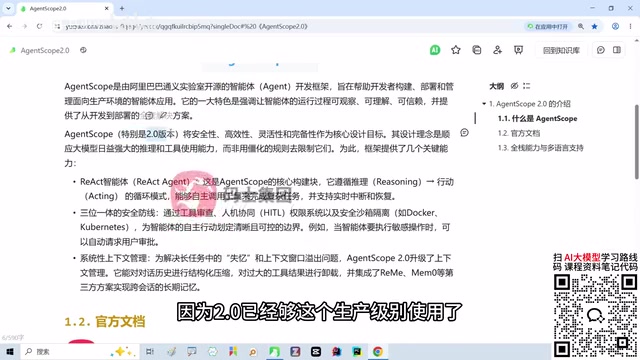
AgentScope 2.0是面向生产的Agent开发框架,以ReAct循环、三层安全防线和上下文管理为核心。
AgentScope是阿里开源的智能体开发框架,2.0版本相较1.0进行了架构级重构,适合直接上手学习。框架以ReAct(推理+行动循环)为核心Agent构建范式,让Agent能够在复杂任务中反复思考、调用工具、观察结果并持续推进。针对高权限Agent带来的安全风险,AgentScope构建了三维一体安全防线:工具审查控制「能否调用」,人机协同在关键动作上引入人工审批,沙箱隔离限制代码执行的爆炸半径。此外,框架还提供系统性上下文管理,应对Agent长时间运行导致的上下文膨胀与信息淹没问题。框架同时支持Python和Java两个版本,定位于生产级多智能体应用的工程化开发。
AgentScope到底是什么
在AI应用开发日益复杂的今天,智能体(Agent)已经不再是简单的聊天机器人。普通聊天机器人的职责就是回答问题——你问它答,仅此而已。但Agent的能力边界要大得多:它能自主思考、调用工具、执行任务。
举个典型场景:你给Agent下达一个任务——「帮我分析今天的销售数据,生成报告,然后以邮件形式发给公司经理」。这时Agent会自行读取销售数据、调用Python分析功能、生成报告,最后调用邮件工具把结果发出去。整个链条涉及多次工具调用和任务编排。
问题也随之而来:当Agent能做的事情越来越多,我们该怎么开发它、控制它?怎么保证它不「乱来」?出问题时又该如何定位是哪一步出了错?正是这些工程化需求,催生了一批智能体开发框架,AgentScope就是其中之一。
简单来说,AgentScope是一个帮助开发者对Agent进行构建、部署、管理、运行的开发框架,核心价值就是「管理Agent」。
为什么直接学2.0版本
AgentScope的1.0版本此前已经推出,但2.0相较1.0改动极大——大量API被弃用,架构层面几乎是「毁灭级」的重构。对学过1.0的人来说,很多知识确实有点「白学」的感觉。因此当下学习没必要从1.0起步,2.0已经足够生产级别使用,直接上手2.0即可。
核心能力一:ReAct智能体
这里的ReAct并不是前端的那个React框架,而是**Reasoning(推理)+ Action(行动)**两个单词首字母的组合,代表一种「边思考、边行动」的循环模式。
设想一个场景:你告诉Agent「帮我查一下北京今天的天气,如果下雨就提醒我带伞」。大模型本身并不知道北京今天下不下雨,于是Agent会先思考——要完成这个任务,得先查天气;然后付诸行动,调用天气工具;工具返回「北京有雨」后,Agent再次思考——有雨就该提醒带伞;最后把结论返回给用户。
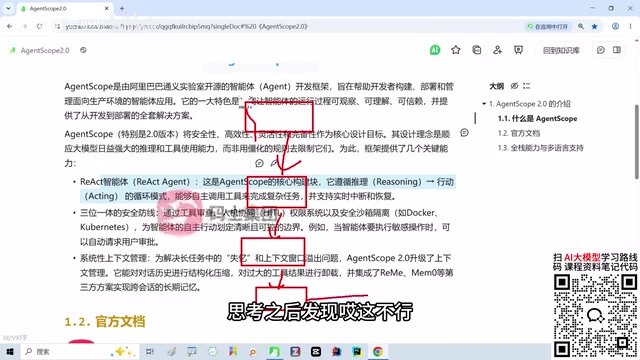
这个「思考—行动—观察结果—再思考」的循环并非只执行一次。面对复杂任务,Agent可能反复循环:思考后调用工具,观察结果后发现需要读网页,读完再执行一段Python分析数据,如此层层推进,直到任务完成才返回最终结果。
AgentScope把ReAct作为核心的Agent构建方式,并围绕它提供工具调用、流式运行、中断恢复等能力,使其能更好地应对复杂任务场景。
ReAct模式最早由谷歌和普林斯顿大学在2022年的论文《ReAct: Synergizing Reasoning and Acting in Language Models》中提出。研究者发现,单纯让大模型「思考」(如Chain-of-Thought推理)容易产生幻觉,而单纯让模型「行动」(直接调用工具)又缺乏灵活的推理能力。ReAct将两者结合:模型在每一步既输出思考过程(Thought),又决定下一步动作(Action),再观察工具返回的结果(Observation),如此循环直至任务完成。这种设计让模型的推理链条可追溯、可调试,也让开发者能清晰看到Agent「为什么」做出某个决策,而不是面对一个不透明的黑盒。在实际工程中,ReAct已成为主流Agent框架的标配范式,LangChain、AutoGen等框架均有对应实现。
核心能力二:三维一体的安全防线
当Agent只是回答天气时,安全问题并不严重。但一旦Agent拥有了删除文件、执行代码、运行Shell、操作数据库、发送邮件、调用公司内部系统等高权限能力时,你还敢让它完全自主运行吗?
Agent的判断总有出错概率。假如你让它「清理项目里的无用文件」,它误判某个文件无用,直接执行了rm -rf,一次错误就可能对生产环境造成致命影响。AgentScope的安全思路正是为此设计,由三层机制构成:
工具审查
并非所有工具都能让Agent随意调用。当Agent准备调用敏感工具时,框架会进行检查。普通的查天气工具可以直接放行;但涉及删除数据库内容之类的操作,就需要进一步审查把关。
人机协同
Agent可以自主干活,但关键步骤由人说了算。比如Agent思考后打算执行DELETE FROM这类操作,框架会暂缓执行,交给管理员批准或拒绝。批准则继续,拒绝则停止或调整。这种机制不是禁止Agent自主决策,而是在高风险动作上把最终解释权留给人类。
安全沙箱隔离
即便人机协同环节审批出错、Agent决策本身有问题,也不能让它在主机上随意运行代码。沙箱为Agent准备了一个隔离空间,让它在其中执行代码、处理文件,尽量不影响外部系统。这一机制在许多主流框架中都有类似实现。
三层机制可以联合使用应对复杂场景:工具审查解决「能不能做」,人机协同解决「让不让做」,沙箱隔离解决「在哪里安全地做」。三者构成完整的三维一体安全防线。
沙箱(Sandbox)隔离是一种将程序运行环境与宿主系统物理或逻辑隔离的技术,常见实现手段包括Docker容器、虚拟机、进程级隔离(如seccomp、namespaces)等。在Agent场景中,沙箱的核心价值在于「爆炸半径控制」——即便Agent执行了危险代码,破坏范围也被限制在沙箱内部,不会蔓延到生产数据库或宿主文件系统。以Docker为例,Agent在容器内执行rm -rf /只会清空容器自身,宿主机毫发无损。沙箱同时也限制了网络访问、系统调用权限等,防止Agent被恶意提示词注入后对外发起攻击。代价是一定的性能开销和环境配置复杂度,因此在低风险工具上通常不启用沙箱,按需分级应用是更常见的工程实践。
核心能力三:系统性上下文管理
再看一个实际问题:某个Agent已经连续工作两小时,中间搜索了20个网页、调用工具30次、读取了几十个文件。每次工具调用返回的内容动辄数千上万字,这些信息不断累积,上下文会越来越庞大。
而大模型的上下文窗口并非无限。当上下文过度膨胀,很多重要信息会被「淹没」,直接影响Agent的判断质量。因此AgentScope也需要做系统性的上下文管理,通过多种手段控制和优化上下文,这部分内容在后续课程中会展开。
大模型的上下文窗口(Context Window)指模型单次能处理的最大token数量。以GPT-4为例,早期版本上下文窗口约为8K token,后续扩展到128K甚至更大,但窗口越大并不意味着模型对所有内容都同等关注——研究表明,模型对上下文头部和尾部的信息更敏感,中间部分容易被「遗忘」,这一现象被称为「Lost in the Middle」问题。在长时间运行的Agent场景中,常见的上下文管理策略包括:滑动窗口(丢弃最早的历史消息)、摘要压缩(将历史对话压缩成摘要后保留)、向量检索(将历史信息存入向量数据库,按需召回相关片段)等。不同策略在信息保留完整性与token效率之间各有取舍,AgentScope的系统性管理正是在这一复杂权衡中提供结构化解决方案。
面向生产的工程化能力
把这几点串起来看,逻辑就清晰了:当Agent能力越来越强、能自主完成复杂任务时,随之而来的是自主性带来的安全风险,以及长上下文引发的种种问题。AgentScope正是围绕这些痛点,提供一套完整的Agent工程化能力,把面向生产环境的智能应用开发框架准备好。
值得一提的是,AgentScope同时提供Python版本和Java版本两套框架,官方文档也支持中英文切换。当前主流的学习路径以Python版本为主,Java开发者可以沿着对应的官方文档进行自学。对于自学能力强的开发者,官方文档是很好的扩展资源。
总体而言,AgentScope 2.0以ReAct智能体为核心构建方式,配合三维一体安全防线和系统性上下文管理,形成了一套适合生产级多智能体开发的工程化方案。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。