AI Agent到底是什么?一文讲透与传统AI的核心区别
本文系统拆解AI Agent的定义、六大组件、与传统AI的本质差异及工程落地要点。
本文以"函数 vs 执行者"的对比切入,清晰界定了AI Agent的本质:它不是新型模型结构,而是以大模型为大脑、外挂记忆与工具的系统形态,通过目标→感知→推理→行动→反馈的闭环来完成端到端任务。文章拆解了Agent的六大核心组件,并点明最关键的设计——"任务是否完成"由Agent自身动态判断,而非硬编码逻辑。在此基础上,文章辨析了Agent与传统AI、Chatbot、Workflow的边界,强调动态决策权是唯一判定标准,并指出生产级Agent必须引入Human in the loop机制,同时警示目标飘移、无限循环、越权执行等高频工程风险。
从函数到执行者:Agent与传统模型的本质差异
要搞懂什么是AI Agent,最直接的办法就是把它和普通模型摆在一起对比。我们平时用的模型,本质上其实就是一个函数:你给一个输入,它就返回一个输出。分类器吐出一个标签,大模型吐出一段文本,仅此而已。它没有状态,不会主动干活,也不记事。
Agent完全是另一回事。它围绕一个明确的目标运转,会自己感知周围环境、思考下一步该干什么、调用工具去执行,再根据执行结果调整方向。这个过程会一直循环,直到把事情办完,或者发现实在办不下去时主动求助。用一句话概括:目标 + 感知 + 推理 + 行动 + 反馈闭环,这五个要素才构成一个Agent。
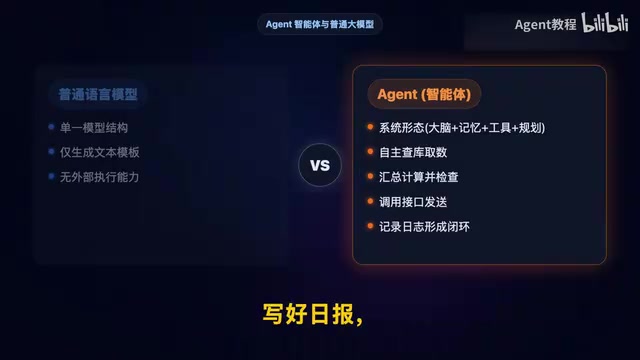
这里有个关键误区必须澄清:Agent并不是某种新结构的模型,而是一种系统形态。业界现在常说的Agent,默认是拿大模型当大脑,然后在外面外挂记忆、工具和规划这些模块。
用销售日报的例子看懂Agent的闭环
举个更直观的例子。假设你对系统说:"去整理一份本周销售日报发给主管。"
如果只是普通语言模型,它顶多给你生成一段写日报的文本模板。但如果是Agent,它会自己去查公司数据库、提取数据、汇总计算、写好日报,还会自己检查有没有异常数据,最后调用邮件接口发送出去,顺便给自己留一笔执行日志。
从接到目标到完成这一连串动作的整个闭环,就是Agent的本质所在。它不只是"生成内容",而是真正"把事情办成"。
Agent的六大核心组件与最小执行循环
一个完整的Agent通常有六个核心组件,缺一不可:
- 目标:接收并维护你要它干的事
- 感知:拿到外部输入,比如拼装上下文或拉取接口数据
- 推理与规划:最核心的"大脑",想清楚怎么做
- 记忆:记住跨步骤的状态,包括短期上下文和长期向量库记忆
- 行动与工具调用:真正去影响外部世界
- 反馈循环:评估结果并决定下一步目标
把这六个组件抽出来,就是一个经典的最小执行循环:Agent带着目标去感知上下文,做规划,选一个动作调用工具,拿到结果观察一下,然后问自己"这事干完了吗",如果没有就掉头回去继续循环。
重点来了:这套循环里最关键的是——"这事有没有干完"是由Agent自己判断的,而不是程序员在代码里写死的。这种动态的决策权,正是Agent区别于普通工作流的根本所在。
记忆模块值得单独展开说明。短期记忆通常就是大模型的上下文窗口(Context Window),也就是一次对话中所有消息的拼接;它容量有限,会随着对话轮次增加而不断被截断或压缩。长期记忆则依赖向量数据库(Vector Database),把历史信息编码成高维向量存起来,需要时通过相似度检索取回相关片段塞进提示词——这个过程通常被称为 RAG(检索增强生成,Retrieval-Augmented Generation)。两类记忆的协同设计直接决定了 Agent 能处理多长的任务链、能否跨会话保持状态,是工程实现中最容易踩坑的地方之一。
Agent与传统AI的核心区别
面试中常被追问:Agent跟传统AI有什么区别?
这里的传统AI一般指规则引擎、专家系统这类符号主义AI,或者做分类、回归、推荐排序、风控打分的传统机器学习。它们的共同点是任务边界极其清楚,输入输出固定,行为路径事先设计好。它们在单点能力上很强,比如识别人脸或计算转化率,但你让它自己拆解一个复杂目标去执行,它绝对做不到。
核心差异可以这样理解:传统AI是能力组件,Agent是任务执行者。
- 传统AI目标单一,输出标签、分数或文本,被动接收输入,出错时通常需要人工接管
- Agent目标开放,可被分解和迭代,控制流在运行时动态决定,不仅输出文本还输出动作、改变环境状态,调用工具是核心能力,遇到报错还能自己重试、反思或换策略
一句话:传统AI解决的是局部认知问题,而Agent要解决端到端的任务,把认知、决策和执行一条龙串起来。
几个高频追问:边界、Chatbot与Workflow
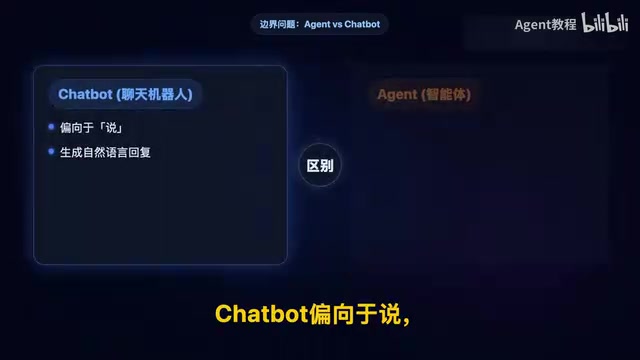
Agent和Chatbot有什么区别? 简单说,Chatbot偏向于"说",核心是生成自然语言回复;Agent偏向于"做",核心是把事情办成。当然,如果一个聊天机器人带了工具、记忆和任务闭环,它本身也就成了Agent。
Agent和Workflow工作流有什么区别? 判定标准只有一条:执行路径是不是在运行时决定的。工作流的路径事先写死,大模型只在某个固定节点干活;而Agent的下一步做什么,是系统根据当前观察自己决定的。所以哪怕你把多个大模型串成固定执行链,只要没有动态决策权,就不能叫Agent。
Agent一定要基于大语言模型吗? 广义上并不是,强化学习里的策略网络、机器人控制器都算Agent。但在当前大模型语境下,大家默认指的就是大模型做大脑的这种。面试时能点出这层语境差异,是个加分项。
Human in the loop:真实的落地形态
很多人以为Agent就是全自动无人执守,这也是误区。真正能在生产环境跑得动的Agent,一定有让人参与的机制,也就是常说的 Human in the loop。
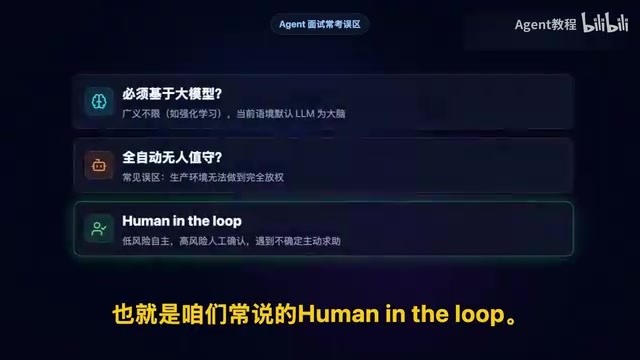
具体来说:低风险动作它自己跑,高风险动作要人来确认,遇到不确定情况主动求助——在合适的边界内自主,这才是Agent真实的落地形态。
至于"传统AI会被Agent替代吗",答案是不会。更常见的情况是传统AI被"包进去":OCR识别、推荐排序、风控打分这些垂直能力都会变成Agent手里的工具。Agent负责怎么把它们组合起来完成任务,传统AI负责把每个单点能力做到极致,二者是分层互补的关系。
工程落地的关键:安全边界与可观测性
面试官往往还会考察工程落地的思考:Agent最大的工程风险是什么?这时要抛出大厂最在意的关键词——安全边界和可观测性。
几个高频风险点值得警惕:大模型推理错误导致的目标飘移、乱用工具陷入无限循环把资源烧光、越权执行,甚至把敏感数据放进提示词导致隐私泄露。能力越强,底线就越要守得住。
最后,用三条标准快速判断一个系统是不是真正的Agent:
- 目标是不是开放的
- 路径是不是运行时动态决定的
- 有没有失败了能自己处理的反馈机制
三条都满足,那就是一个真正的AI Agent。
可观测性(Observability)在 Agent 工程中的含义,与传统微服务监控有所不同。Agent 的执行路径是运行时动态生成的,无法像固定流水线那样提前埋点,因此需要对每一步推理过程、工具调用入参/出参、Token 消耗、耗时及报错进行全链路追踪。业界目前常用的方案包括 LangSmith、LangFuse 等专为 LLM 应用设计的追踪平台,或自行在工具调用层注入结构化日志。没有可观测性,Agent 出错时几乎无从排查,也无法评估其行为是否符合预期,这是从原型走向生产最容易被忽视的一道坎。
相关推荐
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
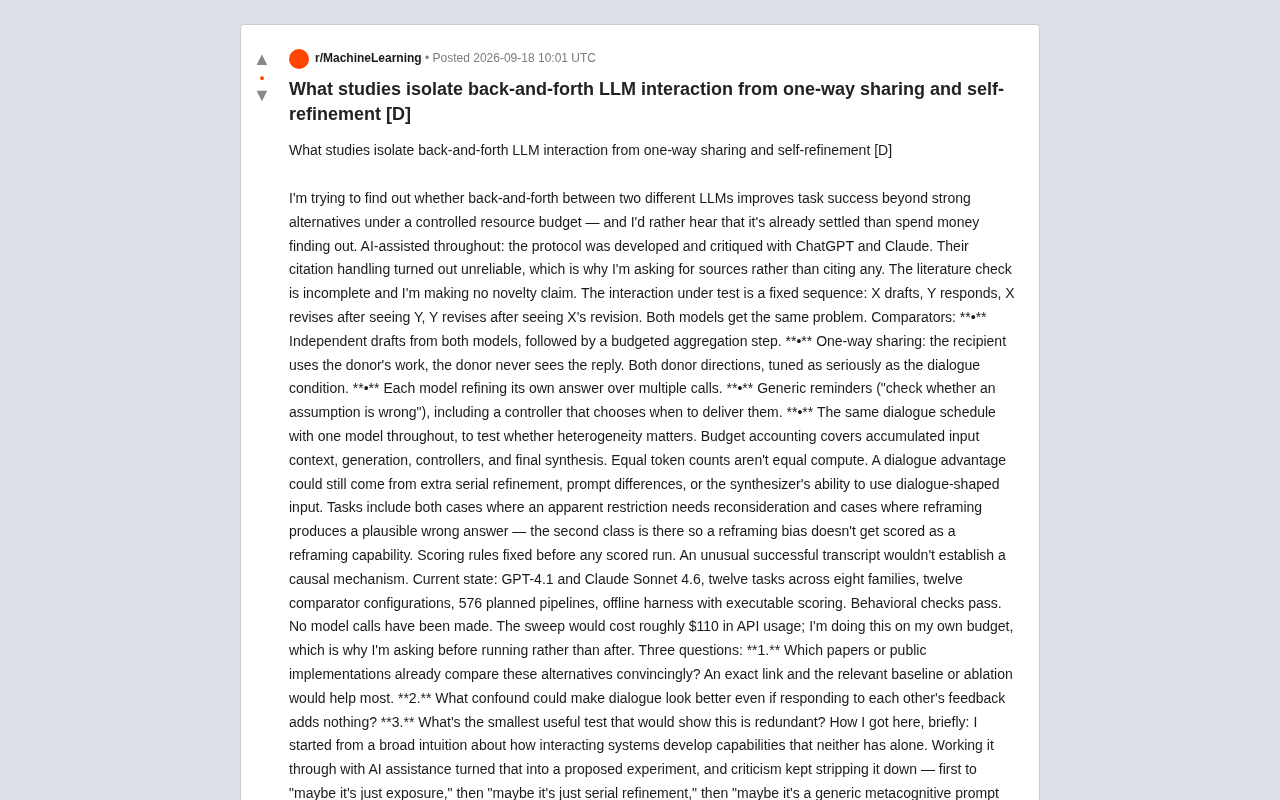
多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
一位研究者设计了一套严谨的对照实验,试图隔离多LLM来回对话与单向共享、自我精炼等机制的真实增益。本文解析其实验设计、预算核算与三个开放问题,为多智能体研究提供参考。