多LLM对话真能提升任务表现吗?一个严谨实验设计的启示
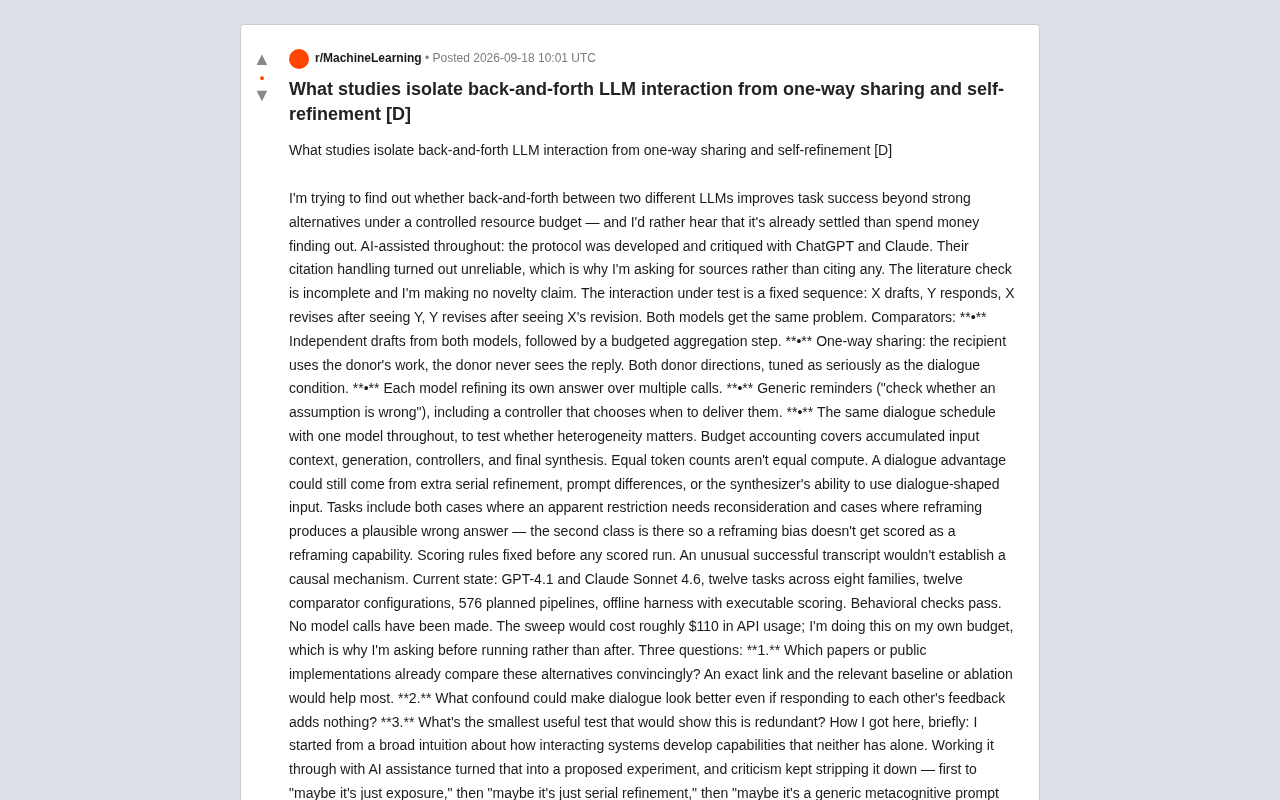
一位研究者在跑实验前设计了严格对照组,检验多LLM来回对话相比简单基线是否真有独立增益。
本文介绍了一位研究者在Reddit发起的讨论:在等算力预算下,两个不同LLM之间的来回交互是否真能超越独立起草、单向共享或自我精炼等更简单的方案?他精心设计了12种对照配置,刻意隔离"互动"与"信息聚合""串行精炼""元认知提示"等混淆因素,并强调等量token不等于等量计算这一常被忽视的评测漏洞。任务集同时包含需要重构才能答对和重构反而出错的题目,防止重构偏好被误记为能力。576条流水线已在离线框架中搭建完毕,但作者选择花钱运行前先向社区求证,展示了一种把假设逼到最窄可证伪边界的研究范式。
一个被批评打磨出来的实验问题
在AI研究领域,一个流传甚广的直觉是:让两个不同的大语言模型(LLM)来回对话、互相批判,能够产生单个模型无法独立达成的能力。这听起来很有吸引力,但它真的成立吗?
一位Reddit用户在机器学习板块发起讨论,试图厘清一个看似简单实则棘手的问题:在受控的资源预算下,两个不同LLM之间的来回交互(back-and-forth interaction),是否真能在任务成功率上超越其他强基线方案?
有意思的是,这个问题本身是在与ChatGPT和Claude的协作中不断被"剥离"出来的。作者坦言,AI助手的引用处理并不可靠,这也是他转而向社区求证真实文献来源的原因。整个提问过程展示了一种难得的科研自省——批评比构建更有价值。
核心:把"对话"从相似机制中隔离出来
这项讨论最有价值的地方,在于它精确定义了要检验的对象,并刻意与几种容易混淆的替代机制做隔离对比。
被测试的交互是一个固定序列:X起草 → Y回应 → X看到Y后修订 → Y看到X的修订后再修订。两个模型面对同一个问题。
为了证明"对话"本身有独立贡献,作者设计了多个对照组:
- 独立起草 + 预算内聚合:两个模型各自独立作答,再做一次聚合。
- 单向共享:接收方使用给予方的成果,但给予方永远看不到回复(且测试两个方向)。
- 自我精炼:每个模型在多次调用中反复打磨自己的答案。
- 通用提醒:注入"检查某个假设是否错误"这类元认知提示,甚至包括一个决定何时发送提醒的控制器。
- 同模型对话:用同一个模型走完整个对话流程,以检验"异质性"是否真的重要。
这种设计的精妙之处在于:如果对话优势其实只来自"额外的串行精炼"、"提示词差异"或"某个元认知提示恰好在对的时机出现",那么上述对照组就能把这些混淆因素分离出来。
这种"多智能体辩论"(Multi-Agent Debate,MAD)范式在2023年前后受到广泛关注。Du等人在论文《Improving Factuality and Reasoning in Language Models through Multiagent Debate》中展示了让多个模型互相批评能提升推理准确率,随后引发大量跟进研究。然而,多项后续工作发现其优势难以稳定复现。问题的根源在于,"让模型看到其他模型的输出"本质上是在输入中注入了额外信息,这与模型本身能否通过"互动"产生涌现能力是两回事。Irving等人关于AI安全辩论的早期工作以及Liang等人的后续研究都指出,增益往往来自信息聚合而非真正的协作推理。因此,隔离"来回交互"与"单次信息共享",正是厘清这一领域核心争议的关键一步。
预算核算:等量token不等于等量算力
作者特别强调了一个常被忽视的实验伦理问题:公平的比较必须核算全部算力开销,包括累积的输入上下文、生成、控制器和最终综合环节。
他一针见血地指出:"等量的token数并不等于等量的计算。"一个对话方案看起来更好,可能仅仅因为它消耗了更多的串行推理步骤,而非交互本身带来了增益。这正是许多"多智能体协作有效"结论站不住脚的地方——它们往往没有在等预算下与更简单的基线对比。
这一问题在大语言模型评估领域被称为"计算等价"(compute-matched)或"FLOP-matched"比较,是近年来评测规范化讨论的重要议题。串行推理链(如Chain-of-Thought)和多轮对话会显著增加输入上下文长度,而Transformer架构的注意力机制复杂度随序列长度平方级增长,导致实际算力消耗远超token数字面值。此外,API计费通常区分输入token与输出token,多轮对话中前几轮的输出会成为后续轮次的输入被重复计费,进一步放大了成本差异。在学术对比中,若忽略这些累积开销,将多轮协作方案与单次调用的简单基线做比较,几乎必然使协作方案显得更优,这是该领域文献中极为普遍却鲜少被指出的方法论漏洞。
任务设计防止"重构偏见"被误记为能力
任务集也经过精心设计。它同时包含两类问题:
- 表面上的限制需要被重新审视才能解答的问题;
- 重构反而会导出一个貌似合理却错误答案的问题。
第二类任务的存在,是为了防止模型的"重构偏好"(reframing bias)被错误地记为"重构能力"(reframing capability)。评分规则在任何正式运行前就已固定,避免事后调整带来的偏倚。
重构偏好(reframing bias)是指语言模型倾向于将问题转化为自己擅长的形式来作答,而非真正理解问题的约束条件。这一现象与"德克萨斯神枪手谬误"类似:模型先射击(输出重构后的解答),再画靶心(声称自己解决了原问题)。在多智能体对话场景中,如果评测任务全部是"需要打破表面限制才能解答"的题目,那么任何倾向于质疑假设的对话模式都会获得虚高分数,即便该模式在不应重构的场景下会犯错。通过同时纳入"重构有害"的任务,可以把真正的重构能力与系统性重构偏好在分数层面解耦,这是评测鲁棒性设计的重要范式。
目前的进展与三个开放问题
从技术状态看,作者已经搭建了相当完整的离线测试框架:
- 模型:GPT-4.1 与 Claude Sonnet 4.6
- 12个任务,横跨8个家族
- 12种对照配置,共计576条计划中的流水线
- 带可执行评分的离线测试台,行为检查已通过
- 尚未进行任何模型调用
整个扫描预计花费约110美元的API费用。由于是自费,作者选择在运行前先向社区求证,而非花钱之后才发现问题。他抛出三个问题:
- 哪些论文或公开实现已经令人信服地比较了这些替代方案?最好能给出精确链接和相关的基线或消融实验。
- 什么样的混淆因素可能让对话看起来更好,即便"相互回应反馈"实际上毫无增益?
- 能证明这项工作冗余的"最小有用测试"是什么?
对AI研究者的启示
这个帖子本身或许比它寻找的答案更有价值。它展示了一个值得借鉴的研究范式:在花钱跑实验之前,先把假设逼到最窄、最可证伪的边界。
从"交互系统能发展出独有能力"的宏大直觉,到"也许只是暴露更多信息",再到"也许只是串行精炼",最后到"也许只是元认知提示恰好来对时机"——层层批评把一个模糊的想法压缩成了一个可控实验。
对于关注多智能体系统、LLM协作与自我反思的研究者而言,这套对照设计提供了一个检验"协作增益"是否真实存在的模板。在多智能体框架大行其道的当下,能否在等预算下战胜简单基线,仍是一个远未被充分回答的问题。
相关推荐
OpenCode 入门到实战全攻略:AI编程工具安装与配置指南
OpenCode 是一款开源 AI 编程工具。本文梳理其入门到实战全流程:桌面端与 WSL 两种安装方式、模型与规则配置、Agent 分类、自定义命令工具、MCP 服务集成及 SQL 复用,助你系统上手 OpenCode。
10美元AI编程套餐怎么选?Go与Code额度对比拆解
DeepSeek涨价后,10美元AI编程套餐Go和Code怎么选?本文按Mimo、千问、DeepSeek V4、Kimi等常用模型逐一对比两家额度,揭示总额度背后的选购逻辑与请求次数口径陷阱。
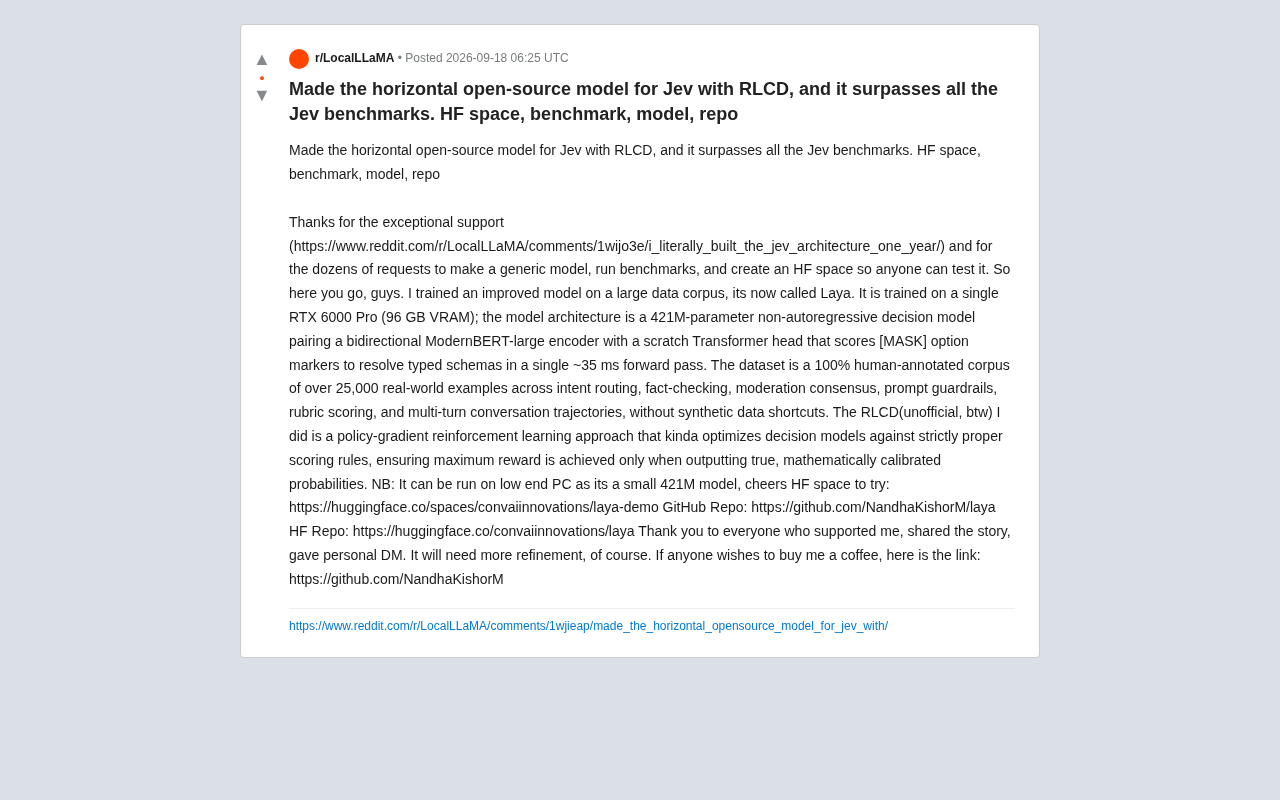
Laya开源决策模型:421M参数如何超越Jev基准测试
开源决策模型Laya基于Jev架构和RLCD强化学习训练,421M参数非自回归设计,可在低端PC运行,35毫秒完成推理,在多项Jev基准测试中实现超越,采用25000条纯人工标注数据。