AI Agent工程师进阶路线:从模型调用到落地实战
AI Agent工程师四步进阶路线:从稳定调用模型到工程化落地,助力转型求职。
本文整理自一位B站UP主的分享,核心观点是:当下企业招聘AI人才的重心已从「会训练模型」转向「能把大模型接入业务并稳定交付」,即Agent工程师能力。文章提炼出四步进阶路线:第一步掌握API调用与可控提示词输出;第二步通过检索、函数调用、代码执行三类工具让模型从「聊天」变为「做事」;第三步解决上下文管理、输出校验、日志权限等工程化问题;第四步用具体的项目成果而非模糊的「熟悉大模型」包装简历。文章末尾指出视频本质是课程推广,营销话术需理性对待,但技术路线本身具有参考价值,并建议处于焦虑状态的学习者优先跑通工具链、做出第一个可用版本。
为什么AI Agent成了当下最热的技术岗位
转型AI的人很多,但真正把薪资拉上去的往往做对了一件事——做出一个能跑、能用、能落地的Agent。这条路线之所以有价值,是因为企业的需求正在发生转变。
从这位B站UP主的分享中可以看出一个明显趋势:公司在面试中问「你会不会训练模型」的越来越少,问「你能不能把大模型接到业务里」的越来越多。能不能让模型自己调用工具、跑流程、做决策、出结果,并且稳定交付,才是当下Agent工程师岗位的核心考察点。
换句话说,市场需要的不是能背概念的人,而是能把大模型这个「玩具」变成生产力工具的人。这也是为什么Agent工程师的薪资水平相对可观,岗位窗口期被认为「拉满」。
别陷入「收藏教程焦虑症」
很多想转AI的人,每天做的事情是收藏一堆教程、刷一堆概念、看无数个「从入门到精通」,然后继续焦虑、继续拖延。UP主坦言自己一开始也是这个状态:今天学提示词,明天学LangChain,后天看RAG,学完感觉自己都懂了,真要做东西又什么都做不出来。
这是典型的「看懂」和「写出来」的鸿沟。看别人的代码看懂,和自己独立实现一个系统,是完全不同的两个概念。真正有效的学习方式是围绕一个完整的商业项目,一步步把它做出来。
特别要提醒的是,别一上来就立誓「我要从Python基础从零学起」。这条路线太慢,学三个月可能还在纠结语法,而Agent开发更需要的是工程化的实战思维。
Agent工程师的四步进阶路线
第一步:把大模型「能用」搞定
先别管框架和工程化,第一件事是能稳定调用一个模型,让它按你要求的格式输出结果。很多人卡在这一步,是因为反复纠结「用哪家模型最好」「参数怎么选」,其实先用一个能用的就够了——你要的是跑通链路,不是做学术研究。
这一步的核心练两点:一是API调用,要清楚怎么传入prompt、怎么拿到返回、怎么做流式输出、怎么处理错误;二是提示词控制,别把提示词当作文写,关键是让输出可控。比如要它输出严格的JSON、要它只按某些规则回答、遇到不确定就明确说「不知道」。只有把输出控制住,后面做Agent才不会崩。
第二步:让模型学会使用工具
Agent之所以值钱,在于它不只会「说」,还会「做」。工具调用可以从三个最常见的能力练起:检索、函数调用、代码执行(或接口调用)。
举两个例子:做一个资料问答Agent,它要先去文档库里检索,再把答案整理出来,还要标注引用来源,不能凭空编造;做一个数据分析Agent,用户丢一份表格,它能自己判断用什么方法分析、写出代码跑出结果,再用人话把结论解释清楚。一旦模型能调用工具,它就从「聊天机器人」变成了「同事」,这就是本质差别。
工具调用(Function Calling / Tool Use) 是现代大模型的核心能力之一,指模型在对话中识别出需要调用外部工具的时机,自动生成结构化的调用指令,由外部程序执行后再将结果返回给模型。OpenAI、Claude、Gemini 等主流模型均原生支持这一机制。
RAG(Retrieval-Augmented Generation,检索增强生成) 是实现「检索」类工具的主流方案:先将文档切片、向量化并存入向量数据库(如 Chroma、Pinecone、Milvus),用户提问时先检索最相关的文本片段,再将其拼入 Prompt 送给模型生成答案。这一机制的核心价值在于让模型能回答训练数据之外的私有知识,同时减少「幻觉」——因为答案有据可查、来源可标注。理解 RAG 的召回质量(向量相似度、Chunk 切分策略)对后续第三步的工程优化至关重要。
第三步:把Agent做成能交互的系统
很多人到这一步开始掉链子——Demo能跑,但一上强度就不稳定。这一步要开始考虑的是真正的工程问题:
- 上下文怎么管理,长对话怎么做记忆
- 知识库怎么更新,检索怎么避免召回垃圾
- 模型输出怎么校验,失败了怎么重试
- 怎么做日志、怎么做权限控制
这些听起来像纯粹的工程问题,没错——这正是企业愿意开出较高薪资的原因。Agent工程师不是「玩具工程师」,而是能把玩具变成生产力的人。这一步最好跟着一个完整的大项目走,亲手做过一遍,印象和理解会深刻得多。
这一阶段涉及的「上下文管理」是 Agent 工程化的核心难点之一。大模型本身是无状态的,每次 API 调用相互独立,「记忆」需要由工程侧主动维护。常见方案有三类:一是全量上下文拼接,把所有历史消息都传给模型,简单但会撑爆 Token 限制;二是滑动窗口,只保留最近 N 轮对话;三是摘要压缩,定期让模型把历史对话压缩成摘要再继续。此外,LangChain、LlamaIndex 等框架提供了 Memory 模块来抽象这一过程,但在生产环境中通常还需结合 Redis 等外部存储实现跨会话的持久化记忆。输出校验方面,常见做法是使用 Pydantic 定义期望的 JSON Schema,配合重试逻辑(如 Tenacity 库)在模型输出格式不合规时自动重新请求,这是保证系统稳定性的最基本工程手段。
第四步:怎么拿到Offer
简历里别写「熟悉大模型」「了解Agent」这种话,跟没写一样。你要写的是:你做了什么系统、它怎么工作、你解决了什么问题、用了哪些关键机制、怎么保证稳定性。
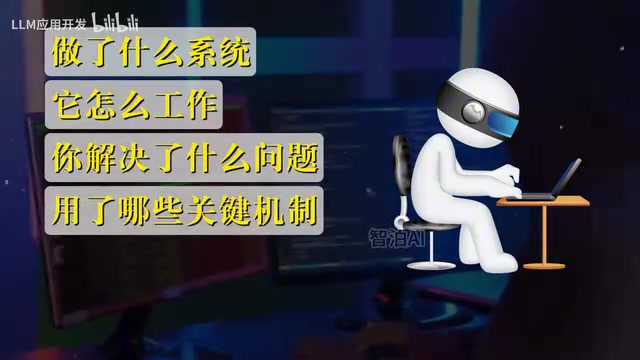
UP主给出了一个可参考的表达模板:「实现了一个支持工具调用的Agent,具备任务规划、检索增强、输出校验能力,支持多轮对话与上下文管理,在某某场景下将人工处理时间从X降到Y。」这样的句子一出来,面试官基本就能判断你是「干过活的人」。因为面试官其实很「懒」,他只想快速判断你能不能上手干活。
一点冷静的提醒
这个视频本质上是一则课程推广,UP主提到大厂朋友推荐了公司采购的课程,并在评论区放了公开课链接和内部资料包(包括从0到1笔记、面试题、商业项目实战等)。这类营销话术需要理性看待,「50倍大模型」「薪资翻倍」等表述带有明显的招生色彩,不必全盘当真。
但抛开营销外壳,视频里的技术路线本身是站得住脚的:先跑通模型调用 → 再让模型会用工具 → 再做成稳定的交互系统 → 最后用项目成果包装简历。这条从入门到实战的进阶逻辑,对想转型Agent开发的人确实有参考价值。
真正的建议其实很朴素:如果你现在处于「想做但不知从哪开始、看了一堆项目却拼不起来、投了很多简历没回应」的状态,与其继续焦虑,不如先把最关键的工具链跑通,把第一个能用的版本做出来。焦虑不会涨薪,只会让你停在原地。
相关推荐
Comp AI获3400万美元A轮融资,押注智能体化安全合规
网络安全合规创业公司Comp AI宣布完成3400万美元A轮融资,由Roo Capital和Grand Ventures领投,押注「持续智能体化」的安全与合规自动化未来。本文解析其技术愿景与市场竞争格局。
vLLM v0.30.0rc1发布:修复FlashInfer BF16自动调优隔离问题
vLLM 发布 v0.30.0rc1 候选版本,核心修复为隔离 FlashInfer BF16 自动调优逻辑(PR #57285)。本文解读该修复的技术背景、FlashInfer 与 BF16 调优机制及对推理部署的实际影响。
MIT科技评论:35岁以下气候科技创新者名单解读
《麻省理工科技评论》最新一期「35岁以下创新者」榜单聚焦气候科技,收录全球九位年轻研究者与发明家,解读这份名单的背景、意义与对气候科技未来的启示。