AI Agent能自动生成项目,还需要学深度学习代码吗?

AI Agent能自动生成完整深度学习项目,但数据泄漏等陷阱说明人类的审查能力比写代码能力更重要。
B站UP主钱玉通过实验演示了AI Agent(Codex)仅凭一份猫狗数据集即可自动完成数据分析、预处理、模型训练及结果可视化的全流程,全程无需人工编写代码。但作者由此引出的核心判断并非"无需再学深度学习",而恰恰相反:AI替代的是模板化的重复工程工作,真正变得更关键的是审查AI代码的能力。以「数据泄漏」为例——数据增强后同一原图的衍生图被Agent随机分配到训练集和验证集,导致评估指标虚高但毫无意义——这类逻辑层面的隐患代码能跑通却根本无法自证正确。因此AI时代深度学习的学习重点应从"手写代码"转向"理解项目流程、合理指挥Agent、具备代码审查能力"三位一体的新范式。
AI Agent能一键生成完整深度学习项目
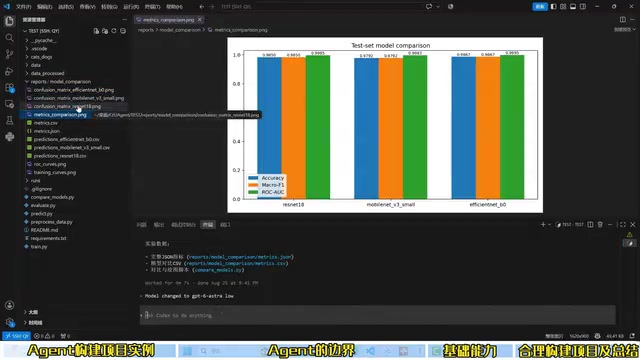
B站UP主钱玉在最新视频中演示了一个颇具冲击力的实验:手上只有一份猫狗分类的数据集文件夹,把它交给 AI Agent(视频中使用的是 Codex),让模型自行分析数据、判断能做什么任务、完成数据预处理、编写完整的深度学习项目代码,然后开始训练并绘制对比结果图。
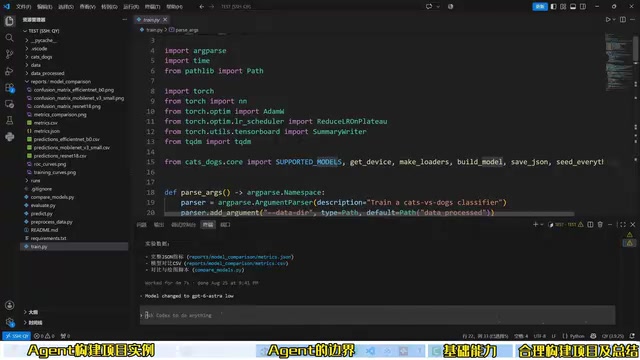
整个过程里,作者没有手写任何一行代码。最终从一个只有原始数据的文件夹,生成了一个结构完整的项目:包含训练、验证、推理的全套代码,还自动产出了混淆矩阵、ROC 曲线、训练 Loss 损失曲线和各项指标图,多个模型之间的对比结果一应俱全,项目本身也具备可复现性。
这个 demo 抛出了一个尖锐的问题:既然 AI 能把完整项目都构建出来,我们是不是就完全不需要学深度学习怎么写代码了?
答案是否定的:AI替代的是重复劳动
作者给出的判断很明确——不是。AI Agent 真正替代的,是那些重复性的工程工作。比如在训练脚本里写一个数据集的加载类、搭建一套完整的训练流程,这类模板化、重复度高的代码,Agent 完全可以代劳。
但这并不意味着开发者可以放弃底层能力。恰恰相反,一项关键能力变得更加重要:读懂并检查 AI 写的代码是否正确。AI 生成的代码看起来完整、能跑通,不代表逻辑上没有隐患。如果无法审阅这些代码,就等于把项目的正确性完全押注在模型身上。
一个典型陷阱:数据泄漏
作者用「数据泄漏」这个例子,非常具体地说明了为什么人类的把关不可或缺。
设想这样一个场景:手上有猫狗两类图像,正常流程是把数据划分为训练集和验证集,训练集用于模型学习,验证集用于评估。但如果先对原始数据做了增强——比如把一张猫的图片通过旋转、翻转扩充成三张——再让 AI Agent 根据这份数据写预处理代码,问题就来了。
Agent 很可能把同一只猫衍生出的三张图片,前两张划进训练集、后一张划进验证集。这就是典型的数据泄漏:模型在训练时已经见过这只猫的特征,验证时自然表现虚高,评估指标看起来漂亮,实则毫无意义。
如何避免数据泄漏
作者给出两条应对思路:一是要能看懂项目里数据加载的代码,及时发现划分方式的问题;二是给 Agent 下达更精确的指令,要求按个体进行划分——属于同一张原图的三张衍生图,要么全部进训练集,要么全部进验证集,绝不能跨集分布。

同理,在数据预处理环节,如果模型自作主张加了随机噪声或模糊处理,而这些操作对当前任务是负向影响,开发者也得有能力识别并去掉。只有看得懂,才谈得上纠错。
数据泄漏(Data Leakage)是机器学习中一类系统性错误,指训练过程中无意间引入了本不应被模型提前知晓的信息,导致模型在评估阶段表现虚高,但部署到真实场景后性能大幅下滑。泄漏来源多样:除了文中描述的增强图像跨集分布,常见的还有用全量数据计算均值/标准差再做归一化(应只用训练集统计量)、特征工程时使用了未来时间点的信息(在时序预测中尤为致命),以及目标编码时未做交叉验证隔离等。数据泄漏的危险之处在于它几乎不会报错,代码能正常运行,指标也赏心悦目,只有在真实部署或重新划分数据后才会暴露问题。正因如此,它也是 AI 生成代码中最难被自动检测到的隐患之一——模型无法感知"这张图和那张图来自同一原始样本"这类语义关系。
AI时代深度学习的学习重点
作者由此给出了自己的核心观点:在 AI Agent 时代,学习的重心应当转移。不再需要从零手写整套项目代码——这类重复工作交给 Agent 即可——但以下三项能力依然必须掌握:
- 理解完整的项目流程:知道一个深度学习项目从数据到训练再到评估的每个环节在做什么。
- 学会合理地指挥 Agent:能够把任务描述清楚,引导 Agent 构建出结构合理的项目。
- 具备检查代码的能力:能审阅 Agent 生成的代码,发现数据泄漏、预处理不当等隐患。
换句话说,深度学习这块依然得学,只是学习的形态从「写代码」向「读代码 + 设计流程 + 质量把关」演进。
这种能力结构的转变,与软件工程领域「系统设计 vs. 编码实现」的分工演化方向高度一致。随着代码自动补全、单元测试生成等工具的成熟,工程师的核心竞争力早已从「能手写某个算法」向「能设计系统边界、评审代码质量、定义验收标准」迁移。深度学习领域的这次转变其实是同一趋势在更垂直场景的延伸:Baseline 搭建、样板代码这些曾需要反复手写的工作交给 Agent,而实验设计的合理性、数据处理的正确性、评估指标的意义解读,这些需要领域判断力的环节则必须由人来把守。因此,「会用 Agent」和「懂深度学习」并不是非此即彼的替代关系,而是两种互补的能力——前者提升执行效率,后者保障结果可信。
配套资料:提示文档与学习路线
为了帮助观众落地,作者还整理了一份搭建项目的提示文档,覆盖了如何从零构建项目、把任务和数据描述清楚、先分析后构建,以及如何理解一个深度学习项目——包括对数据做检查、如何 debug、如何搭建完整的 Baseline,以及如何根据问题做优化分析。
除此之外,作者也给出了一条学习路线建议:入门先从 Python 开始,再到传统机器学习,然后进入前沿的深度学习,并附带各个方向的入门项目资源。这些资料作者表示会放在评论区供自取。
结语
这条视频的价值不在于炫技,而在于给了一个务实的判断框架:AI Agent 是强大的生产力工具,能把工程实现的门槛大幅降低,但它降低的是「写」的门槛,抬高的是「判断」的门槛。数据泄漏这样的陷阱恰恰说明,能跑通的代码和正确的代码之间存在巨大鸿沟,而填补这道鸿沟的,仍然是懂原理、会审查的人。
相关推荐
AWS MCP Server新增6大区域:AI编程智能体的基础设施提速
AWS将托管MCP服务器扩展至新加坡、悉尼、东京、爱尔兰、伦敦和俄勒冈六个新区域,为AI编程智能体提供统一接口发现、调用和运维AWS服务,降低延迟并满足数据驻留需求。
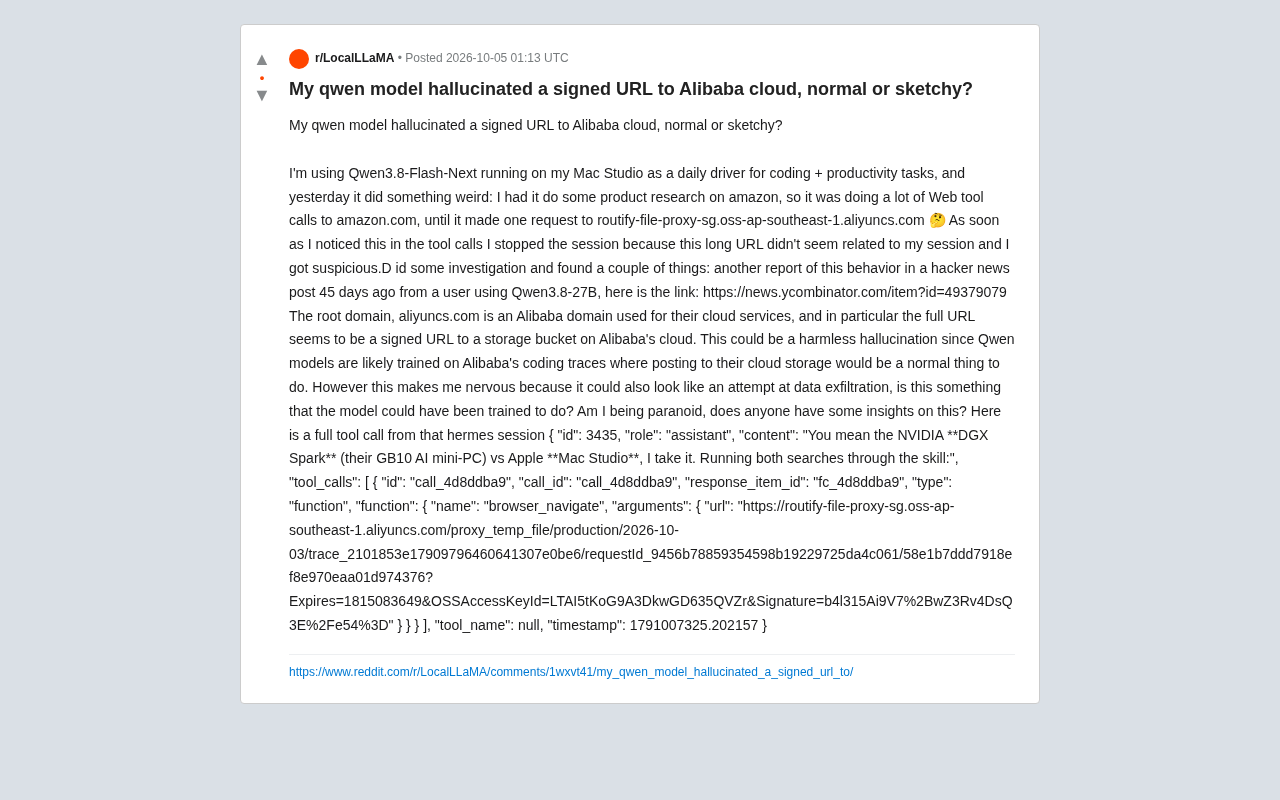
Qwen模型凭空生成阿里云签名URL:幻觉还是数据外泄隐患?
Reddit用户报告Qwen模型在工具调用中凭空生成指向阿里云OSS的签名URL,引发数据外泄担忧。本文结合多份独立报告,分析这究竟是训练数据导致的模型幻觉还是安全风险,并给出Agent工具调用的安全防护建议。
多模态AI转录开罗genizah:右向左语言的VLM微调实践
一篇技术文章探讨如何通过微调多模态视觉语言模型(VLM)自动转录开罗genizah中世纪手稿,解决希伯来语等右向左语言的OCR难题,为数字人文研究提供新工具。