AI Agent入门:概念、架构与核心组成全解析

从命令行到Agent:计算革命的第三次浪潮
微软创始人比尔·盖茨曾发表观点,认为AI Agent(智能体)相当于Windows、安卓、iOS这类平台级操作系统的又一次颠覆机会。他形容这将是自我们从键入命令到点击图标以来最大的一次计算革命。
回顾软件发展史,我们经历了两次重大进化。第一次是键入命令时代——命令行界面(CLI)起源于20世纪60年代的分时操作系统,用户必须记忆并精确输入指令才能与计算机交互,门槛极高,普通人根本无法使用。这一时代的代表是1969年贝尔实验室诞生的UNIX系统,其设计哲学"一切皆文件"与管道(pipe)机制深刻影响了此后数十年的软件工程文化;MS-DOS则将命令行带入了家用PC时代,但也将数亿普通用户挡在了数字世界的门外。第二次则是以微软Windows为代表的点击图标时代:1984年苹果推出Macintosh,1985年微软发布Windows 1.0,将施乐PARC研究所发明的图形用户界面(GUI)商业化,鼠标点击取代了键盘命令,将复杂的命令行操作可视化,极大降低了软件使用门槛,使计算机用户数量在二十年内从数百万增长到数十亿,同时催生了UI设计、前后端开发等全新工种,甚至孕育了浏览器与整个Web生态。
盖茨认为,Agent带来的效应与前两次一致:它会再一次彻底改变人类使用计算机的方式。而这一次的核心,是自然语言交互成为主流。值得注意的是,自然语言界面并非新概念——早在1990年代就有语音识别助手的尝试,但受限于当时的NLP技术,系统只能处理有限的预设指令集。真正的转折点发生在2017年Transformer架构问世、2020年GPT-3横空出世之后:大规模预训练使模型具备了真正的语义泛化能力,自然语言才从"输入方式"升级为"交互范式"。这一底层技术的成熟,是当前Agent革命得以发生的根本前提。
AI Agent是什么:与传统软件的本质区别
过去我们的手机里装满了各类APP,每个任务对应一个软件——单任务、单APP。而AI Agent的核心特征是:你不需要为不同任务使用单独的软件。它更像一个超级入口、一个统一的助手,你只需告诉它意图,它就会调度并编排底层软件去完成任务。
举个例子,腾讯此前推出的一款Agent,能在学习用户操作后自动在手机上帮你调用各类APP。你要做的仅仅是表达意图。
这与过去的智能助手有本质区别。以小爱同学为例,你说"打开灯",它能找到设备执行;但你若说"我觉得这屋子光线有点暗",它便无从反应——因为它的智能程度尚未到达理解层面。而大模型驱动的Agent不仅能理解这类模糊表达,如果传感器足够丰富,它甚至能主动思考:光线值低于多少该开灯?主人是否在家?该不该开灯?这种自主推理能力的背后,是**大语言模型(LLM)**的语义理解机制在发挥作用——LLM基于Transformer架构,经过海量文本预训练,通过注意力机制(Attention Mechanism)捕捉语言中的深层语义。Transformer由Google于2017年在论文《Attention Is All You Need》中提出,其核心创新在于用自注意力机制替代了此前主流的循环神经网络(RNN),使模型能够并行处理序列中任意位置之间的依赖关系,从而将"光线有点暗"这类模糊表达准确映射为具体的执行意图。这正是Agent与传统"智能设备"最大的分野。
理解这一差距,还需了解两类系统在训练范式上的根本不同。传统语音助手依赖**意图识别(Intent Classification)**模型——开发者预先定义有限的意图类别(如"开灯""关灯""调节亮度"),模型只能在这些类别中做分类匹配,遇到未定义的表达即失效。而LLM经过自监督预训练,习得了语言本身的概率分布,无需预定义意图便能理解开放域表达,这使得Agent能够应对真实世界中无穷无尽的用户意图变体。
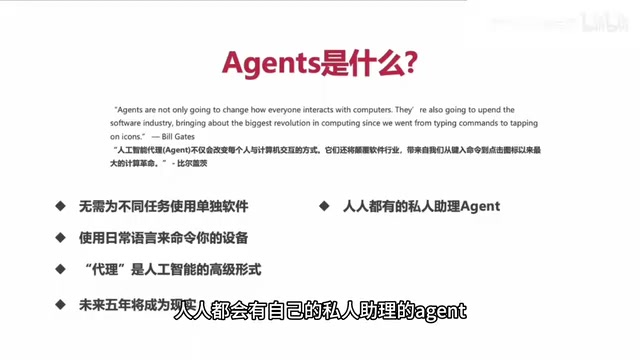
因此可以说,Agent是人工智能的高级形式。很多人对AI的直观认知还停留在ChatGPT的聊天写作层面,但通过大模型驱动的Agent,AI能做的远不止于此。盖茨预测,未来五年这些设想都将成为现实,人人都可能拥有一个类似钢铁侠中"贾维斯"的私人助理,可按个人喜好、职业方向定制不同性格与专长。
AI Agent + 机器人:下一波岗位替代浪潮
AI领域知名学者吴恩达(Andrew Ng)已全面投入AIGC行业,其主导的团队正在探索将大模型驱动的Agent与机器人硬件结合的前沿方向——这一领域被称为具身智能(Embodied Intelligence)。与纯软件Agent不同,具身智能体需要感知物理世界并产生物理动作。当前主流技术路线是视觉-语言-动作模型(VLA,Vision-Language-Action Model),将摄像头图像与语言指令共同输入,直接输出机械臂的关节控制信号,实现"看懂→理解→动手"的端到端闭环。这一方向的奠基性工作包括Google DeepMind的RT-2模型与斯坦福的Mobile ALOHA项目——前者首次证明了语言模型的知识可以直接迁移到机器人操作中,后者则以不足3万美元的硬件成本实现了炒菜、洗碗等复杂家务,令学界为之震动。具身智能被认为是继大语言模型之后AI落地物理世界的关键一跃,波士顿动力、Figure AI、宇树科技等硬件公司正竞相与大模型团队展开合作。
传统机器人,即便是常见的扫地机器人,所谓的"智能"也十分有限——路线需人工规划,避障靠简单算法(比如识别沙发腿、桌腿后碰撞两次即转向),因此经常卡在床底出不来。更关键的是,它的程序是写死的:扫地机器人只能扫地,你让它擦桌子它无能为力。
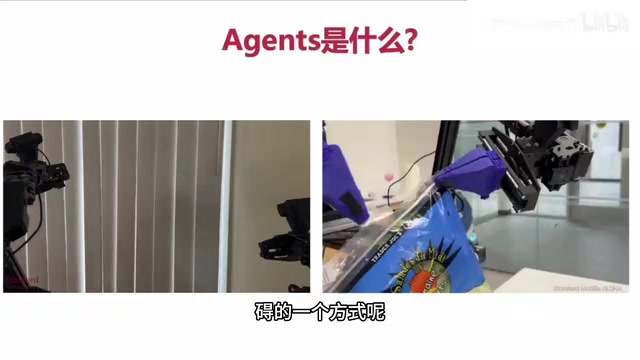
而当把大模型作为"脑子"装进机器人后,情况截然不同。它能自主学习、执行多样化任务。在相关演示中,机器人甚至能制作中餐——要知道中餐是最难被量化编程的领域,充满"少许""若干"这类模糊描述,这从侧面印证了它并非依赖传统量化编程,而是带有强烈的模拟学习痕迹,很多动作高度模拟人类。这类学习方式在技术上对应**模仿学习(Imitation Learning)与强化学习(Reinforcement Learning)**的结合:机器人先通过人类演示数据学习动作先验(行为克隆阶段),再通过与环境交互的试错反馈不断优化策略。OpenAI早期的机器手项目Dactyl即采用这一范式,在纯仿真环境中训练后迁移到真实机械手,实现了魔方还原——这一"仿真到现实(Sim-to-Real)"的迁移能力,正在成为具身智能量产落地的关键技术路径。
特斯拉推出的"大模型 + 机器人控制模型"方案也是同类思路:LLM作为机器人的中控大脑,解决了传统机器人智能程度低的问题。可以预见,如果说第一波AI浪潮冲击的是脑力工作岗位,那么"AI + 机器人"的第二波,可能会大量取代体力劳动岗位。
AI Agent的定义与四大核心组成
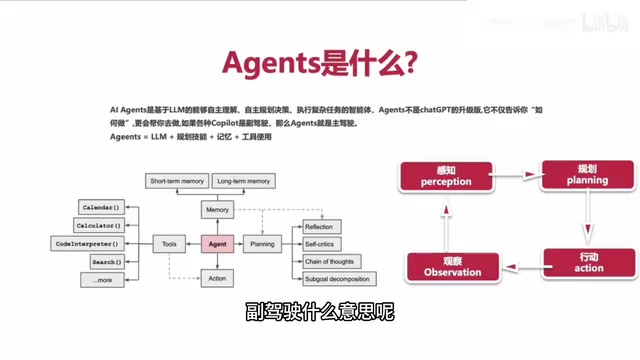
从理论角度看,AI Agent是基于大语言模型、能够自主理解、规划、决策并执行复杂任务的智能体。
它不是ChatGPT的升级版。ChatGPT更多是告诉你"如何做",而Agent不仅告诉你怎么做,更会帮你去做,解决了下一步执行的问题。用一个比喻:GitHub Copilot这类助手是"副驾驶",坐在副驾上只会提醒你"前面路口右转";而Agent是"主驾驶",它会自主决策、自主执行。
业界对Agent给出了一个经典公式:
Agent = LLM(大模型)+ Planning(规划)+ Memory(记忆)+ Tools(工具使用)
这四个部分的协作机制如下:
规划(Planning)
负责做决策与策略制定,常用技术包括自我反思(Reflection)、自我循环,以及在LangChain中最常见的思维链(Chain of Thought,CoT)。CoT由谷歌研究团队于2022年提出,通过引导模型逐步展示中间推理步骤来显著提升复杂任务准确率——实验表明,对于数学推理类任务,CoT可将准确率提升40%以上。在Agent中,CoT使规划模块能够将宏观目标分解为可执行的子任务序列,类似人类解题时逐步列出步骤。进阶变体包括Tree of Thought(思维树,通过分支搜索探索多条推理路径)和ReAct(推理+行动)框架,后者将推理与工具调用交织进行,是当前Agent开发的主流范式。
值得补充的是,规划能力的质量直接决定了Agent在复杂任务上的成败。业界评估Agent规划能力的主流基准测试包括ALFWorld(文本游戏环境中的多步骤任务)、WebArena(真实网页操作任务)和GAIA(通用AI助手能力基准)。当前最先进的模型在这些基准上的得分仍远低于人类水平,说明规划能力依然是整个Agent技术栈中最需突破的瓶颈之一。
记忆(Memory)
分为短时记忆与长时记忆。短期记忆对应对话上下文窗口(Context Window),当前顶级模型支持从128K到200万Token不等的上下文长度;长期记忆则依赖**检索增强生成(RAG,Retrieval-Augmented Generation)**技术——外部知识库通过向量数据库(如Pinecone、Chroma、国内的Milvus)存储,其核心原理是将文本转化为高维向量表示(Embedding),Agent在规划时通过计算语义相似度(通常采用余弦相似度)检索相关历史信息注入上下文。RAG技术有效解决了LLM"知识截止日期"与"幻觉"问题,使Agent能够调取企业私有知识库中的最新信息。决策时,Agent会调用记忆参与推理,这非常类似人类思考——做决策时会想起"好多天前遇到过这个事情,当时是怎么处理的",并将经验纳入当前判断。
从认知科学角度看,这一架构设计与人类记忆的分类高度吻合:短期记忆对应心理学中的工作记忆(Working Memory),容量有限但检索极快;长期记忆则对应情景记忆(Episodic Memory)与语义记忆(Semantic Memory),通过RAG实现的"按需检索"机制,类比人类大脑海马体在记忆巩固与提取中的作用。这并非偶然——Agent架构的设计者们在很大程度上参考了认知科学与神经科学的研究成果,试图在计算系统中复现人类智能的信息处理流程。
工具(Tools)
有了计划后执行行动,需要调用工具。Agent会从工具库中匹配相应工具(如缴费接口、路线查询接口等)加入到行动环节。目前主流的Agent开发框架,如LangChain(由Harrison Chase于2022年创立,GitHub星标已超9万)、微软的AutoGen(支持多Agent协作对话)、百度AppBuilder等,均提供了标准化的Tool调用抽象。值得一提的是,OpenAI于2023年推出的Function Calling机制进一步规范了LLM调用外部工具的接口标准,使开发者能够以JSON Schema格式声明工具能力,由模型自主决定调用时机与参数,大幅降低了Agent工具集成的开发门槛。
工具调用能力的背后,存在一个重要的安全与可靠性议题:工具调用的幻觉问题(Tool Hallucination)。LLM有时会虚构并不存在的工具名称或错误填写参数,导致执行失败甚至产生危险操作。当前业界的主要应对策略包括:为工具调用添加人工审批节点(Human-in-the-loop)、设置沙箱隔离执行环境、以及通过微调使模型更精确地遵循工具调用规范。这些安全机制的完善程度,在很大程度上决定了Agent能否真正在企业生产环境中被信任并大规模部署。
感知-规划-行动-观察循环
这正是RAG(增强式生成)中的核心循环。每执行一个任务(Task),Agent都会走一遍"规划→行动→观察→感知"的闭环。
因此可以总结:本质上,Agent是一个大模型的编排与执行系统。它每执行一次任务,就是一次完整的决策循环,每一次循环都会调用大模型。
为什么开发者现在就要学习Agent开发
很多媒体渲染"程序员将被AI取代"的焦虑,但持这种观点的人往往对AI能力缺乏深入了解。真正的机会在于:如何将传统软件工程与大模型能力相结合。
这里有大量开发机会,只是思路模式与传统应用开发不同。以做一个汽车相关APP为例,过去你需要精细开发养车、缴费、路线查询等一系列功能模块;而现在做Agent,你只需将这些接口和工具全部暴露给它,再告诉它意图,它便能自主实现——大量传统软件由此被替代。这正是LangChain、AutoGen等Agent框架所提供的核心价值:开发者只需定义好工具集合与业务逻辑边界,剩余的任务分解、工具选择、结果校验均由框架与LLM协同完成。当前业界还涌现出以**MCP(Model Context Protocol)**为代表的工具接入标准协议——由Anthropic于2024年提出,旨在统一不同Agent框架与工具服务之间的通信规范,其意义类似于USB接口之于硬件外设:一旦标准确立,生态将呈指数级扩张。
MCP的设计哲学值得深入理解。在MCP出现之前,每个Agent框架都有自己的工具集成方式:LangChain有Tool抽象,AutoGen有Function Map,Semantic Kernel有Skill体系——这种碎片化导致同一个工具服务需要为不同框架重复开发适配层,极大浪费了生态建设的资源。MCP借鉴了软件工程中接口标准化的经典思路,定义了统一的服务器-客户端协议(Server-Client Protocol),工具提供方只需实现一次MCP Server,即可被所有支持MCP的Agent框架调用。这与当年HTTP协议统一Web通信、REST API统一后端接口的历史逻辑如出一辙——标准协议的确立,往往是一个技术生态从"早期探索"走向"规模爆发"的临界点。目前已有Zapier、Stripe、GitHub等数十家主流服务商宣布支持MCP,这一趋势值得所有Agent开发者密切关注。
盖茨将Agent视为继PC、iOS、安卓之后的下一个平台。有平台就意味着有应用,有应用就意味着有更多机会。目前反应敏捷的创业公司和大厂已在这一方向布局。对开发者而言,掌握AI应用开发与Agent开发能力,将在未来市场中拥有更强的竞争力。
核心要点
核心要点
核心要点
相关推荐

Workbuddy零基础入门:桌面AI智能体如何落地工作流
Workbuddy桌面AI智能体零基础教程解读:从安装、积分领取到文件管理与自动化工作流搭建,对比CodeX的适用场景与成本差异,帮助职场人完成从AI提问者到AI管理者的思维转变。

OpenAI智能体新栈:计算机操作、决策API与超速工作流
OpenAI Dev Day发布智能体新栈:Computer Use操作速度超越普通人,Decisions API基于Luna实现极低延迟分类,Agents API开放同源计算机操作能力,GPT-6.1 Sol成本仅为Astra七分之一。本文梳理核心更新、实测数据与开发者落地要点。

梁文峰开源推理框架DeepInfo,硬刚美国禁令
DeepSeek在开源模型后再开源推理框架DeepInfo,包含GPU/CPU交叉流水线、小模型预判大模型复核、华为昇腾与英伟达芯片全面适配等技术,直面美国联邦禁令。本文解析其对AI产业落地的意义与开源策略。