AI Cosmos:用智能体基建实现情境学习

AI Cosmos以情境学习智能体基础设施,让模型退居支撑位,提升学习增益与迁移能力。
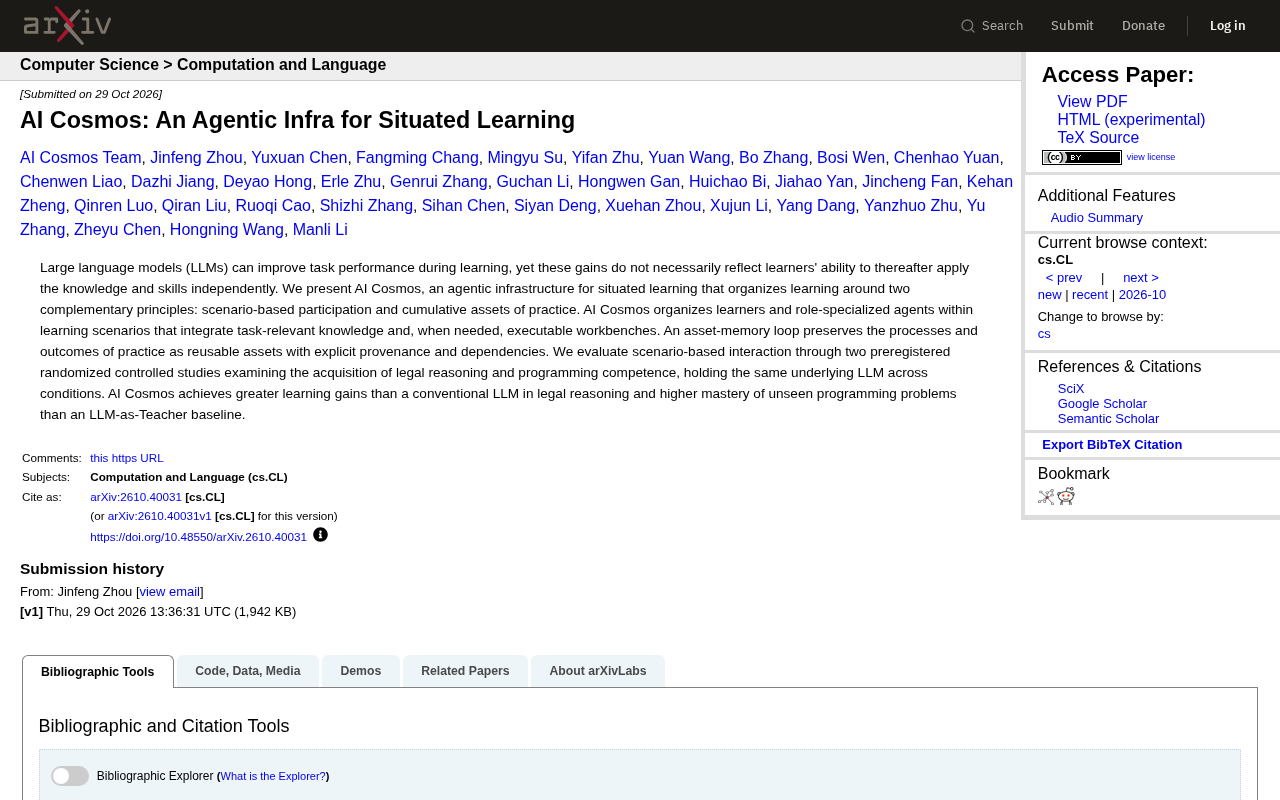
本文介绍了一项关于AI Cosmos的研究,它回应了AI教育中的核心矛盾:大语言模型能改善任务表现,却未必转化为学习者独立应用知识的能力。AI Cosmos围绕情境化参与和实践资产累积两大原则构建智能体基础设施,通过资产—记忆循环把实践过程保存为带来源与依赖关系的可复用资产。研究团队开展两项预注册随机对照实验,在底层LLM一致的条件下分别考察法律推理与编程能力。结果显示,AI Cosmos在法律推理上取得高于常规LLM的学习增益,在未见过的编程问题上迁移能力优于LLM-as-Teacher基线。文章据此主张,与其优化模型讲解能力,不如重新设计学习者与模型的协作结构,把实践与迁移留给学习者。
大语言模型能提升任务表现,但这种提升未必转化为学习者独立应用知识与技能的能力。这是当前AI教育应用的一个核心矛盾:模型代劳得越多,学习者真正掌握得越少。来自rss的一项研究提出了AI Cosmos,一个面向情境学习的智能体基础设施,试图从架构层面回应这一问题。
问题:任务表现不等于学习成效
论文开篇点明了一个容易被忽视的差异:LLM可以在学习过程中显著改善任务完成质量,然而这些收益并不必然反映学习者此后独立运用知识与技能的能力。换句话说,把LLM当作答案生成器,短期看效率很高,长期看可能削弱学习者的独立胜任力。
这一判断构成了AI Cosmos的设计出发点。研究团队没有把重点放在"让模型答得更好",而是转向"让学习者在情境中真正参与实践"。
情境学习(Situated Learning) 是理解本文设计理念的关键理论背景。这一概念由 Jean Lave 与 Etienne Wenger 在 1991 年提出,核心主张是:学习并非脱离情境的知识传递,而是发生在真实或模拟的实践共同体中的社会性参与过程。学习者通过"合法的边缘性参与"逐步进入实践共同体,从外围任务走向核心任务。情境学习强调三个要素:真实的实践情境、共同体中的角色分工、以及实践中形成的身份认同。AI Cosmos 将学习者与角色分工明确的智能体置于学习情境中,正是把这一理论工程化——智能体扮演共同体成员,工作台提供实践工具,资产记忆则承担了实践中知识与经验沉淀的角色。理解情境学习,才能理解为何该研究把"情境参与"而非"内容讲解"作为首要设计原则。
两大设计原则:情境参与与实践资产
AI Cosmos围绕两条互补原则组织学习。
情境化参与(scenario-based participation):学习者与角色分工明确的智能体被置于学习情境之中。这些情境整合了与任务相关的知识,并在需要时提供可执行的工作台(executable workbenches)。学习者不是被动接收讲解,而是在情境里动手做事。
实践资产累积(cumulative assets of practice):系统通过资产—记忆循环(asset-memory loop),把实践的过程与结果保存为可复用的资产,并为每个资产标注明确的来源(provenance)与依赖关系。这意味着学习过程本身成为可积累、可追溯的结构,而不是一次性消耗的对话记录。
这两条原则的搭配值得注意:情境参与解决"怎么学",资产累积解决"学到了什么、如何复用"。
预注册随机对照实验(Preregistered RCT) 是本文实验方法可信度的重要保障。预注册指研究者在数据收集之前,将研究假设、实验设计、样本量、主要结局指标与分析计划公开登记(常见平台如 OSF、AsPredicted)。其目的是防止事后挑选结果、p-hacking 等导致假阳性的做法,因为分析路径在看见数据前就已锁定。随机对照实验则通过随机分配被试到实验组与对照组,控制混淆变量,使组间差异可归因于干预本身。在本研究中,预注册加上"所有条件下底层 LLM 保持一致"的双重控制,意味着学习增益的差异只能来自 AI Cosmos 的基础设施与交互结构,而非模型能力波动。这比普通的 A/B 测试更能支撑因果推论,也让"迁移能力优于 LLM-as-Teacher 基线"的结论更具说服力。
实验设计:同模型对照,控制变量
研究团队通过两项预注册随机对照实验评估情境化交互的效果,分别考察法律推理与编程能力的习得,并在所有条件下保持底层LLM一致。
控制底层模型相同这一点很关键——它把效果差异归因于基础设施与交互设计,而非模型能力本身。
结果:学习增益与迁移能力双优
实验结果呈现两个方向上的优势。在法律推理方面,AI Cosmos取得了比常规LLM更大的学习增益;在编程方面,面对未见过的编程问题,AI Cosmos的掌握程度高于"LLM作为教师"(LLM-as-Teacher)基线。
后者尤其值得关注。未见问题上的表现衡量的是迁移能力,而不是对已练题目的记忆。这恰好呼应了论文开头的判断:真正的学习成效要看学习者能否独立应对新任务。
LLM-as-Teacher 基线 是当前 AI 教育产品最主流的范式:由一个通用大模型扮演教师角色,通过讲解、答疑、生成练习与反馈来完成教学。它与 AI Cosmos 的差异不在模型强弱,而在协作结构。LLM-as-Teacher 通常把学习者放在接收端,模型掌握知识组织权与节奏控制权,交互形态以问答和讲解为主,学习记录多为一次性对话。AI Cosmos 则让智能体承担情境中的角色分工,学习者在使用可执行工作台的过程中行动,成果被资产—记忆循环沉淀为带来源的可复用资产。因此在"未见过的编程问题"这类需要迁移的测试上,两者拉开差距:教师范式训练的是对讲解的理解,情境范式训练的是实践中的独立胜任力。这一基线定位也说明,本文比较的不是提示词技巧,而是教育交互范式的根本差异。
启示:从"模型代劳"到"基础设施支撑"
AI Cosmos的价值不在于提出某个更强的教学提示词,而在于把学习环境当作基础设施来设计:情境提供实践土壤,智能体承担角色分工,资产记忆让实践成果沉淀下来。
对于正在探索AI教育产品的团队,这项研究提供了一个不同的思路——与其不断优化模型的讲解能力,不如重新设计学习者与模型之间的协作结构,让模型退到支撑位置,把实践与迁移留给学习者。
相关推荐

Cloudflare开源AI代码安全审计工具,获6万星
Cloudflare开源Security Audit,为AI编码Agent提供免费安全审计。三步工作流:应用测绘、多Agent对抗找Bug、三级分类报告,源自内部漏洞狩猎系统,近6万星标。

GPT-6 Astra读权重绝技:仅限小网络,实用靠写代码
GPT-6 Astra能直接读网络权重,但无工具设置仅限约17万权重的小网络。修复QUEN 3.5 0.8b推理循环靠写Python和50批练习,实测识别游戏耗时近一小时。本文梳理能力边界与两个安全提醒。

GPT-6 Astra 改写 Qwen 权重:7.9% 到 48.1%,是学会了数学还是学会了停?
MIT研究者用GPT-6 Astra直接编辑Qwen权重,数学得分从7.9%升至48.1%,全程无训练。但独立复现显示,提升主要来自修复循环、让模型学会终止作答,而非新增数学能力。