AI编程工具自动执行该不该全开?权限管控实战指南

AI编程Agent权限越大风险越高,应按风险分层授权、拆小任务并保留人工确认点。
随着AI编程工具进入Agent模式,它们不再只是生成代码,而是能直接执行命令、修改文件、调用API。这带来了效率提升,也带来了被忽视的风险:权限越大,一次误操作的影响范围越广。文章的核心主张是将"效率"与"权限"解耦——低风险操作(读代码、跑单元测试)可以放开自动执行,中高风险操作(改数据库、网络请求、支付)必须保留人工确认,全自动模式只在测试环境或隔离分支中使用。此外,任务应拆解为小步骤并在每步设置检查点,同时要警惕命令的"表面意图"与实际行为不符。成熟的使用方式建立在分支隔离、权限控制、命令审核、测试验证、可回滚五大基础之上,让工具负责速度、开发者保留控制权。
AI 编程工具正在变得越来越强大。它们能自动搜索文件、修改代码、运行测试,甚至直接执行命令行指令。很多人第一次上手时都会面对同一个选择:自动执行功能要不要全部打开?
答案并不是简单的开或关。真正的问题在于——不要把效率和权限混为一谈。
自动执行很方便,但权限越大风险越大
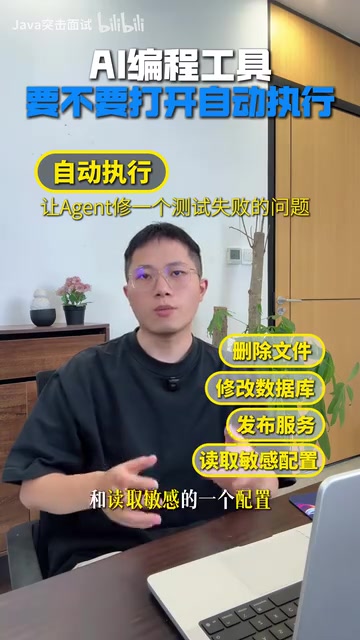
自动执行的价值显而易见。比如让 agent 去修复一个失败的测试,它可以自己读取报错信息、搜索相关代码、修改文件、再次运行测试,整个闭环无需人工干预。这种能力极大减少了重复操作。
但效率的另一面是风险。工具拥有的权限越多,一旦误操作,影响范围也越大。删除文件、修改数据库、发布服务、读取敏感配置——这些高危操作绝不能默认交给 agent 全权处理。
权限配置还必须和任务类型相匹配。开发环境和生产环境不能套用同一套规则。给测试环境放开的权限,放到生产环境就可能酿成事故。
现代 AI 编程工具(如 GitHub Copilot Workspace、Cursor、Claude Code 等)普遍采用"Agent 模式",其核心是让模型能够调用工具(Tool Use)完成多步骤任务。这类工具通常通过 Function Calling 或 MCP(Model Context Protocol)等机制获得操作系统级别的能力——包括文件读写、Shell 命令执行、浏览器控制乃至 API 调用。与早期仅生成代码片段的补全工具不同,Agent 模式下的 AI 具备持续行动、自我纠错的能力,因此其潜在的"副作用"也从"给错建议"升级为"直接造成系统变更"。理解这一根本区别,是正确配置权限的前提。
权限分层:按风险等级区别对待
比较稳妥的做法是在独立分支或独立工作区里运行 agent,只给它当前项目真正需要的目录权限,禁止读取密钥和生产数据。
可以参考这样一套权限分层逻辑:
低风险操作——可以放宽自动执行
读代码、搜索文件、编译、运行单元测试这类操作本身不会造成破坏性后果,适合开放自动执行。即便出错,影响也可控。
中高风险操作——保留人工确认
涉及网络请求、改数据库表、支付、外部网络调用的命令,必须保留确认环节,由开发者成功确认后再执行。这些操作一旦出错往往难以挽回。
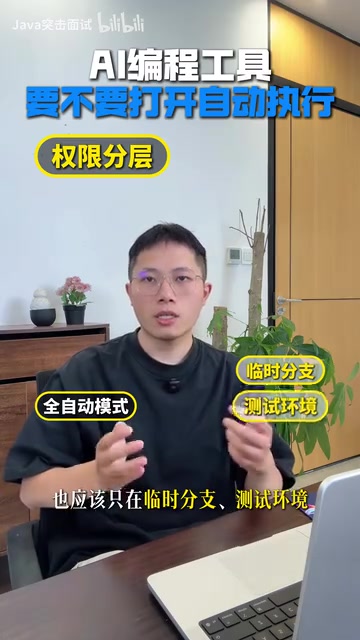
全自动模式——限定使用场景
全自动模式应该只在人事分支、测试环境或一次性任务里使用,不要在主干和生产环境开启。
任务要拆小,每一步都设检查点
除了权限隔离,任务粒度也直接影响安全性。不要直接丢给 agent 一句"把系统升级到新架构"这样的大目标。
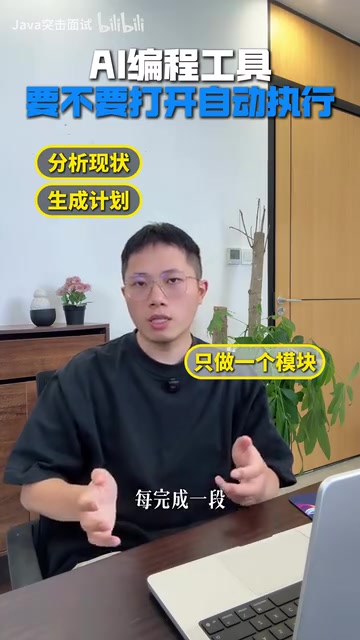
正确的方式是分步推进:先让它分析现状,再生成改造计划;确认计划后,一次只做一个模块;每完成一段就检查 diff、运行测试,确认无误再继续下一步。
这种节奏看似慢,实际上把错误控制在最小范围内。一旦某一步出问题,回滚成本极低,不会影响整个项目。
警惕命令的"表面意图"
还有一个容易被忽视的细节:工具生成的命令可能和它的名字不符。
一条命令看起来只是清理临时文件,实际可能带有递归删除;一段脚本看起来只是更新数据,实际可能没有加任何条件限制,一执行就是全表操作。
所以在自动执行前,务必先看清三件事:命令的真实作用、执行目录、以及影响范围。这是避免灾难性误操作的最后一道防线。
这一风险在安全领域被称为"提示注入"(Prompt Injection)的衍生场景——AI 在处理代码库或外部数据时,可能受到恶意构造内容的影响,生成与预期不符的命令。此外,即便没有恶意输入,模型本身也可能因为对上下文理解偏差而生成"语义正确但行为危险"的命令,例如将 rm -rf ./tmp 扩展为 rm -rf /,或在 SQL 更新语句中遗漏 WHERE 子句。在 CI/CD 流水线或无人值守的自动化场景中,这类错误尤其致命,因为没有人工在执行前看到命令全文。养成"逐行阅读生成命令"的习惯,是防范此类风险最直接的手段。
成熟的用法:自动化低风险,确认高风险
真正成熟的 AI 编程使用方式,不是让 agent 什么都自动做,而是把低风险步骤自动化、把高风险步骤留下确认点。
这样既能减少重复劳动,又能避免一次错误修改波及整个项目。自动执行可以开,但必须建立在五个基础之上:
- 分支隔离:在独立分支或工作区运行,不碰主干
- 权限控制:只给必要的目录权限,屏蔽密钥和生产数据
- 命令审核:执行前看清命令作用和影响范围
- 测试验证:每一步都跑测试确认
- 可回滚:确保任何操作都能撤销
agent 的速度确实重要,但更重要的是开发者对系统的控制能力。把速度交给工具,把控制权留给自己,这才是人与 AI 协作的合理边界。
这五条原则在实践中可以映射到具体的工程工具链上。分支隔离对应 Git 的 feature branch 或 worktree;权限控制可借助 Docker 容器或 chroot 沙箱限制文件系统访问,也可通过 .env 文件分离和 secret manager 屏蔽生产凭据;命令审核在支持"Approval Mode"的工具(如 Claude Code 的 --permission-mode 参数)中可以配置为每次执行前强制等待确认;测试验证则依赖项目本身的测试覆盖率——覆盖率越高,AI 的每一步改动越容易被自动检测到回归;可回滚的前提是操作幂等或有事务保障,数据库变更应优先使用迁移脚本而非直接 SQL,文件变更应纳入版本控制。将这些工程实践与 AI 工具结合,才能让自动化真正可控。
相关推荐

Harness架构实战:企业级智能体项目拆解与AI岗位进阶指南
深度拆解基于Harness(驾驭工程)架构的企业级智能体实战项目,涵盖多模型配置、ASGI部署、MCP协议对接ERP系统、Sandbox沙箱隔离等核心模块,帮助AI大模型求职者理解工程化落地方向的面试要点。

fal.ai API密钥配置与n8n集成完整教程
手把手教你创建 fal.ai API 密钥并连接到 n8n:涵盖官方集成节点配置、凭证保存、HTTP 请求替代方案以及密钥安全注意事项,快速跑通首次 AI 媒体生成工作流。

系统设计面试笔记开源项目:2.4万星的学习利器
开源项目 liquidslr/system-design-notes 整理了经典书籍《System Design Interview》的学习笔记,GitHub 收获 2.4 万 Star。本文解析其内容价值、适用人群及系统设计面试复习建议。