AI测试已过时?2026年转向AI评估与AI主导测试

AI测试正从“用AI测试”转向“对AI测试”,需以评估替代断言,并分层评估大模型、知识库和智能体。
文章指出,AI在软件测试领域的落地已从“用AI辅助测试”推进到“AI主导测试”,并形成用AI测试、和AI测试、对AI测试三层递进体系。由于大模型输出具有概率性,传统断言失效,需改用评分制评估,同时保留测试划定及格线。AI评估需固定被测版本和评估版本两个版本,确保单变量对比。评估对象分为大模型、知识库(RAG)和智能体三层,复杂度递进。工具方面推荐Promptfoo,因其支持CLI、配置文件驱动、可被AI调用且被OpenAI收购。最后强调测试从业者需完成从断言到评分、从单版本到双版本、从功能测试到分层评估的三个观念转变。
过去半年,AI在软件测试领域的落地速度远超预期。半年前大家还在聊“用AI辅助测试提效”,如今国内几家头部大厂——腾讯、阿里、字节,以及从模型研究走向工程化的DeepSeek——已经把话题推进到了“AI主导测试”。测试从业者面临的不是工具升级,而是整个方法论的重构。
从“用AI测试”到“对AI测试”:三层体系已清晰
据B站UP主在课程中的梳理,AI时代的测试体系可以拆成三层:用AI测试、和AI测试、对AI测试。
- 用AI测试:借助AI辅助人工完成测试任务,提升效率。这在半年前是热门话题,但现在已被视为“过去式”。
- 和AI测试:人和AI各司其职,大部分测试工作——需求分析、用例设计、系统探索、代码编写、自动化回归——可以交给AI。这就是“AI主导测试”。
- 对AI测试:当越来越多的软件内部集成了AI能力(AI客服、AI占卜、AI视频生成等),这些AI应用本身也需要被测试,而且测试思路与传统软件完全不同。
UP主指出,前两层已经被国内AI领先公司翻篇,第三层“对AI测试”正成为新的焦点。这三层不是三选一的路口,而是递进关系:先掌握对大模型的评估,再到知识库,最后到智能体。
为什么是“评估”而不是“断言”?
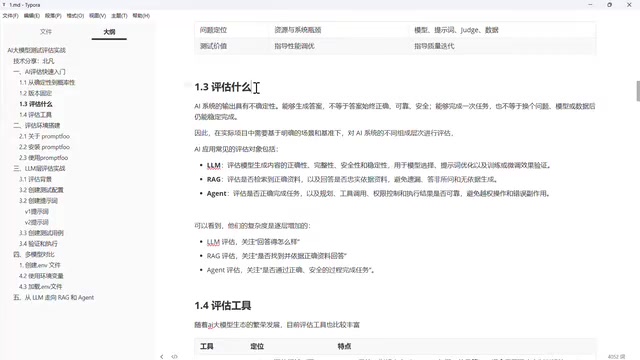
传统软件测试依赖断言:通过或失败,没有第三种结果。但AI大模型的输出天然带有概率性。UP主从两个角度解释了原因:
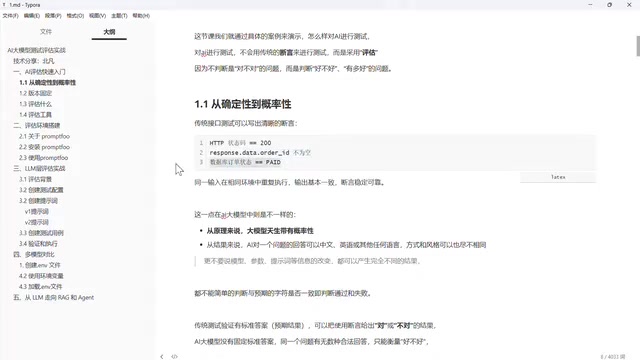
- 原理层面:主流大模型多采用Transformer架构,输出时存在概率选择,天生就不确定。
- 结果层面:即便结果确定(比如输出数字2),表现形式也多种多样——中文大写、英文、阿拉伯数字、不同进制、不同风格,很难用相等断言覆盖。
因此,AI测试不能简单判断对错,而要判断“好不好、有多好、有多不好”。这就是评估——用打分的方式表达能力。UP主类比高考:最公平的选拔通过分数体现,复杂领域如智商、肿瘤、抑郁症的判定也普遍采用评分。评估并非完全取代测试,测试环节依然存在,相当于为分数划定及格线,给出“能否上线”的明确结论。分数可以是0到1的连续值,也可以用0和1表示通过与否。
Transformer 架构与输出概率性
Transformer 是当前主流大语言模型(如 GPT、LLaMA、DeepSeek广告 等)的基础架构,其核心是自注意力机制(Self-Attention),能够并行处理输入序列并捕捉长距离依赖。在生成文本时,模型通常采用自回归方式,即根据上文逐个预测下一个词的概率分布,再通过采样策略(如贪心搜索、束搜索、温度采样、Top-p 采样等)选择具体输出。这种概率性选择导致相同输入可能产生不同输出,即使模型参数和输入完全固定,输出也可能因随机种子或采样策略而变化。此外,模型对同一语义可能有多种表达方式(如“2”、“二”、“two”、“0b10”),使得基于精确匹配的断言难以覆盖所有情况。因此,AI 测试需要从“对错判断”转向“质量评估”,通过打分或分级来量化输出的优劣。
版本固定:AI评估的特殊要求
传统测试只需固定被测系统的版本号,但AI评估要固定两个版本:
- 被测版本:使用了什么模型、传了什么参数、用了什么提示词、加了什么上下文,任何一项变化都意味着版本变化。
- 评估版本:用了什么数据集、什么断言、什么阈值,同样需要固定。
UP主强调,只替换其中一个版本可以做横向对比(比如同评估手段换不同模型,对比模型质量);两个版本同时变化,结果就没有对比价值,需要重新解读。
评估对象分三层:大模型、知识库、智能体
AI评估首先要明确评估对象,不同对象目的和指标不同:
- 大语言模型(LLM):评估生成正确性、完整性、安全性和稳定性。用途包括模型选型(哪个更聪明更快)、提示词优化、小模型微调后的效果验证。
- 知识库(RAG):先检索正确资料再生成回答,需评估检索准确性、召回率、生成结果对参考资料的忠实度(中程度)。
- 智能体(Agent):涉及任务规划、工具使用、任务推进,复杂度最高。智能体内部往往包含大模型和知识库,因此评估是递进式的。
UP主建议的学习路线是:大模型→知识库→智能体,由简到繁。
RAG(检索增强生成)与评估要点
RAG(Retrieval-Augmented Generation)是一种将外部知识库检索与大模型生成相结合的技术范式。其流程通常包括:用户提问 → 检索器从知识库中召回相关文档片段 → 生成器基于召回内容合成答案。RAG 能缓解大模型幻觉问题,并支持私有知识更新。评估 RAG 系统需关注三个维度:检索质量(如召回率、准确率、MRR)、生成质量(如答案与问题的相关性、信息完整性)以及忠实度(生成内容是否忠实于检索到的参考资料,避免模型自行编造)。常用工具包括 RAGAS、TruLens 等,它们提供自动化指标(如 faithfulness、answer relevancy、context precision)来量化这些维度。对于测试从业者,理解 RAG 的评估要点有助于设计针对知识库应用的测试方案。
工具选型:为什么推荐 Promptfoo
课程中列举了多款AI评估工具,重点推荐了 Promptfoo。理由有几点:
- 支持命令行和配置文件驱动,这意味着AI可以自己调用它——UP主称之为“AI评估AI”的潜力场景。
- 人工评估仍是当前金标准,Promptfoo支持用配置文件写用例断言,降低门槛。
- 支持批量调用、Python自定义扩展,扩展性强。
- 已被OpenAI收购,侧面印证其工具价值。
UP主也提到RAGAS等工具在知识库评估上的优势,但认为对大多数测试同学而言,Promptfoo更适合验收场景。技术选型没有唯一答案,可根据公司实际需求灵活选择。
Promptfoo 的核心能力与使用模式
Promptfoo 是一款开源的 LLM 评估工具,支持通过 YAML 配置文件定义测试用例、断言和评估指标。其核心能力包括:批量调用不同模型或提示词版本、内置多种断言类型(如包含、正则、相似度、模型评分)、支持自定义 Python 断言函数、生成可视化报告。它可以通过命令行(CLI)直接运行,便于集成到 CI/CD 流程中,也支持编程调用,为“AI 评估 AI”提供了基础。Promptfoo 被 OpenAI 收购后,其生态和稳定性得到进一步增强。对于测试团队,Promptfoo 降低了评估门槛,尤其适合在模型选型、提示词迭代和回归测试等场景中快速搭建评估流水线。
给测试从业者的启示
UP主反复强调,理论方向比实操细节更重要——实操看一眼就会,但方向错了工具再好也没用。对于测试同学,需要完成三个观念转变:
- 从断言思维转向评分思维;
- 从单一版本管理转向双版本固定;
- 从功能测试视角转向分层评估视角。
行业在变,学习不能停。UP主自己从Python项目转向JS,就是例证。AI评估不是未来时,而是现在进行时。
相关推荐

大模型应用开发:普通人的高薪入行指南
大模型应用开发岗位应届生薪资高达3万5,SP Offer可达60万,且不看出身。本文解析这一高薪岗位的核心能力、入行方法,并分享普通人如何通过“干中学”抓住AI时代机遇。

告别AI网红脸:零基础漫剧视觉资产制作全攻略
B站UP主分享零基础AI漫剧视觉资产制作全流程:用豆包工作skill通过剧本先行、视觉参考、注入活人感三种方法摆脱AI网红脸,再用资产版排版、武器细节图、场景九宫格和电影色版锁定角色与场景一致性。

好视频背后的AI制作流程:从调研到智能体验证
AI视频制作不只是模型竞赛。本文拆解一套可迁移的四步流水线:调研专业流程、整理技能清单、配置智能体、实验验证,并说明如何用DeepSeek等通用大模型替代付费工具跑通全流程。